我们将 Cerebras 晶圆级引擎与 GPU 结合部署,以大规模提供极速 token
世界对极速 token 的需求正日益旺盛。2026 年,Cerebras 发现无论是在我们的推理云上,还是通过合作伙伴,市场对快速推理的需求都极为强劲。为满足这一需求,我们开始研发分离式推理:由 GPU 负责提示词处理(prefill),由 Cerebras 系统负责输出生成(decode)。
该方案现已投入生产,在保持 Cerebras 一贯超高速度的同时,每兆瓦可多产出五倍的 token。
现在,我们可以通过 Cerebras Inference Cloud 提供更多极速 token,以满足市场需求。基础设施合作伙伴也可以利用 Cerebras 的分离式方案,在自己的数据中心内实现更多极速 token 的交付。
结合我们近期发布的 CS-4、大幅扩张的制造产能,以及规划中的 700MW 数据中心容量,分离式推理将助力 Cerebras 及合作伙伴在 2027 年及以后交付海量极速 token。本文将介绍:
- 为什么需要更多极速推理算力
- 为什么 Cerebras 在 decode 阶段更具优势
- Cerebras 分离式推理的生产环境成果
- 面向基础设施合作伙伴的 Cerebras 分离式推理方案
为什么需要更多快速推理算力
像 Muse、Copilot 和 Codex 这样的 Agent 应用正在快速扩展,它们需要高度交互式的推理来维持用户参与度。为了在电力受限的环境下满足这些应用不断增长的需求,整个行业必须在保证响应速度足以让应用真正可用的前提下,大幅提升每兆瓦所能提供的推理算力。

来源:Goldman Sachs Research,《AI Agents Forecast to Boost Tech Cash Flow as Usage Soars》,2026 年 5 月 20 日;Goldman Sachs 数据中心容量估算,引自 Investing.com
这正是 Cerebras 投资分离式架构的原因。将用于提示词处理的 prefill 加速器与负责响应生成的 Cerebras 系统搭配使用,可以在保持 Cerebras 超快生成速度的同时,提高每兆瓦的 token 吞吐量。对于推理服务提供商而言,这意味着在相同的电力预算下,能够服务更多客户并创造更大的营收潜力。
为什么 Cerebras 在 decode 阶段更具优势
一次推理请求主要包含两个阶段。提示词处理(即 prefill)负责处理输入并生成中间模型状态;响应生成(即 decode)则利用该状态生成输出 token。拆分推理工作负载的方式有很多,例如 draft–target、attention–FFN 等,但当目标是实现高度交互式推理时,将 prefill 与 decode 分离具有独特优势。

Decode 是自回归的。也就是说,模型每次只生成一个 token,并将每个已生成的 token 作为输入来生成下一个 token。每一步都需要重新从内存中读取模型数据,因此内存带宽至关重要。在极速推理领域,以 SRAM 为核心的芯片具备天然优势,因为它们可以将数据保留在芯片上并以更快的速度读取。Cerebras 将这一优势做到了晶圆级规模:单颗芯片上集成了数十 GB 的 SRAM 和每秒数 PB 的内存带宽——分别是典型 GB300 GPU 的 350 倍和 5,400 倍。这使得 Cerebras 系统能够将更多并发请求和模型层直接放在芯片上处理,从而让 CS-3、CS-4 和 CS-5 在极具吸引力的吞吐量下实现极速性能。
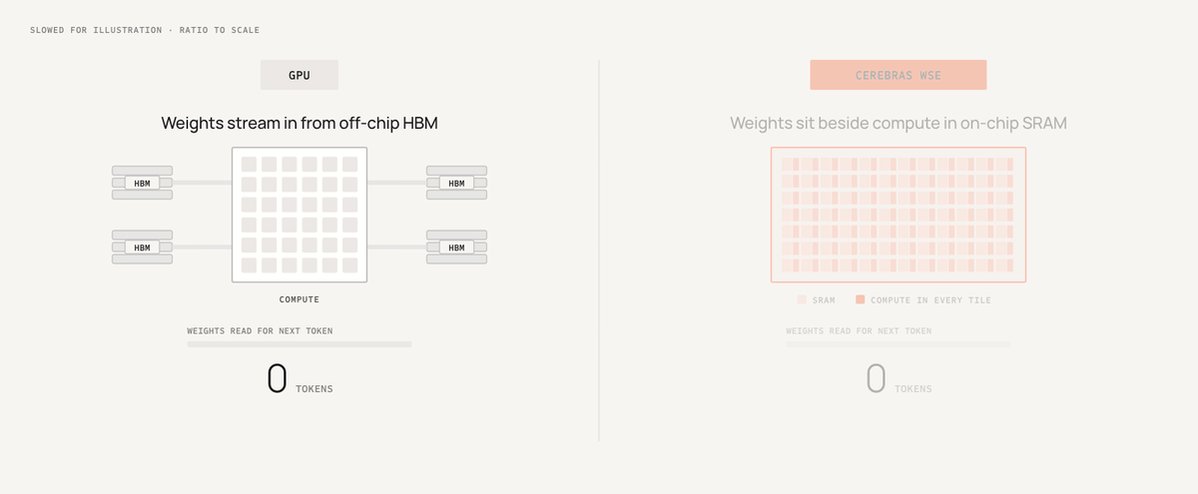
GIF
Cerebras 分离式推理的生产环境成果
将专为极速 decode 优化的 Cerebras 系统与擅长满足 prefill 计算需求的加速器(如 AMD Instinct GPU)相结合,可以大规模交付海量极速推理能力。在 Cerebras Inference Cloud 的一次生产部署中,AMD Instinct GPU 负责处理提示词,Cerebras CS-3 系统负责生成响应。将提示词处理交给 GPU 后,Cerebras 系统可以把全部服务能力集中用于响应生成。在我们实测的生产部署中,这种组合实现了纯 CS-3 配置每兆瓦吞吐量的 5 倍,且 token 生成速度没有任何损失。

来源:11 月 14 日通过 Cerebras Inference Cloud 共享的 GPT-OSS-120B 端点,启用分离式推理前后每兆瓦吞吐量对比,以聚合推理基线(1×)为基准进行归一化。
我们计划在 2027 年底前,在 Cerebras Inference Cloud 及合作伙伴的部署中,将分离式推理广泛推广至数百兆瓦的规模。我们的目标是为可用客户提供更多极速推理算力。
面向基础设施合作伙伴的 Cerebras 分离式推理方案
Cerebras 分离式推理方案同样是为方便合作伙伴采用而设计的。基础设施合作伙伴可以基于 Cerebras 提供的参考架构部署分离式推理集群,将他们选定的 prefill 加速器与 Cerebras 系统置于同一网络中。在软件集成方面,合作伙伴既可以选择接入 Cerebras 端到端分离式软件栈,也可以使用仅含 decode 功能的 SDK。
- 端到端分离式软件栈最适合希望缩短上市时间的合作伙伴。它包括:
- 一个分离式推理框架,用于在 prefill 池和 decode 池之间路由请求,并管理副本容量与健康状态。
- 一个 prefill 引擎,可使用 vLLM 或 SGLang 等开源推理引擎处理提示词。
- 一个 Cerebras decode 引擎,用于在 Cerebras 系统上生成响应。
- KV Portal 软件,这是一个接口,可通过 RDMA 在 prefill 引擎和 decode 引擎之间传输中间模型状态(包括键值缓存)。
仅含 decode 功能的 SDK 最适合追求更高控制力的合作伙伴。借助该 SDK,合作伙伴可以将自己的推理框架和 prefill 引擎与 Cerebras decode 引擎及 KV Portal 软件对接。此外,该 SDK 还提供多种开发辅助工具,例如模拟的 Cerebras decode 副本,以及与开源分离式推理框架和 prefill 引擎的参考集成。

包括 Amazon Web Services、Fireworks AI、Gimlet Labs 和 General Compute 在内的早期体验合作伙伴,已经可以在其部署中使用 Cerebras 分离式方案。目前,我们正在向更多希望为客户大规模提供极速推理能力的合作伙伴开放访问权限。
如需更详细地了解相关成果、解决方案或部署机会,请在此处联系我们。


