知识模型可视化
知识模型可视化
展示内容
描述
将知识框架/理论模型转化为高质量可视化图片。用户输入模型名称、结构类型和中文标签,Skill 自动识别图表类型、构建专业提示词并直接生成模型卡图片,解决知识博主在中文字符渲染和知识密度表达上的痛点。
相关技能
查看全部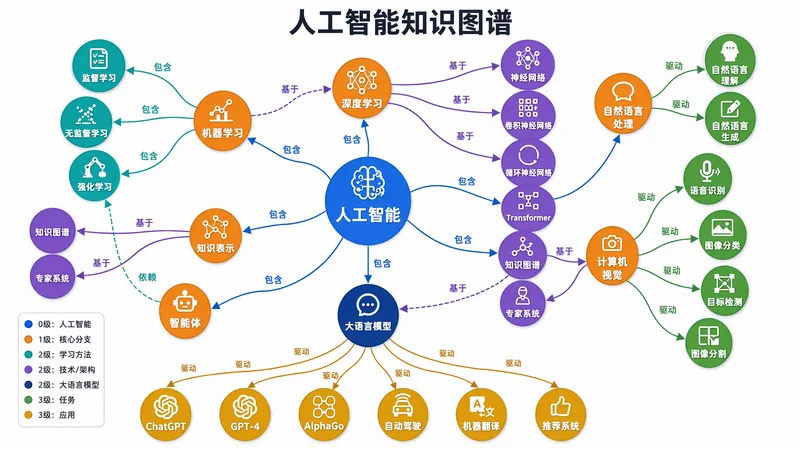
知识图谱引擎
从文本、文件或主题自动构建五类图谱(知识图谱、思维导图、概念图、流程图/架构图、关系图),以最高标准输出交互式网页、静态图片与可视化代码的三合一方案。融合知识图谱工程与信息可视化最佳实践,支持粒度动态控制、消歧去重、多源交叉验证。 把你的文字、文件甚至一个念头,秒变可拖拽、可缩放、可搜索的交互式知识图谱,并一键导出高清图片与即用代码——这是你从未体验过的知识可视化“三合一”引擎。 🧠 什么是「知识图谱引擎」? 它不是你见过的那种简单画图工具,而是一位藏在浏览器里的知识工程师+可视化专家。给它一段教材、一篇论文、一份PDF,或者只给一个关键词,它就能自动: 🔍 抽取核心实体,理清深层关系 🧱 构建结构化图谱JSON(知识图谱/思维导图/概念图/流程图/关系图) 🎨 输出三种顶尖形态:可交互网页 + 高清静态图 + Markdown/Mermaid/Graphviz代码 从此,信息整理不再靠手动画框,知识呈现不再只是一张死图。 ⚡ 为什么说它是“顶尖”的? 1. 全自动「从文本到图谱」流水线 不用学任何建模语言,不用手动定义节点和连线。你只需输入内容,引擎会自动判定图谱类型: 学科知识体系?→ 生成语义丰富的知识图谱 读书笔记拆解?→ 生成层级清晰的思维导图 流程与决策?→ 生成带分支的流程图/架构图 人物关系网?→ 生成多维关系图 哪怕你只扔一个主题词,它也能自主搜集资料,补全内容后再出图。 2. 三合一输出,覆盖全部使用场景 🖱️ 交互式D3.js网页:拖拽节点、滚轮缩放、点击弹出详情、高亮关联路径、关键词搜索……像操作一张活的地图。单文件HTML,无后端,可以直接嵌入任何页面或发给任何人。 🖼️ 高清静态图谱:力导向布局,色彩分类,直接用于论文配图、PPT汇报、教学材料,清晰到每个标签都锐利可读。 📜 可视化代码:同时生成Mermaid与Graphviz源码,开发者可直接放入文档、wiki、Notion,二次编辑无限扩展。 3. 极致用户体验设计 🎨 颜色按实体类型自动映射,层级用节点大小直观表达 🔗 关系标签直接显示在曲线上,一眼看懂“包含”“导致”“支撑” 💡 点击任意节点,非关联部分自动淡出,聚焦思维路径 🔄 重置布局、搜索定位、缩放平移……所有操作丝般顺滑 4. 兼顾“广度”与“深度”的工程智慧 从实体消歧去重,到多源交叉验证;从层级粒度控制,到支持跨域关联的虚线连接——这背后是知识图谱工程的最佳实践,不是玩具,是生产力工具。 👥 谁最需要它? 教师 & 教育内容创作者 把整本教材章节变成一张可交互知识地图,学生一点即懂概念关联。 研究人员 & 学生 论文文献综述不再只靠文字堆砌,一张图理清数十篇论文的理论脉络。 产品经理 & 企业架构师 系统架构、业务流程、功能拆解,即时生成架构图,沟通效率翻倍。 读书人 & 终身学习者 笔记不再只是大纲,而是可探索的思维网络,让知识真正“长”在一起。 🚀 现在,让你的知识“活”过来 你给内容,它给洞察。 你给主题,它给体系。 你给需求,它给网页、图片、代码的完整交付物。 这不是一个功能,这是一套将信息升维为认知的工作流。 让「知识图谱引擎」成为你思考的延伸,视觉化你的专业,触达每一个受众的“aha moment”。 —— 从今天起,不再“画”图谱,而是“生”图谱。
科研教改图·课程建设图·自媒体图生成器
科研教改图·课程建设图·自媒体图生成器是一套面向科研教改图表、自媒体视觉和课程建设图的绘图 Skill。它会先判断图型,从适配的结构或风格库中提供选择,再提交完整设计方案;只有获得用户明确批准后才生成,并在交付前检查内容、关系、中文、构图、人物和视觉质量。 科研教改图·课程建设图·自媒体图生成器可以把研究材料、课程内容和自媒体主题转化为清晰、有质感、符合个人审美的视觉方案。它支持技术路线图、理论机制图、研究框架图、课程体系图、岗位—能力—课程映射图、公众号头图、知识信息图、场景插画和多页图文卡等类型。 Skill 会先完成“主题—节点—关系—层级—容量—载体”的内容转译,再推荐 3–5 个适配结构或风格,并展示构图、配色、材质、光影、文字处理、绘制方式和风险。未经用户批准不会直接生图;用户修改内容、结构、风格、配色或尺寸后,会更新方案并重新等待批准。 科研与课程图优先采用可编辑、关系准确的确定性绘制;自媒体和场景图采用无字生图与可靠叠字。
九维全域视觉解构引擎
将单张或多张信息图、数据可视化、流程图、时间轴、地图、知识图谱与组织架构图,拆解为可复用的视觉与信息结构,帮助你准确理解一张图为什么这样组织,并重建相近的表达效果。技能会从空间构图、维度与材质、色彩层级、字体排版、模块关系等表现因素入手,同时识别图表编码、阅读路径、图符隐喻以及地理或网络关系,让分析不止停留在“风格像什么”。 你将获得一份参数化的视觉解构结果,涵盖画布与构图逻辑、视觉层级、文字密度、模块拓扑、数据与关系的表达方式,以及图像中的叙事动线。对于统计图表、地图或关系网络等内容,输出会聚焦其数据如何映射为颜色、位置、大小、连线和节点等视觉变量;对于复杂专题图,则进一步梳理图形、文字与隐喻系统之间的协同关系。 基于这些分析,技能会生成详尽、结构清晰的英文图像生成提示词,适合用于信息图复刻、视觉研究、设计参考、品牌内容探索和概念图制作。无论你提供的是现有图片,还是对主题与视觉方向的构想,都能得到更接近结构级复现的提示词,而不是泛泛的风格描述。
信息
- 版本
- v2
- 更新时间
- 运行积分
- 按实际用量
- 模型
- GPT Image 2