拆解视频并生成提示词
拆解视频并生成提示词
展示内容
描述
根据视频、文字剧本或对标素材,生成可执行的视频提示词、分镜及节奏分析;依据实际素材读取能力与最新模型限制灵活调整。
推荐自
Dancang
为什么我们推荐这个技能
将视频观察、剧本分镜与节奏分析融为一体,既能逐镜提炼可验证的画面信息,也能生成适配模型的可执行提示词。它尤其强调区分事实与推测、诚实标注素材局限,并兼顾镜间连续性与创作版权边界。
适合人群
适合需要拆解视频参考、规划分镜或优化 AI 视频提示词的导演、编剧和内容创作者。
如何使用此 Skill
提供输入
提供视频、图片、文字剧本、已有分析或对标素材,并说明目标平台、视频模型、时长和创作要求。
运行 Skill
选择视频反推、剧本拆解、节奏分析或结果优化;工具会区分可观察事实、推测与创作建议,并按素材可读范围进行分析。
查看结果
获得可执行的视频生成提示词、分镜方案或节奏分析,包含镜头结构、动作、运镜、连续性及必要的限制说明。
相关技能
查看全部
MiniMax H3多模态视频反推提示词助手(含源提示词)
将完整参考视频交给多模态 AI,自动拆解真实镜头、时间线、画面变化与可听声音,并生成可直接用于视频创作的生产级提示词。它不局限于真人、广告或电影素材,也适用于产品展示、建筑风景、动物、美食、体育动作、舞蹈、2D/3D 动画、UI 演示、屏幕录制、信息图、视觉特效和抽象影像等多种题材。 根据视频的信息结构,助手可输出完整的文生视频提示词,或按每个 Shot 生成图生视频所需的参考图/首帧提示词、连续运动描述、必要的尾帧提示词与镜头级稳定约束;当静态画面和时间变化都很重要时,也能同时提供两种版本。生成内容会保留主体、构图、摄影机运动、动作因果、结构变化、文字、对白、环境声与音乐等实际可确认的信息,并追踪每个镜头直到真实结束状态。 对于无法清晰确认的文字、声音、身份、地点或拍摄方式,助手会避免擅自补全;同时区分目标画面与播放器水印、控制层等外部元素,减少生成时的内容漂移。适合需要从参考视频反推文生视频提示词、I2V 镜头提示词,或为视频重建、风格复现和生成式广告制作整理素材的创作者与制作团队。
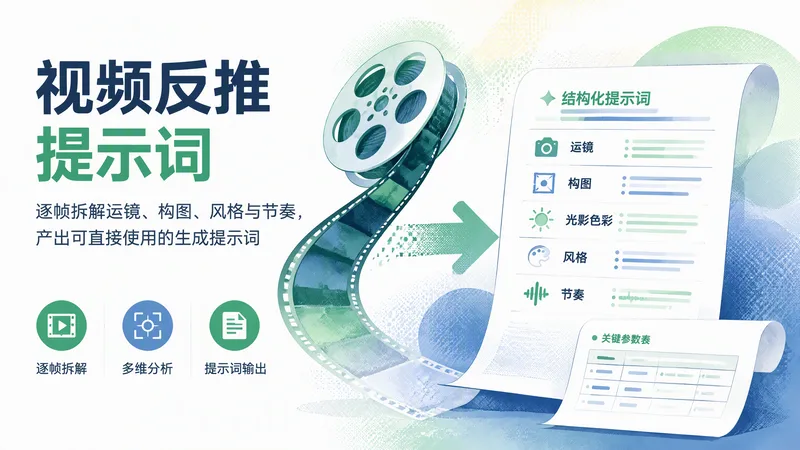
视频反推提示词
输入一条短视频链接或直接上传视频文件,逐帧读取画面并按镜头切分,从运镜、构图、光影色彩、风格与节奏四个维度完成拆解,再翻译成一条可直接粘贴使用的中文结构化提示词,同时给出关键参数表、拆解依据和可微调的替换项,并存档为文档。
 写作
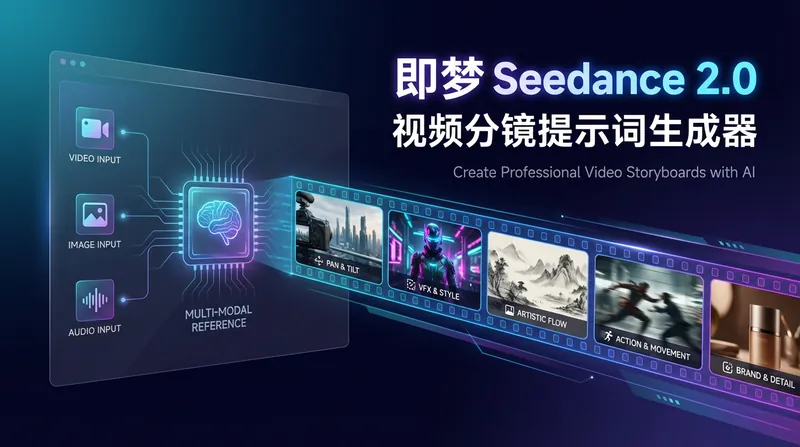
Seedance2.0视频分镜提示词生成器(根据官方手册定制)
name: jimeng-seedance-video description: 即梦 Seedance 2.0 视频分镜提示词生成器。根据用户需求生成符合即梦视频生成要求的分镜提示词,支持多模态输入(图片、视频、音频)、运镜设计、风格控制、特效复刻等。当用户需要"即梦视频"、"视频分镜"、"分镜提示词"、"生成视频脚本"、"视频创作"、"Seedance"或类似需求时触发。支持问答式交互,通过了解视频类型、时长、风格偏好、参考素材等信息,生成专业的视频分镜提示词。
信息
- 版本
- v2
- 更新时间
- 运行积分
- 按实际用量
- 模型
- 自动选择
- 使用场景
- 图片与设计视频与音频调研与分析
- 你将获得
- 报告图解提示词
