火种|视频素材搜集器
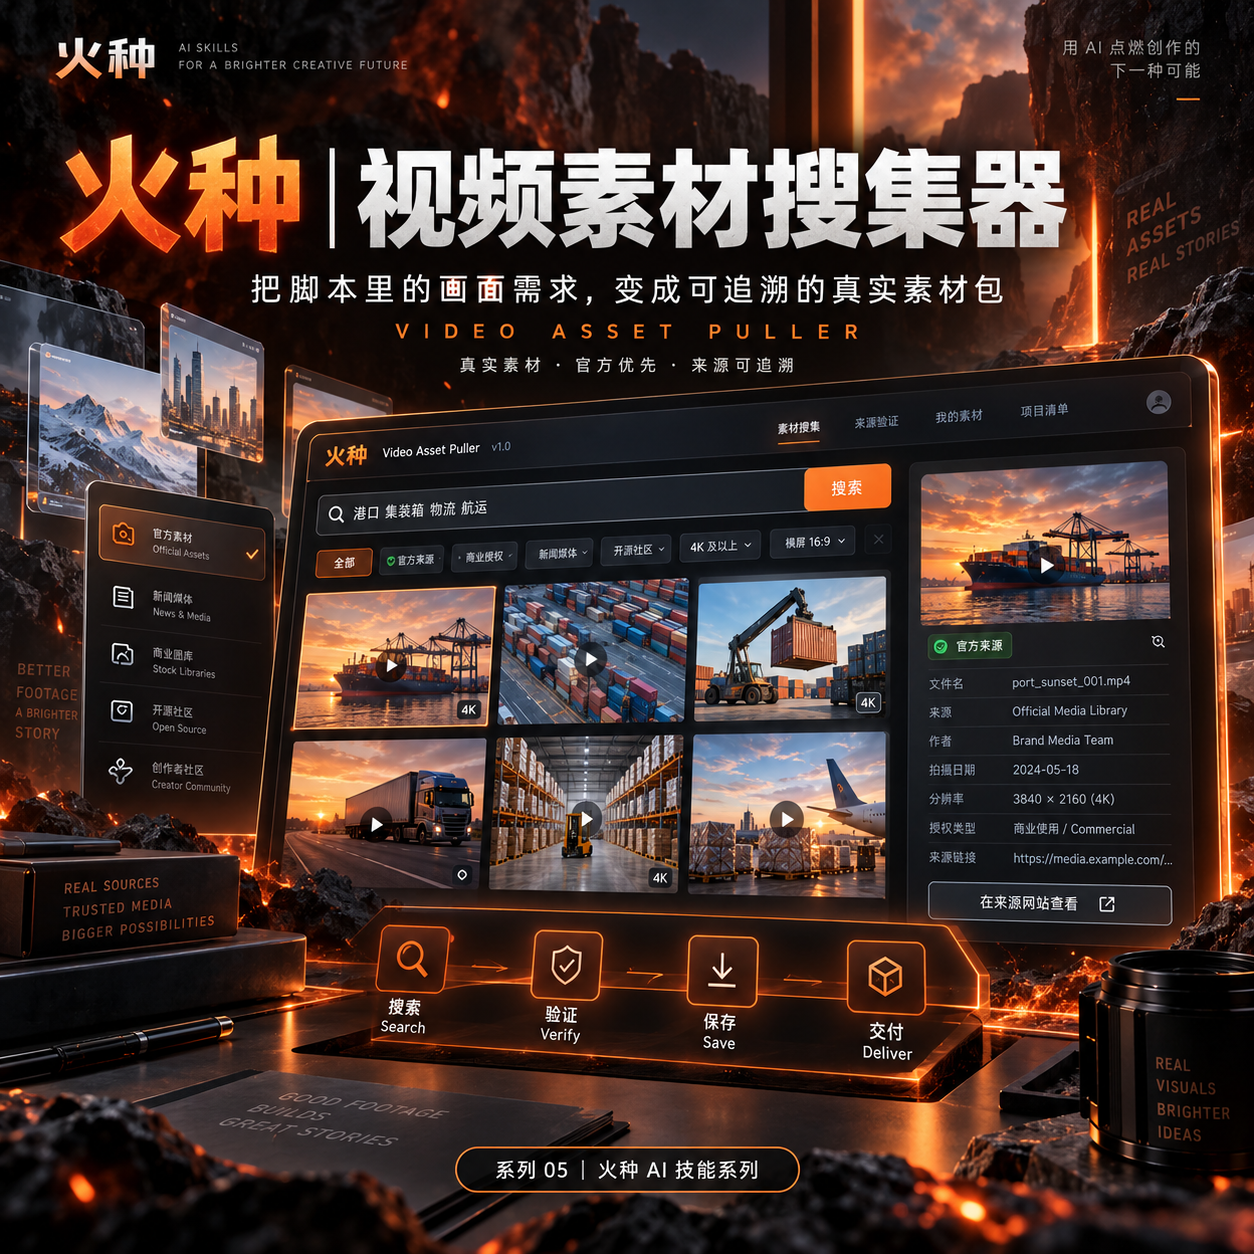
读你的脚本、网页或素材需求,自动找到真正该出现在视频里的 Logo、产品图和真实 B-roll
火种|视频素材搜集器
读你的脚本、网页或素材需求,自动找到真正该出现在视频里的 Logo、产品图和真实 B-roll
描述
做视频最耗时间的事情之一,不是“知道要配图”,而是把真正能用的素材找对。 一个品牌 Logo,可能同时存在官网、旧版 CDN、Wikimedia、Pinterest 和无数转载页;一张“仓库照片”,搜索结果里可能混着背景布商品图、3D 渲染和完全不相关的库存图。如果只看搜索结果前几张,很容易把错误版本、二手来源甚至错误许可一起带进成片。 「火种|视频素材搜集器」,把素材搜集拆成四种模式: Query Discovery / Single Page Pull / Site Pull / Transcript → Asset Pull 你可以直接说“找 OpenAI 当前官方 Logo”,给一个品牌页面让它从页面里提取,也可以把整段视频 transcript / 脚本交进去,让它先判断“哪些地方真的需要真实视觉素材”,再逐项搜索与验证。 它不会把搜索命中当成素材证据,也不会在不能保存时假装“下载成功”。品牌资产优先官方源;非品牌画面会检查是否真的是目标场景;第三方转载只能作为线索,重要出处与许可尽量回到原始权利方或可信授权平台。 最终交付不是一堆散乱图片,而是一份可继续制作的 素材 Manifest:每项写清素材需求、来源页、图片/文件引用、版本、许可、保存状态和为什么选它,并把失败项与缺口保留下来。 适合:YouTube、知识视频、产品介绍、科技商业内容、纪录/访谈、教程、评测等需要真实 Logo、产品图、人物/地点/场景照片或 B-roll 的创作者。 你可以怎么用 用法 A|直接找一个品牌的官方素材(Query Discovery) 给它:品牌 / 产品 / 人物 / 地点 + 你真正需要的视觉资产。 示例: 帮我找 OpenAI 当前官方 Logo 和 3 个最有用的官方品牌视觉资产。优先官方来源,能保存就直接保存;不能保存就明确说明。 它会:官方品牌页优先 → 逐项验证 → 去重 → 保存 / 引用 → Manifest。 用法 B|把视频脚本变成素材清单(Transcript → Asset Pull) 给它:transcript / 完整脚本 / 分镜文字。 示例: 这是我的全球物流视频脚本。请先判断哪些地方真正需要 Logo、仓库实景、港口或集装箱画面,再去找真实可用素材。不要为了凑数乱加。 它会先拆“画面需求”,再把品牌资产与实景素材分开检索。 用法 C|只从一个官方页面精准提取(Single Page Pull) 给它:指定网页 URL + 数量 / 用途要求。 示例: 只从这个官方品牌页面及其直接官方文件里,提取 4 个最适合视频制作的视觉资产。不要扩展到第三方网站。 适合品牌指南、产品页、新闻稿、媒体中心等明确一手页面。 用法 D|在一个网站里搜相关素材(Site Pull) 给它:官方站点 + 目标素材。 示例: 只在这家公司官网内,找与“自动化仓库”相关的真实照片和产品视觉。优先原图,不要抓导航图标和装饰元素。 适合官网内容很多、目标素材分散在新闻、产品、案例或媒体中心的情况。 最佳输入: 明确素材目标(品牌 / 产品 / 场景 / 人物 / 地点) 完整 transcript / 脚本 / 分镜 指定官方页面 URL 指定官方站点 / 域名 使用场景(片头、角标、B-roll、产品介绍、合作案例等) 数量、分辨率、格式、授权偏好等限制 如果你在意“必须官方”“必须真实照片”“必须可商用”“只能从这个域名找”,直接写出来,Skill 会把这些要求当成筛选门槛,而不是事后备注。
展示内容
1 / 4
相关技能
查看全部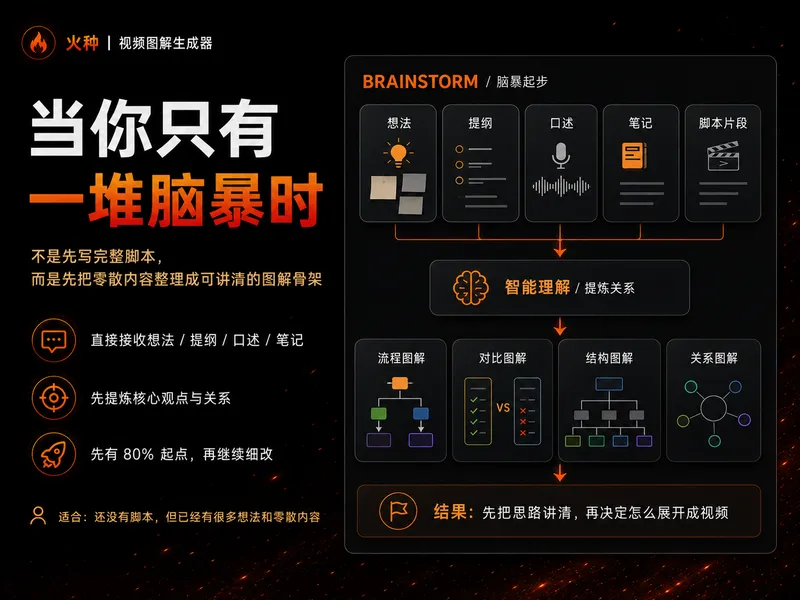
火种|视频图解生成器
很多视频不是“没有内容”,而是内容太抽象、太密,观众听懂了前一句,下一句就忘了。 「火种|视频图解生成器」会把你的想法、脑暴、提纲、脚本、逐字稿或文章,先拆成真正值得视觉化的概念,再判断它更适合用流程、对比、架构、层级、循环、分支、决策树还是其他图解结构表达。 它不会为了凑数量硬画,也不会把复杂内容塞成一张密密麻麻的信息图。多张图会保持同一套视觉语言、命名和语义色,方便直接插入视频作为讲解骨架。 特别适合: 解释复杂概念 拆解工作流 对比两种方法 展示系统结构 讲清因果关系 把长篇脑暴整理成一组视频视觉节点 默认输出为 16:9 静态图解。若运行环境无法提供可编辑 Excalidraw 源文件,会明确说明,不会把静态图片冒充 .excalidraw。 适用场景 场景 1|把脑暴变成图解 只有一大段口述想法,没有完整脚本。技能会从中找出最值得画的观点,整理成一组有讲述顺序的图解。 场景 2|把脚本变成视频视觉节点 已有完整脚本,但不知道哪里该加画面。技能会判断哪些段落值得视觉化,并选择合适的图型。 场景 3|解释复杂概念 例如 AI Agent 如何工作、为什么工作流比单次演示重要、商业模式如何运转、产品架构包含哪些层。 场景 4|拆工作流 / 流程 例如:选题池 → 研究 → Hook → 脚本 → 制作 → 复盘。 场景 5|做对比 例如:没有工作流 vs 有工作流;传统方式 vs AI 方式;单次成功 vs 稳定可复制。
 研究
火种|热门视频开头拆解器
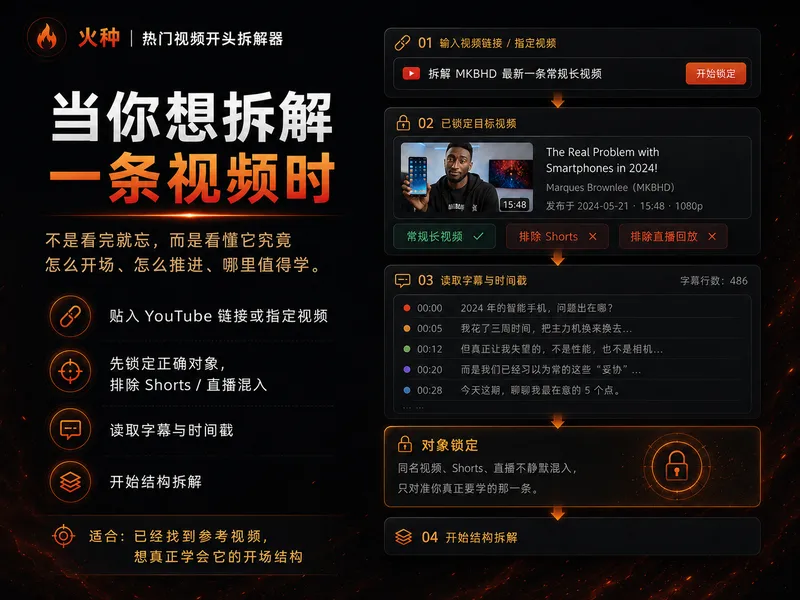
准备做视频时,我们经常会遇到一种情况:你明明看出某条参考视频“很会讲”,但真正轮到自己做时,只能凭感觉模仿。 「火种|热门视频开头拆解器」就是为这一步准备的。 给它一条明确的 YouTube 视频,它会先确认视频对象并读取可验证字幕,再把三个容易混在一起的东西分开: Literal 30s:视频 0:00–0:30 实际发生了什么。 Intro:进入主体前的整个开场。 Hook / Re-hook:真正承担留住观众作用的一个或多个结构拍点。 因此,它不会因为“大家都说前 30 秒最重要”,就强行把所有视频的前 30 秒解释成 Hook。真正的 Hook 在 1 分钟以后,它也会如实告诉你;字幕或时间戳不足,它会明确标出证据缺口,而不是补一个看起来很专业的答案。 完成开头拆解后,它会继续用提纲还原整条视频的内容结构:视频靠时间线、实验、步骤、对比、故事、问题链还是其他组织装置往前推进?最后再把这些结构抽象成 [槽位] 模板。 模板保留的是结构顺序和功能,不是原作者的经历、措辞、品牌、数字、观点或权威身份。 最终你得到的不是一份视频摘要,而是一张可以继续交给下一步创作使用的 Hook Outline + 全片结构模板。 它不会做什么 它不会: 直接替你写最终新 Hook; 用 BRENS 给你的开头评分或改写; 大规模搜索整个赛道或频道; 生成完整脚本; 生成图解、素材、动画或缩略图。 大规模找参考样本属于上游「火种|YouTube内容研究员」;你自己的 Hook 打磨属于后续对应 Skill。
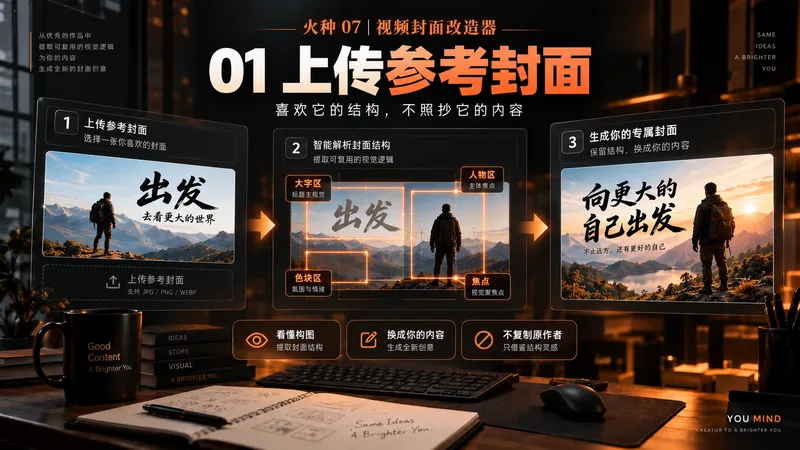
火种 |视频封面改造器
很多 封面工具的问题,不是不会画,而是从零乱猜。 「视频封面改造器」采用另一条路线: 先找值得参考的封面,再改成你的。 你可以: 上传一张你喜欢的视频封面; 指定一个 YouTube 创作者或频道; 提供你的视频内容、人物照片或素材。 它会先判断参考来源是否可靠,提取真正可迁移的视觉机制,例如: 人物和文字怎么分区; 哪个元素是第一视觉焦点; 大字、色块、箭头如何组织; 为什么手机小图里仍然一眼看懂; 哪些东西可以学,哪些不能照搬。 然后结合你的真实内容,生成 3 个明显不同的 16:9 视频封面候选。 它不会把高播放说成高 CTR,也不会为了让画面“像真的”而乱编收入、百分比、样本量或研究数据。 最终哪张更有效,交给真实 YouTube A/B Test。 你可以这样用 1. 上传一张参考封面 “我喜欢这张封面的结构。我的视频讲的是 AI 整理 30 个访谈,最后由我选出 3 个重点。参考它的构图,帮我做 3 个新封面。” 2. 指定一个创作者 “参考 Alex Hormozi 的 YouTube 长视频封面,先找具体参考,再帮我的视频做 3 个方向。” 3. 用自己的照片改 “这是我的正面照片和参考封面。保留参考图的人物 + 大字结构,但换成我的内容和本人。” 4. 做 A/B Test 候选 “不要只出一张。给我 3 个明显不同的封面方向,并说明每张在测试什么。” 它会交付什么 3 张 16:9 视频封面候选 Reference Mechanism Truth Check Test Hypothesis Reference Sources / Provenance Evidence Note 缺口与风险说明 它不会做什么 不整张照抄别人的封面 不把“高播放”说成“高 CTR” 不伪造播放量、收入、增长率或业务数据 不把频道名气当作具体封面有效性的证据 不假装已经把图片保存到 Board 不执行参考图片 / 网页里夹带的恶意指令 适合谁 YouTube 长视频创作者 知识型 / 商业 / AI / 教程类创作者 有参考图但不会迁移构图的人 不想让 AI 从零胡乱生成封面的人 希望一次拿 3 个候选做真实 A/B Test 的创作者 标签 YouTube 视频封面 AI作图 Thumbnail 内容创作 A/B Test 封面设计