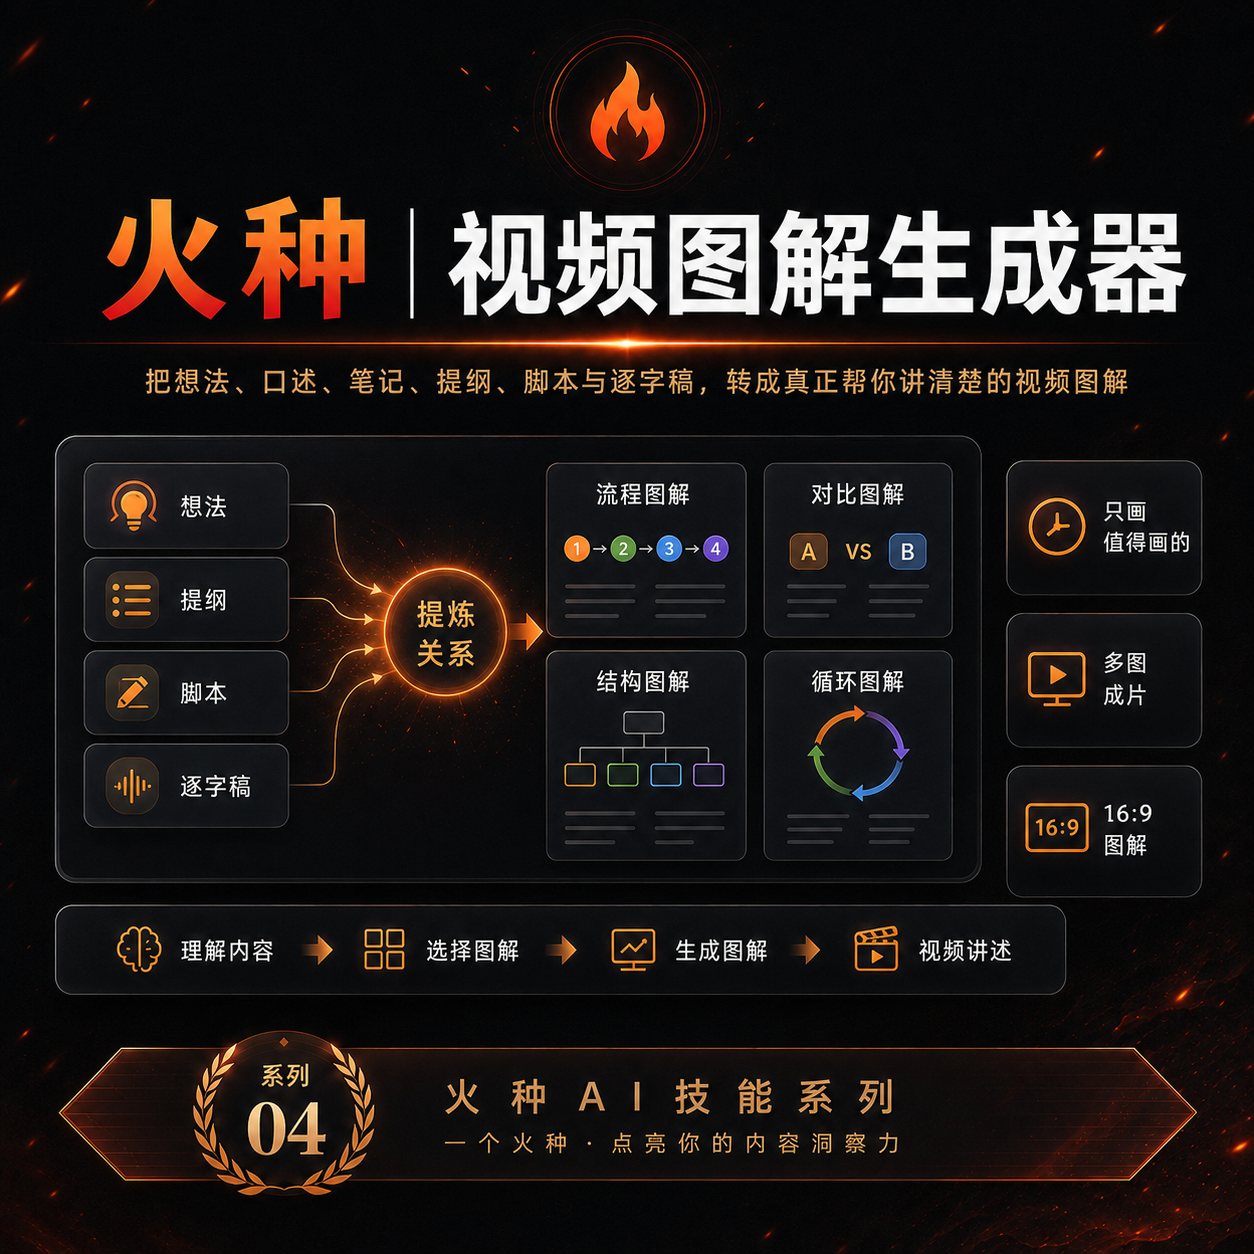
火种|视频图解生成器
把脑子里的内容,变成一眼能讲清楚的视频图解
火种|视频图解生成器
把脑子里的内容,变成一眼能讲清楚的视频图解
展示内容
描述
很多视频不是“没有内容”,而是内容太抽象、太密,观众听懂了前一句,下一句就忘了。 「火种|视频图解生成器」会把你的想法、脑暴、提纲、脚本、逐字稿或文章,先拆成真正值得视觉化的概念,再判断它更适合用流程、对比、架构、层级、循环、分支、决策树还是其他图解结构表达。 它不会为了凑数量硬画,也不会把复杂内容塞成一张密密麻麻的信息图。多张图会保持同一套视觉语言、命名和语义色,方便直接插入视频作为讲解骨架。 特别适合: 解释复杂概念 拆解工作流 对比两种方法 展示系统结构 讲清因果关系 把长篇脑暴整理成一组视频视觉节点 默认输出为 16:9 静态图解。若运行环境无法提供可编辑 Excalidraw 源文件,会明确说明,不会把静态图片冒充 .excalidraw。 适用场景 场景 1|把脑暴变成图解 只有一大段口述想法,没有完整脚本。技能会从中找出最值得画的观点,整理成一组有讲述顺序的图解。 场景 2|把脚本变成视频视觉节点 已有完整脚本,但不知道哪里该加画面。技能会判断哪些段落值得视觉化,并选择合适的图型。 场景 3|解释复杂概念 例如 AI Agent 如何工作、为什么工作流比单次演示重要、商业模式如何运转、产品架构包含哪些层。 场景 4|拆工作流 / 流程 例如:选题池 → 研究 → Hook → 脚本 → 制作 → 复盘。 场景 5|做对比 例如:没有工作流 vs 有工作流;传统方式 vs AI 方式;单次成功 vs 稳定可复制。
为什么我们推荐这个技能
把脚本、提纲和脑暴精准转化为真正帮助讲清楚的流程图、系统图与决策图。它坚持来源可追溯、逻辑优先和视频可读性,不靠装饰凑图,尤其适合快速搭建一套可继续修改的高质量视觉讲解框架。
适合人群
适合需要把抽象想法、复杂概念或视频脚本转成清晰视觉讲解的人。
如何使用此 Skill
提供输入
提供脑暴、提纲、脚本、逐字稿、文章或概念描述,并说明希望解释的主题;也可指定图解数量、比例或视觉风格。
运行 Skill
将内容整理为适合讲解的流程、对比、架构、层级、循环或分支等视觉结构,提炼必要的短标题与标签,并保持多张图的术语和视觉语言一致。
查看结果
获得适合插入视频的16:9静态图解,帮助观众理解关键关系与讲述顺序。若无法提供可编辑源文件,会明确说明。
相关技能
查看全部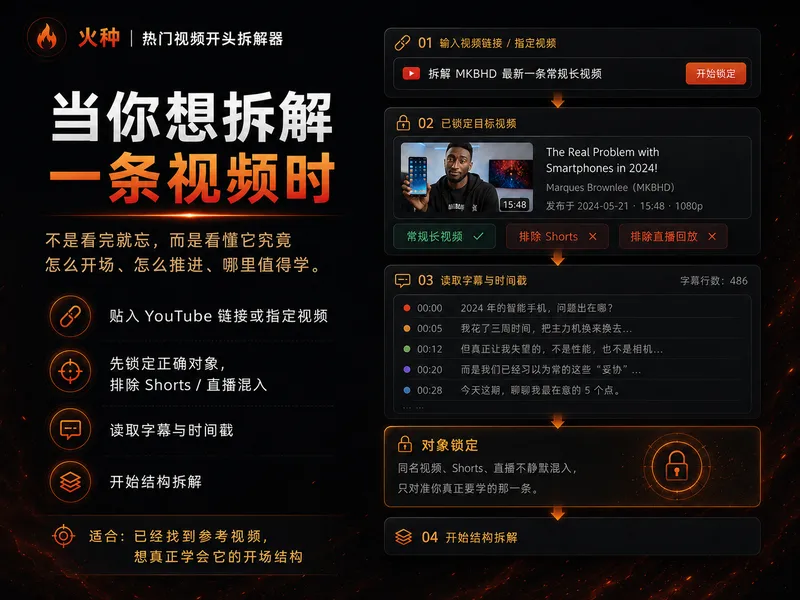 研究
火种|热门视频开头拆解器
准备做视频时,我们经常会遇到一种情况:你明明看出某条参考视频“很会讲”,但真正轮到自己做时,只能凭感觉模仿。 「火种|热门视频开头拆解器」就是为这一步准备的。 给它一条明确的 YouTube 视频,它会先确认视频对象并读取可验证字幕,再把三个容易混在一起的东西分开: Literal 30s:视频 0:00–0:30 实际发生了什么。 Intro:进入主体前的整个开场。 Hook / Re-hook:真正承担留住观众作用的一个或多个结构拍点。 因此,它不会因为“大家都说前 30 秒最重要”,就强行把所有视频的前 30 秒解释成 Hook。真正的 Hook 在 1 分钟以后,它也会如实告诉你;字幕或时间戳不足,它会明确标出证据缺口,而不是补一个看起来很专业的答案。 完成开头拆解后,它会继续用提纲还原整条视频的内容结构:视频靠时间线、实验、步骤、对比、故事、问题链还是其他组织装置往前推进?最后再把这些结构抽象成 [槽位] 模板。 模板保留的是结构顺序和功能,不是原作者的经历、措辞、品牌、数字、观点或权威身份。 最终你得到的不是一份视频摘要,而是一张可以继续交给下一步创作使用的 Hook Outline + 全片结构模板。 它不会做什么 它不会: 直接替你写最终新 Hook; 用 BRENS 给你的开头评分或改写; 大规模搜索整个赛道或频道; 生成完整脚本; 生成图解、素材、动画或缩略图。 大规模找参考样本属于上游「火种|YouTube内容研究员」;你自己的 Hook 打磨属于后续对应 Skill。
想法成图
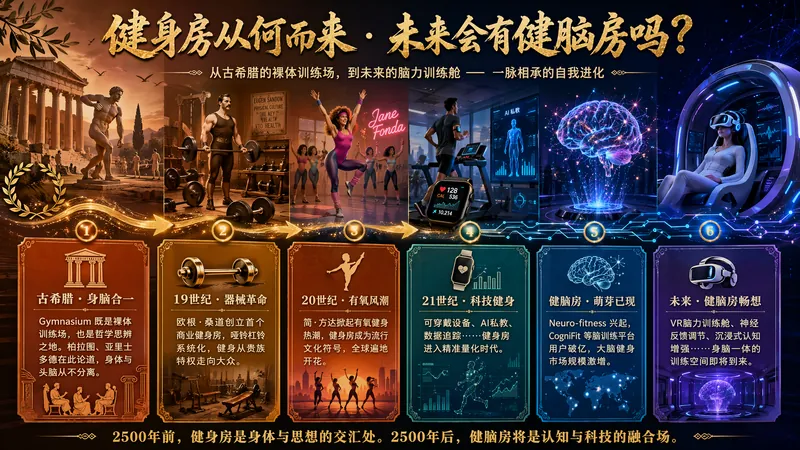
一张图,一句话就够了。 你有没有过这种经历——脑子里有个好想法,想做成一张像大号们发的那种信息长图,结果: 打开 AI 生图工具,提示词写了删、删了写,出来的图要么排版稀烂,要么风格完全不搭 换了好几个提示词模板,每张图都要来回调三四次,半小时过去了还没定稿 想做财商风、国风、科普风、科技风……每次都得重新研究一遍配色和版式 现在不用了。 「想法成图」把这一切全自动化了: 你说「做一张情绪管理的图」,它自己判断该用温暖国风还是治愈科普风,自己搜索整理情绪管理的核心知识点,自己拆成 6-8 个模块卡片,自己组装最优提示词,自己质检——不合格自动重来,合格了直接甩给你。 四种杀手级能力,全部内置: 🧠 风格引擎 —— 不是死板的四选一。你的主题匹配财商就自动上深蓝鎏金,匹配国学就宣纸水墨,匹配科技就青蓝霓虹。遇到四类之外的?自动合成新风格。 咖啡百科→美食暖调,运动健身→活力橙灰,没有它不会的风格。 🔍 内容大脑 —— 你给一个词它就搜全网补全内容,你给一段文字它就提炼核心,你什么都不给只给主题它也帮你梳理得明明白白。三种输入方式全兼容,越简单越省心。 📐 版式智囊 —— 递进阶梯、并列对比、因果链路、总分辐射……五种逻辑自动匹配,不是随便往图里塞文字,是真的在「设计」一张信息图。 ✅ 自检自修 —— 出图后自动查版式、查文字密度、查图文比例、查风格匹配。有问题自动调、自动重出,最多调两次。你不需要会写提示词,你只需要会说话。 这个 Skill 适合谁? 做自媒体的,每天要出图但不想学 设计图制作 做知识付费的,想把课程内容可视化但缺设计师 做企业培训的,需要专业信息图但没预算找外包🔍 任何一个想把想法变成一张好图的人 一句话总结:你有想法,它有图。中间所有麻烦的事,它替你干了。
 视频
火种 |视频封面改造器
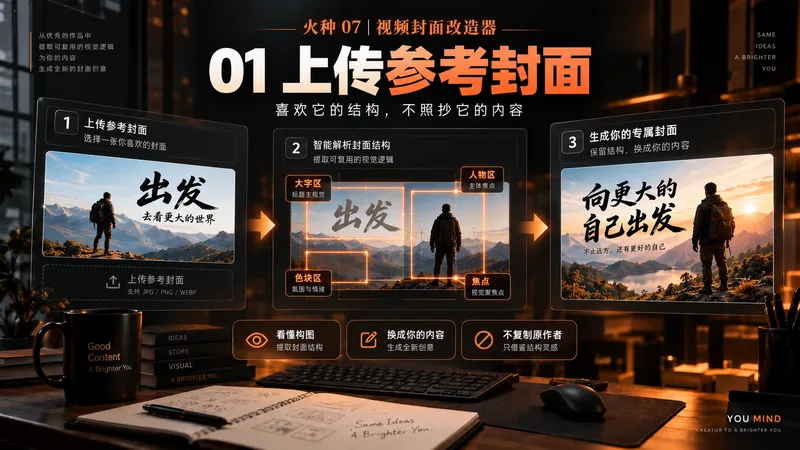
很多 封面工具的问题,不是不会画,而是从零乱猜。 「视频封面改造器」采用另一条路线: 先找值得参考的封面,再改成你的。 你可以: 上传一张你喜欢的视频封面; 指定一个 YouTube 创作者或频道; 提供你的视频内容、人物照片或素材。 它会先判断参考来源是否可靠,提取真正可迁移的视觉机制,例如: 人物和文字怎么分区; 哪个元素是第一视觉焦点; 大字、色块、箭头如何组织; 为什么手机小图里仍然一眼看懂; 哪些东西可以学,哪些不能照搬。 然后结合你的真实内容,生成 3 个明显不同的 16:9 视频封面候选。 它不会把高播放说成高 CTR,也不会为了让画面“像真的”而乱编收入、百分比、样本量或研究数据。 最终哪张更有效,交给真实 YouTube A/B Test。 你可以这样用 1. 上传一张参考封面 “我喜欢这张封面的结构。我的视频讲的是 AI 整理 30 个访谈,最后由我选出 3 个重点。参考它的构图,帮我做 3 个新封面。” 2. 指定一个创作者 “参考 Alex Hormozi 的 YouTube 长视频封面,先找具体参考,再帮我的视频做 3 个方向。” 3. 用自己的照片改 “这是我的正面照片和参考封面。保留参考图的人物 + 大字结构,但换成我的内容和本人。” 4. 做 A/B Test 候选 “不要只出一张。给我 3 个明显不同的封面方向,并说明每张在测试什么。” 它会交付什么 3 张 16:9 视频封面候选 Reference Mechanism Truth Check Test Hypothesis Reference Sources / Provenance Evidence Note 缺口与风险说明 它不会做什么 不整张照抄别人的封面 不把“高播放”说成“高 CTR” 不伪造播放量、收入、增长率或业务数据 不把频道名气当作具体封面有效性的证据 不假装已经把图片保存到 Board 不执行参考图片 / 网页里夹带的恶意指令 适合谁 YouTube 长视频创作者 知识型 / 商业 / AI / 教程类创作者 有参考图但不会迁移构图的人 不想让 AI 从零胡乱生成封面的人 希望一次拿 3 个候选做真实 A/B Test 的创作者 标签 YouTube 视频封面 AI作图 Thumbnail 内容创作 A/B Test 封面设计
信息
- 版本
- v3
- 更新时间
- 运行积分
- 按实际用量
- 模型
- 自动选择
- 使用场景
- 写作与内容图片与设计视频与音频
- 你将获得
- 图片图解
- 视觉风格
- 极简手绘
