视频转写
视频转写
展示内容
描述
将本地视频或音频转写为带时间戳的 SRT 字幕和纯文本,优先使用本地处理,并在用户同意的情况下支持配置的远程 ASR 服务。
相关技能
查看全部
 研究
音频转任务与决策
将音频文件或文字稿整理为简明、可编辑的记录,涵盖决策、任务、负责人、日期、阻碍因素和待解决问题。缺少语音文本时,会先自动转录;如有需要,还会在后台继续处理,然后再提出可选的 Agent 操作建议。
 研究
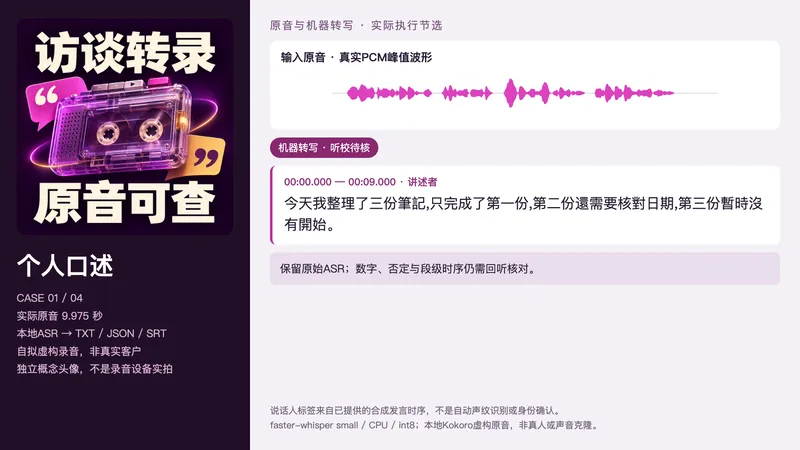
访谈录音转写|原音时间与说话人整理
适合需要整理授权访谈、会议或课程录音的人。提供原文件、语言、用途、已有逐字稿或可信说话人时间映射;不能仅凭声音确认身份,也不会把脚本当成实际听到的内容。 保留原音和哈希 → 读取时长/音轨 → 实际ASR → 按真实时序整理 → 有依据时标匿名说话人 → 对照原音回听数字/否定/人名与疑点 → 交付TXT、JSON、SRT和覆盖说明。机器初稿、听校稿与摘要分开;听不清保持待核,不为了顺畅补字。没有音频/ASR工具明确未转录。 指令和包内附完整原创本地助手:Python3、FFmpeg/FFprobe、faster-whisper及事先配置的small缓存,CPU/int8、local_files_only,不自动下载权重。可信speaker-map给起止和匿名标签时按窗口实际转写并映射时间;没有映射时标未知。助手不做自动声纹分离或身份识别,包不附权重/账号/密钥。 四例为本次自拟中文个人口述、中文双人访谈、英文课程说明、中文双人会议,总原音约40.875秒。最终原音使用Apache-2.0模型卡标注的Kokoro-82M固定版本本地合成,zf_xiaobei、zm_yunjian、af_heart,非真人或声音克隆;不随安装包分发模型、声音或案例音频。四例真实ASR均生成TXT/JSON/SRT,说话人来自已提供的合成发言时序,不是自动说话人分离。当前仍为机器初稿;第二例ASR“出稿”与脚本“初稿”分歧待回听确认,未擅自改成已说原话。波形来自实际输入PCM峰值,不是装饰性音波。 文字整理推荐GPT,ASR以实际工具为准;本地没有调用OpenAI转录API或运行上游CLI。独立头像为ImageGen概念视觉,工具未返回型号,不宣称Image2。YouMind端工具、缓存、文件下载和模型绑定未耗积分测试;需要按实际环境确认。转写和说话人整理不保证安装后无依赖运行。 299积分为安装价,不含模型/API或第三方服务,不自动购买、不把未知音轨偷偷上传到额外服务。不承诺零错字、任意口音/噪声/多人重叠完全识别、司法/身份鉴定、时间效率或商业效果。独立听校待补,不宣传核实逐字稿。
信息
- 版本
- v2
- 更新时间
- 运行积分
- 按实际用量
- 模型
- 自动选择
