B站字幕SRT導出與轉錄
解決目前無法使用官方轉錄的問題
B站字幕SRT導出與轉錄
解決目前無法使用官方轉錄的問題
展示內容
描述
在順利爬取字幕並生成srt檔案的情況下,AUTO模式【最低的】消耗為【77】積分 ---------------------------------------------------------------------------------------------------- 目前YouMind對B站影片的轉錄支援尚不完善,可能會直接卡住。在官方優化前,此SKILL可從B站影片(連結/BV號/YouMind影片檔案)藉助已登入瀏覽器取得官方AI字幕,生成可讀轉錄文件,並選擇性匯出標準SRT字幕檔案(本地.srt + YouMind文件)。內置cid校準與字幕一致性校驗,避免錯配或過期字幕。 操作過程已經儘量簡化處理。 根據skill提示,在【需要時】手動在已經開啟的B站影片網頁裡點擊AI識別字幕,選擇中文,即可抓取。目前這是最穩定的拉取方式,影片原自帶的字幕基本無法識別。 檔案會自動下載到(~.download;Mac系統,Win系統則依預設),在逐行檢視中點擊上傳即可。 ---------------------------------------------------------------------------------------------------- 目前可能會碰到且【可解決】的問題有: 1. 在YouMind檔案新增B站連結時,可能會出現抓取失敗的情況。這時點擊右上角【...】裡的重新獲取,大概率會出現正常畫面,但沒有影片小窗。此時重新再新增一個新連結就能抓取成功。 或 關閉所有頁面重新打開,或點擊B站分享的連結(而不是網頁連結)進行嘗試。 2. 在skill執行過程中,偶爾會發生字幕抓取錯誤的情況(可能是充電或免費影片的關係),讓AI自動修復任務即可,照着操作基本上不會出問題。 ---------------------------------------------------------------------------------------------------- 官方回覆紀錄如下: 1. B站這個影片本身沒有字幕文件。我們在儲存B站連結時,會預設自動去拉這個字幕文件,結果沒拉到,所以展示為空。 2. 字幕獲取任務是AI啟動的,AI會嘗試去拉影片串流來轉錄,但是B站不提供這種方式,所以就出現了一直在轉圈的情況,實際上已經失敗了。 ------ 解決方案 1. 可以看看YouTube和TikTok上有無對應的影片,這兩個網站的影片支援拉影片串流轉錄,我們走上述第二個方案是可以成功的。 ------ 後續優化: 1. 我們會強化一下AI的grabFileTranscript行為,避免B站的字幕抓取,這樣就不用出現這種情況了。 ---------------------------------------------------------------------------------------------------- 期待後續正式適配。在此之前可以靠這個進行過渡,微收點積分回回血,謝謝各位。有問題可以在群裏@火腿人肖恩
相關技能
查看全部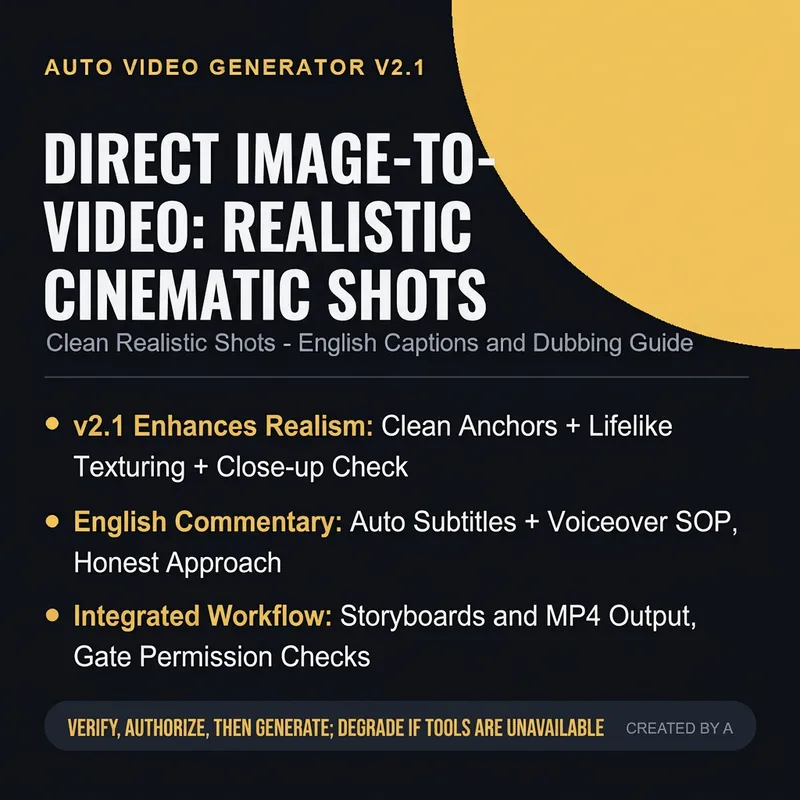 視頻
單圖自動出影片支援多國語言配音
這一款 會在對話裏實際調用可用的生圖 / 影片生成工具 ,交付的是分鏡圖片檔案與拼接好的影片檔案,不是一張寫着提示詞的紙。 v2.0.0 起,模特還能用英文介紹產品 ——不是只讓他在畫面裏張嘴,而是真把英文配音做進成品。 ## 一句話 **不是給你提示詞讓你自己跑,是在對話裏探測工具、拿到你確認後,直接把分鏡圖和拼接 MP4 做出來,並給你英文字幕和發布層補英文人聲的照做步驟。** ## 詳情描述(可整段複製) 你上載一張圖,這款技能先在對話裏做三件事:探測當前會話真實可用的生圖 / 影片 / 拼接工具,逐條核對素材權屬、商標文字、人物合規、授權、內容安全、廣告用語、AI 標註與工具邊界,然後把"這次準備調用幾次、會產生積分消耗"說清楚,等你明確同意才開始生成。 生成給你兩條路。**路徑 A**:先出六張分鏡首幀圖,逐幀核過主體、文字、人物、光線,再一幀一段轉成短片,最後拼成一條 MP4——文字跑偏、人物漂移這類問題在圖片階段就被攔住。**路徑 B**:單主體、單一動作、無文字的試水,用輸入圖加一段提示詞直接出片,失敗就退回路徑 A,不在一條路上反覆抽卡燒積分。 同一張圖可以配多檔中性、虛構、成年人的人物描述,默認先跑一套樣片給你看,確認後再批量。每批結束報告實際調用次數和檔案真實路徑,方便你核對消耗。 **英文講解怎麼落地(實測後如實說明)**:先鎖一份可核驗嘅產品事實錨(參數、認證、價格查不到標「待核實」,絕不編),再按人物語氣寫分檔英文腳本——一檔輕鬆分享、一檔平靜講解、一檔專業測評,每句 6~12 詞、念出來不超過對應鏡頭時長;出一張音畫對齊表釘住"哪一鏡、說甚麼、字幕放哪",逐句過英文廣告合規(絕對化用語零容忍,參數認證必須有來源)。**先看一個誠實的平臺事實**:YOUMIND 這類平臺的影片模式只生成畫面、音軌通常是 BGM,**不會自動冒出英文人聲**。所以英文講解分兩層交付——① 必出英文字幕,壓在畫面留白區,這是"看得見的英文",不依賴任何配音工具;② 若當前環境探測不到配音工具(YOUMIND 常見),交給你英文腳本 + 對齊表 + 一份照着做的發布層補聲步驟(把英文句粘進剪映 / CapCut 的"文本朗讀",選英文音色,按對齊表裁切疊加)。**本次成品影片只有字幕、沒有英文人聲,人聲需你在發布層補**——不把 BGM 說成英文講解,不假裝配音。若環境恰好有配音工具,就直接生成英文音軌疊進成片。 **v2.1 治"髒"和"AI 感"(實測反饋修的)**:四層提示詞加了產品潔淨錨(clean / pristine / no smudges)和實拍質感錨(自然皮膚紋理 / 織物紋路 / 手持感 / 自然光),負向層排除污漬 / 髒舊 / 蠟像皮膚 / 過度磨皮 / 塑料感 / 卡通渲染;產品近景特寫鏡逐鏡檢查潔淨度和真實感,髒了或太假就補錨重調,不把髒品、蠟像感當成品交。**輸入圖本身就髒的話請先換一張乾淨清晰的產品圖**——提示詞救不回髒圖。 **當前環境沒有可用的生成工具時,技能會直接說明"無法自動出片",並給出完整提示詞包與分鏡表作為降級交付**;無論哪種情況都不會假裝生成、不會假裝配音、不會編一個檔案路徑給你。 **它會消耗積分**:每調用一次圖像或影片生成都會產生平臺積分或訂閱額度消耗,具體以平臺當期顯示為準,本技能不承諾具體數字、不宣稱零成本。生成結果有概率性,不保證一條過,也不保證爆款、收益或平臺過審。AI 生成內容標註按目標平臺當期官方要求處理,規則不明處標「待核實」。當期可選模型與帳戶可用情況以你創建介面的實時顯示為準,技能會先探測工具是否支援,不支援就明確告知並給替代,不假裝用了指定型號。 ## 三條賣點 1. **真的出檔案**:交付分鏡圖、影片段與拼接 MP4,不是一張寫着提示詞的紙。 2. **英文講解落地不糊弄**:事實錨 → 分檔英文腳本 → 音畫對齊 → 廣告合規 → 必出英文字幕 + 發布層補英文人聲 SOP;誠實說明影片本身不說英文、人聲需後補,不把 BGM 當講解。 3. **專治髒和 AI 感(v2.1)**:潔淨錨 + 實拍質感錨 + 逐鏡放大 QA,近景不髒、畫面不像蠟像塑料;先探測工具、過 9 條閘門、告知消耗並確認才動手,沒工具就誠實降級。 ##
 研究
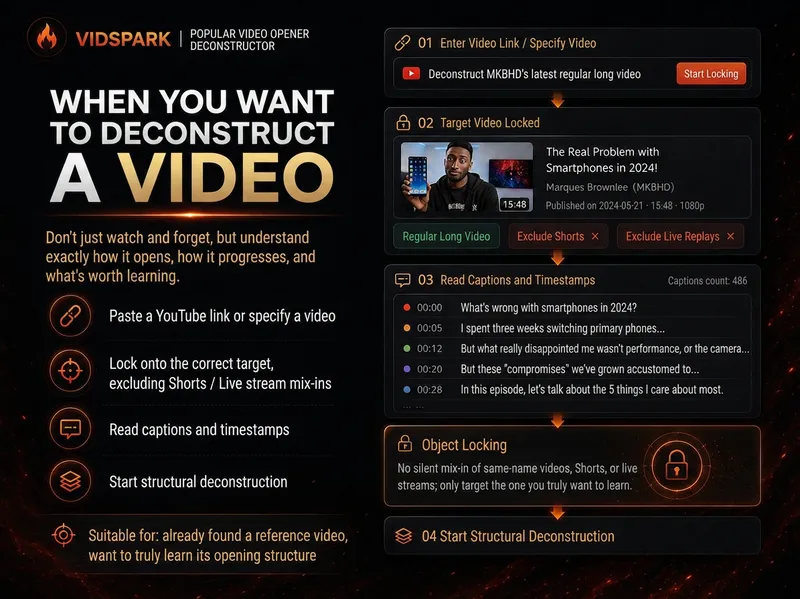
火種|熱門影片開頭拆解器
準備做影片時,我們經常會遇到一種情況:你明明看出某條參考影片「很會講」,但真正輪到自己做時,只能憑感覺模仿。 「火種|熱門影片開頭拆解器」就是為這一步準備的。 給它一條明確的 YouTube 影片,它會先確認影片對象並讀取可驗證字幕,再把三個容易混在一起的東西分開: Literal 30s:影片 0:00–0:30 實際發生了什麼。 Intro:進入主體前的整個開場。 Hook / Re-hook:真正承擔留住觀眾作用的一個或多個結構拍點。 因此,它不會因為「大家都說前 30 秒最重要」,就強行把所有影片的前 30 秒解釋成 Hook。真正的 Hook 在 1 分鐘以後,它也會如實告訴你;字幕或時間戳不足,它會明確標出證據缺口,而不是補一個看起來很專業的答案。 完成開頭拆解後,它會繼續用大綱還原整條影片的內容結構:影片靠時間線、實驗、步驟、對比、故事、問題鏈還是其他組織裝置往前推進?最後再把這些結構抽象成 [槽位] 範本。 範本保留的是結構順序和功能,不是原作者的經歷、措辭、品牌、數字、觀點或權威身份。 最終你得到的不是一份影片摘要,而是一張可以繼續交給下一步創作使用的 Hook Outline + 全片結構範本。 它不會做什麼 它不會: 直接替你寫最終新 Hook; 用 BRENS 給你的開頭評分或改寫; 大規模搜尋整個賽道或頻道; 生成完整劇本; 生成圖解、素材、動畫或縮圖。 大規模找參考樣本屬於上游「火種|YouTube內容研究員」;你自己的 Hook 打磨屬於後續對應 Skill。
 研究
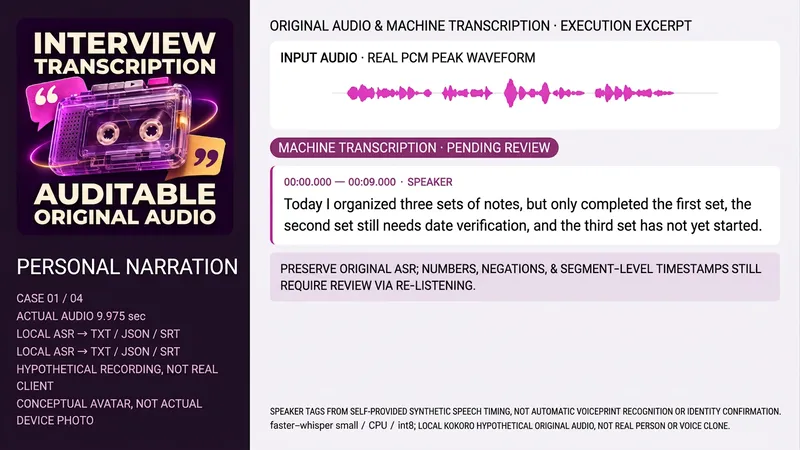
訪談錄音轉寫|時間與說話人整理
適合需要整理授權訪談、會議或課程錄音的人。提供原檔案、語言、用途、已有逐字稿或可信說話人時間對應;不能僅憑聲音確認身份,也不會把腳本当成實際聽到的內容。 保留原音和雜湊 → 讀取時長/音軌 → 實際ASR → 按真實時序整理 → 有依據時標匿名說話人 → 對照原音回聽數字/否定/人名與疑點 → 交付TXT、JSON、SRT和覆蓋說明。機器初稿、聽校稿與摘要分開;聽不清保持待核,不為了順暢補字。沒有音頻/ASR工具明確未轉錄。 指令和包內附完整原創本地助手:Python3、FFmpeg/FFprobe、faster-whisper及事先配置的small快取,CPU/int8、local_files_only,不自動下載權重。可信speaker-map給起止和匿名標籤時按視窗實際轉寫並對應時間;沒有對應時標未知。助手不做自動聲紋分離或身份識別,包不附權重/帳號/金鑰。 四例為本次自擬中文個人口述、中文雙人訪談、英文課程說明、中文雙人會議,總原音約40.875秒。最終原音使用Apache-2.0模型卡標註的Kokoro-82M固定版本本地合成,zf_xiaobei、zm_yunjian、af_heart,非真人或聲音複製;不隨安裝包分發模型、聲音或案例音頻。四例真實ASR均生成TXT/JSON/SRT,說話人來自已提供的合成發言時序,不是自動說話人分離。當前仍為機器初稿;第二例ASR「出稿」與指令「初稿」分歧待回聽確認,未擅自改成已說原話。波形來自實際輸入PCM峰值,不是裝飾性音波。 文字整理推薦GPT,ASR以實際工具為準;本地沒有調用OpenAI轉錄API或運行上游CLI。獨立頭像為ImageGen概念視覺,工具未返回型號,不宣稱Image2。YouMind端工具、快取、檔案下載和模型綁定未耗積分測試;需要按實際環境確認。轉寫和說話人整理不保證安裝後無依賴運行。 299積分為安裝價,不含模型/API或第三方服務,不自動購買、不把未知音軌偷偷上傳到額外服務。不承諾零錯字、任意口音/雜訊/多人重疊完全識別、司法/身份鑑定、時間效率或商業效果。獨立聽校待補,不宣傳核實逐字稿。
資訊
- 版本
- v11
- 更新時間
- 執行點數
- 依實際用量
- 模型
- 自動選擇
