我們將 Cerebras 晶圓級引擎與 GPU 結合部署,以大規模提供極速的 token 生成能力
全球對超高速 token 的需求正不斷攀升。2026 年,Cerebras 在自家的推論雲端以及透過合作夥伴,都看到了對快速推論的龐大需求。為了滿足市場需求,我們開始開發分離式推論(disaggregated inference):由 GPU 負責提示詞處理(prefill),Cerebras 系統則負責輸出生成(decode)。
此解決方案現已正式上線,能在維持 Cerebras 原有超高速度的同時,每兆瓦產出五倍的 token。
現在,我們可以透過 Cerebras Inference Cloud 提供更多超高速 token,以滿足市場需求。基礎設施合作夥伴也能採用 Cerebras 的分離式解決方案,在自己的資料中心內實現更多超高速 token 的產出。
搭配近期發表的 CS-4、大幅擴充的製造產能,以及規劃中 700MW 的資料中心容量,分離式推論將讓 Cerebras 與合作夥伴在 2027 年及以後,能夠提供數量更為驚人的超高速 token。本篇部落格文章將探討:
- 為何需要更多超高速推論算力
- 為什麼 Cerebras 在 decode 階段具備優勢
- Cerebras 分離式推論的實際生產成果
- 為基礎設施合作夥伴打造的 Cerebras 分離式推論方案
為何需要更多快速推論算力
像 Muse、Copilot 和 Codex 這類 Agent 應用程式正在快速擴展,並需要高度互動的推論能力來維持使用者的參與度。要在電力受限的環境下滿足這些應用程式日益增長的需求,我們的產業必須在每兆瓦內提供顯著更多的推論算力,同時保持能讓這些應用程式真正發揮價值的回應速度。

資料來源:Goldman Sachs Research,「AI Agents Forecast to Boost Tech Cash Flow as Usage Soars」,2026 年 5 月 20 日;Goldman Sachs 資料中心容量預估,由 Investing.com 報導
這就是為什麼 Cerebras 投入發展分離式架構。將負責提示詞處理的 prefill 加速器與負責回應生成的 Cerebras 系統搭配使用,不僅能提升每兆瓦的 token 吞吐量,還能保留 Cerebras 的超高速生成能力。對推論服務供應商而言,這意味著在相同的電力預算下,能服務更多客戶,並創造更大的營收潛力。
為什麼 Cerebras 在 decode 階段具備優勢
一次推論請求主要分為兩個階段。提示詞處理(即 prefill)會處理輸入內容並產生中間模型狀態;回應生成(即 decode)則利用該狀態來生成輸出 token。切分推論工作負載的方式有很多種,例如 draft–target 或 attention–FFN 等,但若目標是實現高度互動的推論,將 prefill 與 decode 分開會具有獨特的優勢。

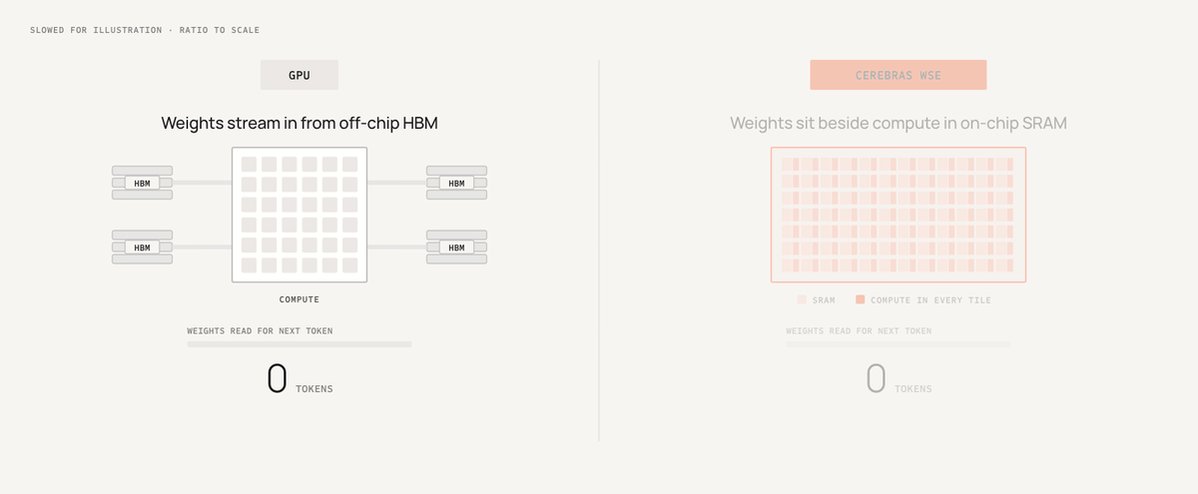
Decode 是自迴歸(autoregressive)的。這代表模型會一次生成一個 token,並將每個生成的 token 作為輸入來生成下一個。每一個步驟都需要重新從記憶體讀取模型資料,因此記憶體頻寬至關重要。在超高速推論領域中,以 SRAM 為核心的晶片更具優勢,因為它們能將資料留在晶片上,並以快得多的速度讀取。Cerebras 將這一點提升到晶圓級規模,在單一晶片上提供數十 GB 的 SRAM 與每秒數十 PB 的記憶體頻寬——分別是典型 GB300 GPU 的 350 倍 SRAM 容量與 5,400 倍記憶體頻寬。這讓 Cerebras 系統能直接在晶片上容納更多並行請求與模型層,使 CS-3、CS-4 和 CS-5 能以極具吸引力的吞吐量達到超高速運算。
GIF
Cerebras 分離式推論的實際生產成果
將專為超高速 decode 最佳化的 Cerebras 系統,與適合 prefill 運算需求的加速器(例如 AMD Instinct GPU)搭配使用,就能大規模提供海量的超高速推論。在 Cerebras Inference Cloud 的實際生產部署中,由 AMD Instinct GPU 處理提示詞,Cerebras CS-3 系統則負責生成回應。將提示詞處理交由 GPU 執行後,Cerebras 系統便能將全部服務算力集中於回應生成。根據我們在生產環境中的實測數據,這種組合的每兆瓦吞吐量達到了純 CS-3 配置的五倍,且 token 生成速度完全沒有下降。

資料來源:11 月 14 日透過 Cerebras Inference Cloud 提供的共享 GPT-OSS-120B 端點,啟用分離式推論前後的每兆瓦吞吐量比較,以聚合式推論基準(1×)進行標準化。
我們計畫在 2027 年底前,於 Cerebras Inference Cloud 及合作夥伴的部署中,廣泛推行數百兆瓦規模的分離式推論。我們的目標是為客戶提供更多可用的超高速推論算力。
為基礎設施合作夥伴打造的 Cerebras 分離式推論方案
Cerebras 分離式推論解決方案同樣也是為了讓合作夥伴輕鬆導入而設計的。基礎設施合作夥伴可以依據 Cerebras 提供的參考架構部署分離式推論叢集,將自己選擇的 prefill 加速器與 Cerebras 系統整合在同一個網路中。在軟體整合方面,合作夥伴可以選擇接入 Cerebras 的端到端分離式軟體堆疊,或是僅使用 decode 專用的 SDK。
- 端到端分離式軟體堆疊最適合希望加快產品上市時程的合作夥伴。它包含:
- 分離式推論框架:用於在 prefill 與 decode 資源池之間路由請求,並管理副本容量與健康狀態。
- Prefill 引擎:使用 vLLM 或 SGLang 等開源推論引擎來處理提示詞。
- Cerebras decode 引擎:在 Cerebras 系統上執行回應生成。
- KV Portal 軟體:透過 RDMA 在 prefill 與 decode 引擎之間傳輸中間模型狀態(包含鍵值快取)的介面。
僅含 decode 的 SDK 則最適合追求高度掌控權的合作夥伴。透過這款 SDK,合作夥伴可以將自己的推論框架與 prefill 引擎,與 Cerebras decode 引擎及 KV Portal 軟體相互整合。此外,僅含 decode 的 SDK 也提供了多項開發輔助工具,例如模擬的 Cerebras decode 副本,以及與開源分離式推論框架和 prefill 引擎的參考整合範例。

包括 Amazon Web Services、Fireworks AI、Gimlet Labs 和 General Compute 在內的早期合作夥伴,已經可以在其部署中使用 Cerebras 分離式解決方案。我們目前正擴大開放範圍,讓更多希望大規模為客戶提供超高速推論的合作夥伴加入。
若想進一步了解相關成果、解決方案或部署機會,請點擊這裡聯絡我們。


