Bio/Med深度可靠調研
Bio/Med深度可靠調研
展示內容
描述
適用場景:完成一輪生物/生物醫學類科研文獻檢索並給用戶提供詳實可靠的輸出 1. 用戶發起檢索後系統拆解問題和關鍵詞 2. 使用公開、可重現的數據源檢索文獻 3. 對檢索結果進行去重、分層、證據分級和排序 4. 回覆中使用可點擊正文引用 5. 文末逐條列出完整文獻資訊,並用公開可查路線標註 IF;如果無法高置信核驗,必須標為「待核驗」或「未檢出」。
推薦自
Nico@YouMind
為什麼我們推薦這個技能
這項技能是生物醫學研究的可靠指南,透過結構化查詢、多階段文獻篩選和嚴謹的IF核查,確保提供高度準確且可驗證的科研資訊。
指令
這套流程的核心是:先用多query 在PubMed / NCBI E-utilities 做可複現初篩,再用PMID 去重和摘要證據分級;只有少量關鍵文獻進入PMC / BioC 全文複現;正文引用必須可點擊;文末必須列完整文獻資訊;IF 只能透過取信可存取權,不能將其保留使用保守結果
1. 使用者發起檢索後的預處理
1.1 先解析使用者問題
收到用戶問題後,先把自然語言問題拆成結構化要素。
必須識別:
• 研究對象:基因、蛋白、藥物、通道、細胞類型、組織、疾病、模型。
• 生物系統:人、小鼠、大鼠、斑馬魚、類器官、視網膜、腦區、細胞係等。
• 關係類型:表現、調控、功能、機制、表型、死亡、存活、治療、毒性、發育、退化等。
• 證據需求:是否需要直接證據、機制證據、全文證據、圖表、劑量參數、實驗方法。
• 時間範圍:不限時間、近5 年、近1 年、最新進展、經典文獻。
• 產出類型:簡答、代表文獻、綜述式總結、實驗設計建議、證據表、機製圖譜。
範例:
用戶問題:
“幫我找視網膜類器官死亡相關文獻。”
結構化拆解(例):
• 核心模式:retinal organoid, retina organoid, hPSC-derived retinal organoid, optic cup organoid。
• 表型:cell death, apoptosis, degeneration, survival loss, stress, necrosis。
• 相關細胞:photoreceptor, cone, rod, retinal ganglion cell, Müller glia。
• 潛在機制:oxidative stress, ER stress, mitochondrial dysfunction, hypoxia, inflammation, ferroptosis, necroptosis。
• 證據目標:優先找直接在人源或動物源retinal organoid 中觀察到細胞死亡/凋亡/退化的原始研究;再找間接機製文獻。
1.2 關鍵字拆分原則(範例)
不要只寫一個檢索式。每個概念至少準備三類詞。
第一類:精確詞。
• retinal organoid
• retina organoid
• human retinal organoid
• hPSC-derived retinal organoid
• iPSC-derived retinal organoid
第二類:同義詞和上位詞。
• optic cup organoid
• 3D retinal culture
• stem cell-derived retina
• retinal differentiation
• retinal tissue model
第三類:機制和表型詞。
• apoptosis
• cell death
• degeneration
• survival
• stress
• oxidative stress
• ER stress
• mitochondrial dysfunction
• hypoxia
• necroptosis
• ferroptosis
如果使用者限定細胞類型,加入:
• photoreceptor
• cone
• rod
• retinal ganglion cell
• Müller glia
• bipolar cell
• amacrine cell
如果使用者限定物種或來源,加入:
• human
• mouse
• rat
• zebrafish
• hESC
• iPSC
• pluripotent stem cell
1.3 產生分層檢索式
至少生成3–6 組query。每組query 對應一個檢索目的。
第一層:直接證據檢索。
用於找出目標模型+ 目標表型直接命中的文獻。
```text
("retinal organoid" OR "retina organoid" OR "human retinal organoid") AND (apoptosis OR "cell death" OR degeneration)
```
第二層:擴充模型檢索。
用於捕捉作者沒有使用retinal organoid 精確詞但實際相關的文獻。
```text
("optic cup organoid" OR "3D retinal culture" OR "stem cell-derived retina") AND (survival OR apoptosis OR stress)
```
第三層:機制專項檢索。
用於驗證具體通路或機制。
```text
("retinal organoid" OR "retina organoid") AND ("oxidative stress" OR "ER stress" OR hypoxia OR mitochondria)
```
第四層:細胞類型專項檢索。
```text
("retinal organoid" OR "retina organoid") AND (photoreceptor OR cone OR rod OR "retinal ganglion cell") AND (death OR apoptosis OR degeneration)
```
第五層:疾病模型檢索。
```text
("retinal organoid" OR "retina organoid") AND (disease OR degeneration OR dystrophy OR retinitis OR glaucoma)
```
第六層:綜述/背景檢索。
```text
("retinal organoid" OR "retina organoid") AND (review OR protocol OR model)
```
2. 使用什麼方法、在什麼網站檢索
2.1 首選:PubMed / NCBI E-utilities
PubMed 是生物醫學文獻檢索首選。不要預設抓PubMed 網頁。應使用NCBI E-utilities API。
2.1.1 ESearch:用query 取得PMID
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi
```
參數:
```text
db=pubmed
term=<檢索式>
retmode=json
retmax=20
sort=relevance
```
也可依時間排序:
```text
sort=pub+date
```
範例:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=pubmed&term=(%22retinal%20organoid%22%20OR%20 %22retina%20organoid%22)%20AND%20(apoptosis%20OR%20%22cell%20death%22)&retmode=json&retmax=20&sort=relevance
```
返回中讀取:
```text
esearchresult.idlist
```
這就是PMID 清單。
2.1.2 ESummary:取得文獻metadata
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi
```
參數:
```text
db=pubmed
id=PMID1,PMID2,PMID3
retmode=json
```
提取字段:
• PMID
• title
• fulljournalname
• source / journal abbreviation
• pubdate
• authors
• articleids 中的DOI、PMCID
• volume、issue、pages
2.1.3 EFetch:取得摘要和XML 細節
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi
```
參數:
```text
db=pubmed
id=PMID1,PMID2
retmode=xml
rettype=abstract
```
提取字段:
• ArticleTitle
• AbstractText
• Journal Title
• ISOAbbreviation
• ISSN / eISSN
• PubDate
• DOI
• PMCID
• MeSH terms
2.1.4 批次檢索策略
推薦流程:
1. 對每個query 呼叫ESearch。
2. 每個query 取前5–20 篇。
3. 合併所有PMID。
4. 按PMID 去重。
5. 用ESummary / EFetch 批次取得metadata 和abstract。
6. 初篩階段只讀metadata + abstract,不要一開始抓全文。
────────────────
2.2 第二階段:PMC / BioC 全文複核
只有以下情況才會進入全文:
• 使用者要求精讀全文。
• 摘要不足以判斷機制。
• 需要圖表、實驗方法、濃度、劑量、IC50、EC50、Kd、Ki。
• 已篩選出少量關鍵PMID,需要逐篇機制複核。
2.2.1 PMID 轉PMCID
接口:
```text
https://www.ncbi.nlm.nih.gov/pmc/utils/idconv/v1.0/?ids=
```
如果傳回PMCID,說明可能有PMC 開放全文。
2.2.2 優先BioC JSON
接口:
```text
https://www.ncbi.nlm.nih.gov/research/bionlp/RESTful/pmcoa.cgi/BioC_json/
```
優點:結構化程度高,適合抽取正文段落。
2.2.3 BioC 不可用時嘗試PMC XML
接口:
```text
https://www.ncbi.nlm.nih.gov/pmc/articles/
```
抽取正文時跳過:
• references
• bibliography
• acknowledgements
• author contributions
• competing interests
全文複審必須設定停止判據:
• 每篇文獻只掃描一次。
• 預設只抽取與問題相關的段落。
• 若未命中目標字段,標註「未見直接證據」。
• 不要無限換關鍵字重複抓取。
────────────────
2.3 bioRxiv / medRxiv
用於補充最新預印本。
可以使用官方API:
```text
https://api.biorxiv.org/details/biorxiv/YYYY-MM-DD/YYYY-MM-DD
https://api.biorxiv.org/details/medrxiv/YYYY-MM-DD/YYYY-MM-DD
```
也可用普通搜尋作為補充:
```text
site:biorxiv.org retinal organoid apoptosis
site:medrxiv.org retina organoid degeneration
```
預印本必須標註:
```text
預印本,未經同儕評審。
```
────────────────
2.4 Crossref / OpenAlex / Unpaywall
用於補全DOI、開放全文地址、出版資訊。
Crossref:
```text
https://api.crossref.org/works?query.title=<title>
```
OpenAlex:
```text
https://api.openalex.org/works?search=<title or topic>
```
Unpaywall:
```text
https://api.unpaywall.org/v2/
```
用途:
• DOI 補全。
• OA PDF 連結查找。
• 期刊名核驗。
• 出版年份核驗。
────────────────
2.5 出版商頁面
只有在API 資訊不足時才造訪出版商頁面。
訪問規則:
• 每個出版商URL 只嘗試一次。
• 遇到驗證碼、登入牆、Cloudflare、Access Denied、機構權限牆,立即停止。
• 不要重複刷新、換同站路徑、循環等待。
• 改用PubMed、PMC、Crossref、OpenAlex、Unpaywall、DOI metadata 兜底。
3. 檢索後如何整理訊息
3.1 建立統一記錄結構
每篇文獻整理成統一record。
字段:
```text
pmid
doi
pmcid
title
authors
journal
journal_abbrev
issn
eissn
year
abstract
query_source
evidence_level
evidence_tags
paper_type
url
```
3.2 去重
優先:
1. PMID 去重。
2. 沒有PMID 時用DOI 去重。
3. 沒有DOI 時用lower(title) + year + first_author 去重。
保留第一次命中的query_source,同時記錄該文獻被哪些query 命中。
3.3 證據分級
必須區分:
直接證據:
目標物種、組織、細胞類型、模型、處理條件直接命中。
間接證據:
相鄰系統、相似模型、相近機制支持,但不是使用者問題的直接系統。
未見直接證據:
只能找到背景、推測、綜述或相鄰模型,沒有直接實驗結果。
3.4 文獻類型標註
至少標註:
• original research
• review
• protocol
• preprint
• dataset/resource
• clinical study
•method paper
3.5 排序規則
推薦排序:
1. 直接證據原始研究。
2. 關鍵機制研究。
3. 最新重要研究。
4. 經典奠基研究。
5. 高品質綜述。
6. 間接證據。
不要只按IF 排序。 IF 是期刊層面指標,不等於單一文獻品質。
4. 回覆中如何組織引用
4.1 正文引用格式
正文引用必須可點選。
格式:
```markdown
[[1. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
```
範例:
```markdown
已有研究在人源retinal organoids 中觀察到發育階段相關的光感受器壓力和退化現象[[1. **Cell Stem Cell**, 2019]](https://pubmed.ncbi.nlm.nih.gov/xxxxxxx/)。
```
不要寫成:
```text
[1]
(PMID: xxxxx)
見文獻1
```
4.2 推薦回答結構
第一段:直接結論。
```text
結論:已有相關報導,但直接證據主要集中在……;關於……仍缺乏直接證據。
```
第二段:證據分級。
```text
直接證據:
- 文獻A:…
間接證據:
- 文獻B:…
未見直接證據:
- 本輪找不到…
```
第三段:機制歸納。
按主題分組,例如:
• apoptosis / caspase pathway
• oxidative stress
• mitochondrial dysfunction
• ER stress
• hypoxia / metabolic stress
• inflammation
• developmental mismatch
第四段:研究空白。
明確說明哪些問題沒有直接證據。
第五段:實驗啟發。
如果使用者需要實驗設計,給予marker、assay、time point、control。
5. 文末完整文獻資訊列表
只要正文引用具體文獻,文末必須附上完整列表。
格式:
```markdown
## 完整文獻資訊列表
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Qn}*
2. Wang X et al., **Journal Name** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=待核驗}*
```
作者格式:
• 1–3 位作者:列出全部。
• 超過3 位:第一作者et al.
PMID / DOI / URL 必須可點選。
6. IF 核查與標註
6.1 先說明IF 核查的現實限制
正常情況下,官方Journal Impact Factor 來自Clarivate Journal Citation Reports(JCR)。但任意外部Agent 通常沒有Clarivate/JCR 帳號,也沒有本地JCR 表,所以不要經過這個路徑核查。
```
6.2 IF skill 的實際方法
主要路線:
1. 如果輸入是PMID,先用NCBI E-utilities 取得PubMed metadata。
- 取得FullJournalName。 - 取得Source / ISO abbreviation。 - 取得ISSN / eISSN。 - 取得標題、年份、DOI 等輔助欄位。
2. 用公開的iikx / 愛科學行動端JSON 介面查詢期刊。
搜尋介面:
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
詳情接口:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
3. 對搜尋結果做保守配對。
- 優先exact normalized journal title match。 - 其次exact abbreviation match。 - 對短詞和寬泛詞非常謹慎。 - 不接受明顯substring 誤配,例如Nature 被誤配成Nature Reviews 系列。 - 如果匹配不穩,返回ambiguous / 不_found,而不是猜。
4. 如果PubMed 給的是縮寫,嘗試用NLM Catalog 擴展為全名或alternate title。
NLM Catalog 搜尋介面仍然是NCBI E-utilities:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=[Title Abbreviation]&retmode=xml&retmax=1
```
然後用ESummary 取Title / TitleAlternate。
5. 從iikx detail 結果中讀取:
- impact factor。 - IF 年份。 - JCR quartile。 - CAS / 中科院分區,如果有。 - source URL。 - match confidence。
6. 標註時不把IF 年份寫進正文緊湊標註。
最終標註只寫:
```text
*{IF=X,Qn}*
```
如果失敗:
```text
*{IF=待核驗}*
```
或:
```text
*{IF=未檢出}*
```
6.3 具體步驟
對每篇文獻執行以下流程。
第一步:準備期刊查詢名稱。
優先從PubMed metadata 取:
```text
FullJournalName
ISOAbbreviation / Source
ISSN
eISSN
```
如果只有DOI,則先用Crossref 或OpenAlex 取期刊名。
Crossref:
```text
https://api.crossref.org/works/
```
OpenAlex:
```text
https://api.openalex.org/works/https://doi.org/
```
第二步:規範化期刊名。
規範化規則:
• 全部小寫。
• HTML unescape。
• 將& 替換為and。
• 去除標點。
• 多個空格合併。
• 比較時可同時使用compact 形式,即去除所有空格。
範例偽代碼:
『`python
import re, html
def norm(s):
s = html.unescape(s or '').lower()
s = re.sub(r'&', ' 和 ', s)
s = re.sub(r'[^a-z0-9]+', ' ', s)
return re.sub(r'\s+', ' ', s).strip()
def compact(s):
return norm(s).replace(' ', '')
```
第三步:查詢iikx 搜尋介面。
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
建議設定User-Agent,例如:
```text
Mozilla/5.0
```
如果第一頁沒找到exact match,可以有限翻頁,例如最多8 頁。
翻頁參數通常為:
```text
page=2
page=3
```
第四步:從搜尋結果中選候選。
候選欄位通常包括:
```text
id
classid
title
smalltitle
IF 或IF2024
zky2020
url
```
匹配規則:
• 如果compact(query) == compact(candidate.title),接受。
• 如果norm(query) == norm(candidate.title),接受。
• 如果compact(query) == compact(candidate.smalltitle),接受。
• 如果norm(query) == norm(candidate.smalltitle),接受。
• 如果只是substring,不要直接接受,除非query 夠長且無歧義。
• 對Nature、Science、Cell、Brain、Vision、Retina 等短字尤其謹慎。
第五步:如果沒有匹配,用NLM Catalog 擴充縮寫。
例如PubMed 裡Source 是:
```text
Free Radic Biol Med
```
可以查:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=Free%20Radic%20Biol%20Med%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1
```
拿到NLM Catalog ID 後,再用:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=nlmcatalog&id=
```
讀取:
```text
Title
TitleAlternate
```
然後用這些全名再查iikx。
第六步:查iikx 詳情介面。
如果搜尋結果裡有:
```text
id=
classid=
```
調用:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
從detail 讀取:
```text
IF2024, IF2023, IF2022 ...
IF
zky2020 或其他JCR quartile 字段
jcr22 / jcr12 或分區字段
issn
eissn
title
smalltitle
category
```
第七步:選擇最新IF。
在返回欄位中尋找所有形如:
```text
IF20xx
```
例如:
```text
IF2024
IF2023
IF2022
```
選年份最大的有效數字。
如果沒有IF20xx,則嘗試讀取:
```text
IF
if_value
```
如果沒有有效值,則標為未檢出。
第八步:輸出置信度和標註。
如果exact title / abbreviation 命中,且detail 回傳有效IF:
```text
*{IF=X,Qn}*
```
如果匹配不確定:
```text
*{IF=待核驗}*
```
如果公開接口沒有結果:
```text
*{IF=未檢出}*
```
6.4 IF 標註格式
固定格式:
```text
*{IF=X,Qn}*
```
範例:
```markdown
Smith J et al., **Neuron** (2020), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=15.0,Q1}*
```
注意:
• IF 標註內部不寫JCR 年份。
• 不寫「2024 JCR IF」。
• 不寫「JCR 2024」。
• 年份只保留在文獻發表年份處。
• 若IF 為0.0、空值、來源不穩、符合不穩,則不顯示數字。
6.5 IF 核查失敗時的標準處理
不要猜。
不要用期刊名印象補數字。
不要用大模型記憶補IF。
失敗時只允許三種狀態:
```text
*{IF=待核驗}*
```
用於:
• 搜尋結果模糊。
• 有多個相似期刊。
• 只找到縮寫但無法確認全名。
• 公開來源傳回的IF 可疑。
```text
*{IF=未檢出}*
```
用於:
• 公開介面沒有結果。
• 期刊不在SCI / JCR 覆蓋範圍。
• 新刊暫無IF。
```text
*{IF=不可公開核驗}*
```
用於:
• 使用者要求必須官方JCR,但目前Agent 沒有Clarivate/JCR 權限。
7. 最終回覆自檢清單
發出前必須檢查:
• 是否先回答使用者核心問題。
• 是否區分直接證據、間接證據、未見直接證據。
• 是否所有正文引用都可點選。
• 是否文末有完整文獻資訊列表。
• 是否每篇文獻都帶IF 標註或待核驗/未檢出標註。
• PMID/DOI/URL 是否可點選。
• 是否避免將整體組織結果偷換成特定細胞類型結論。
• 是否避免將活化/磷酸化偷換成總表現量升高。
• 是否標註預印本。
• 是否說明檢索邊界。
• IF 沒有憑記憶猜測。
8. 可復現偽代碼
『`python
queries = build_queries(user_question)
all_pmids = []
for query in queries:
pmids = ncbi_esearch(query, retmax=20, sort='relevance')
all_pmids.extend(pmids)
pmids = deduplicate_keep_order(all_pmids)
metadata = ncbi_esummary(pmids)
abstracts = ncbi_efetch_abstract(pmids)
records = merge_metadata_and_abstracts(metadata, abstracts)
records = tag_evidence(records, user_question)
records = rank_records(records)
selected = select_top_records(records)
if need_fulltext:
for record in selected_key_records:
pmcid = idconv_pmid_to_pmcid(record.pmid)
if pmcid:
record.fulltext = fetch_bioc_or_pmc_xml(pmcid)
for record in selected:
journal_query = record.full_journal_name 或 record.journal_abbrev
if_result = lookup_if_public_iikx(journal_query)
if if_result.confident:
record.if_annotation = f'*{IF={if_result.if_value},{if_result.quartile}}*'
elif if_result.ambiguous:
record.if_annotation = '*{IF=待核驗}*'
else:
record.if_annotation = '*{IF=未檢出}*'
answer = compose_answer(
conclusion,
evidence_groups,
clickable_body_citations,
full_reference_list_with_if
)
```
9. 推薦最終交付模板
```markdown
結論:
……
證據等級:
直接證據:
- ……[[1. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
間接證據:
- ……[[2. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
未見直接證據:
- ……
機制歸納:
1. ……
2. ……
檢索邊界:
本輪主要檢索PubMed / PMC / BioC / bioRxiv;初篩基於metadata + abstract,僅對關鍵文獻進入全文複核。 IF 標註是基於公開可存取來源核查;無法高置信度符合時標為待核驗或未檢出。
完整文獻資訊列表:
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Q1}*
2. Wang X et al., **Journal Name** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=待核驗}*
```
相關技能
查看全部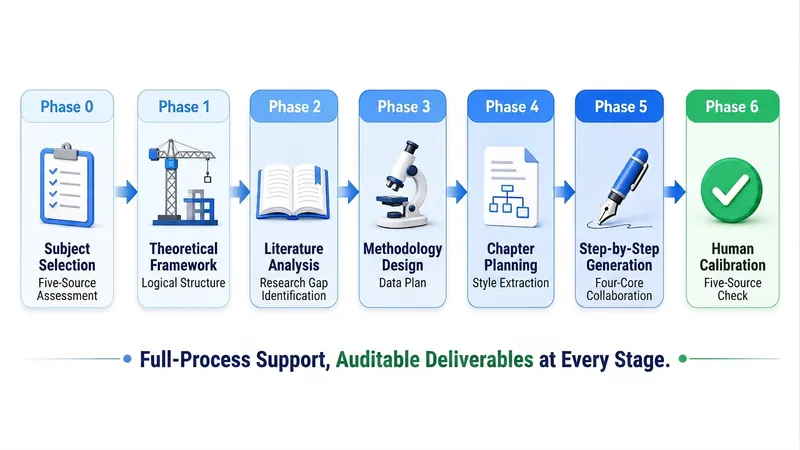
論文開題體檢器·五源準備度診斷
在你投入幾十小時寫論文之前,先花十分鐘做一次結構化體檢。 【這個技能只做一件事】 診斷,不代寫。它告訴你:選題能不能立住、材料夠不夠、缺什麼、去哪補、按什麼順序補,然後交給你一份可執行的補料清單和檢索式。它不會替你寫引言、綜述、方法或討論。 【四個環節】 1. 學科診斷:按 1A 人文藝術 / 1B 社會科學 / 2A 理工 / 2B 農醫生命四類歸位,載入對應的規範紅線;2B 類強制攔截倫理審查。 2. 選題體檢:從「勢·形·詞」三維查選題,判斷研究單位能否操作化、研究問題能否被回答、題目是否已被做爛。 3. 材料體檢:把你手上的文獻登記成 M1/M2… 材料庫,逐條核驗四要素(作者/年份/篇名/可核驗定位符),算出真實覆蓋率。 4. 缺口清單與檢索式:明確還缺幾篇什麼類型的文獻、缺哪一環證據,並給出可直接貼上進資料庫的檢索式(含關鍵詞布林組合、時間範圍、篩選標準)。 【什麼時候用它】(觸發詞) 「幫我體檢一下開題」「這個題能不能做」「我文獻夠不夠」「開題報告被打回了」「動筆前想先確認一下」——剛定方向還沒動筆的研究生;開題報告被打回來但不知道問題在哪的;手上攢了一堆文獻卻不確定夠不夠開工的;想在正式投入前先確認這個題值不值得做的。 【交付物】 一份《開題體檢報告》文檔 + 五源準備度評分卡(每檔都有行為化判定標準,不是模糊打分)+ 補料優先級清單 + 檢索式 + 一段存檔碼。存檔碼與《學術論文全流程撰寫系統 v4.0》通用,體檢完直接貼過去就能續寫,不用重新交代學科、選題、期刊。 【明確不做】 不寫正文,不生成參考文獻列表,不編造作者年份卷期頁碼 DOI。聯網檢索到的文獻一律標 ⚠️ 待核,必須由你自行核實後才能使用。本技能不承諾任何錄用或通過結果。
 研究
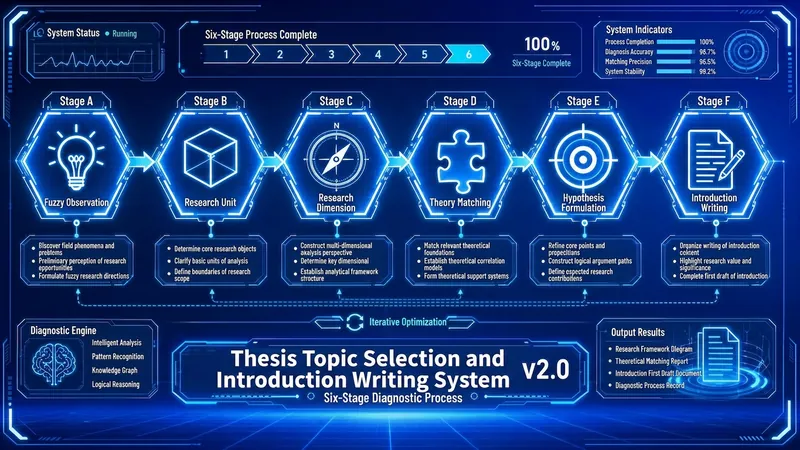
論文選題與引言撰寫系統 v3.2(五源×AFP·證據鏈門禁)
10 秒讀懂:把一句模糊觀察,推成能站穩的選題,再推成能過審的引言。全程只用你提供的真實材料,不編造一篇文獻。觸發詞:論文選題、選題、引言、研究空白、學術寫作、畢業論文開題、文獻綜述前的選題。適用:期刊論文 / 學位論文 / 會議論文 / 課程論文,人文社科與理工農醫全學科。3 分鐘可上手:先鎖定學科與起點 → 逐層成形選題 → 證據鏈硬門禁 → 分模組引言 → 棘輪定稿。 【與其他技能的分工】體檢在前、撰寫在後、潤色在最後。本技能負責中間那段:選題成形 + 引言初稿。它不做全流程正文(那是《學術論文全流程撰寫系統 v4.x》),也不做語言逐句打磨(那是《學術論文三軌潤色系統 v8.x》)。 【六道關口】1. 學科歸位:1A 人文藝術 / 1B 社會科學 / 2A 理工 / 2B 農醫生命四類歸位,載入對應規範紅線;2B 類倫理審查狀態強制過問。2. 階段定位:你處在模糊觀察、有單位缺角度、有對象缺理論、缺方法、缺觀點、還是只缺引言——從對應關口起跑,不從頭重來。3. 選題成形:研究單位 → 維度羅盤 → 理論視角 → 研究方法 → 研究觀點,逐層鎖定,每層鎖定前先判定上一層是否站穩。4. 證據鏈硬門禁:引言前強制把你的文獻登記成 M1/M2… 材料庫,逐條核驗作者/年份/篇名/定位符四要素;對話位不足 3 條,系統拒絕生成研究空白陳述——不是降級,是拒絕。5. 分模組生成:引言按倒金字塔五模組分塊產出,每塊必須標注引用編號 [Mn],無源不得成句。6. 棘輪定稿:只在已通過版本上加分,達標模組鎖定不再改動,評分只升不降。 【交付物】《[選題關鍵詞]·選題與引言》文件 + 逐句可追溯引用映射表 + ⚠️待核清單 + 一段 AFP 存檔碼。存檔碼與開題體檢器、v4.x 全流程、三軌潤色系統四方通用,換技能不用重新交代學科、選題、期刊、材料庫。 【明確不做】不編造作者、年份、卷期、頁碼、DOI;聯網檢索題錄一律標 ⚠️ 待核,須你核實後方可寫入參考文獻表;不承諾任何錄用或過審結果。署名與責任都是你的——請務必逐條核實引用與數據。
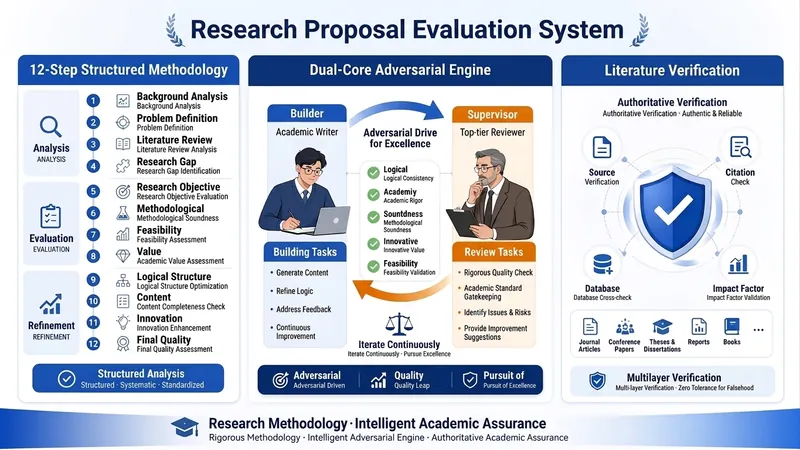
課題申請書創作、評審與潤色PRO V2.0
🎯 核心功能概述 這是一個專為國家社科、教育部、省級課題申請打造的智能評審與優化系統,模擬15年資深評審專家的思維模式,透過三大核心機制確保申請書的學術嚴謹性和競爭力。 🔧 三大核心機制 1️⃣ 12步結構化方法論 完整覆蓋課題申請書評審的全生命週期: Phase 1-3:基礎診斷 - 公告深度解析(資助導向、評審標準、申請要求) - 交叉學科類型判斷(8種類型精準識別) - 研究GAP五維度識別(理論/方法/實證/政策/技術) Phase 4-7:核心要素評審 - 研究問題TMAQ模型分析(理論/方法/思路/問題四維) - 研究目標SMART原則檢驗 - 研究內容框架完整性評估 - 研究思路類型匹配(6種類型) Phase 8-10:深度品質提升 - 重難點精準提煉(區分標準+突破路徑) - 創新點7維度挖掘 - 可行性7維度論證 Phase 11-12:整體優化 - 9維度品質檢測(學術嚴謹性、創新性、可行性等) - 綜合優化建議與最終報告 2️⃣ 雙核對抗機制(Builder vs Supervisor) 工作原理: - Builder(學術寫手):基於用戶材料生成優化方案 - Supervisor(頂刊審稿人):以最嚴苛標準挑戰Builder的方案 - 對抗迭代:透過3輪對抗確保方案經得起推敲 應用場景: - 創新點挖掘時:Builder提出創新點 → Supervisor質疑其新穎性 → 迭代優化 - 可行性論證時:Builder設計方案 → Supervisor挑戰其可行性 → 補充論證 - 文獻引用時:Builder引用文獻 → Supervisor驗證真實性 → 確保學術規範 3️⃣ 文獻真實性驗證機制 兩種工作模式: 模式A:佔位符模式(預設) - 使用 [文獻佔位符-001] 等標記代替具體文獻 - 輸出《文獻需求清單》,明確每個佔位符的檢索要求 - 用戶自行檢索後填入真實文獻 模式B:即時驗證模式 - 調用 Google Scholar 即時驗證文獻真實性 - 生成《文獻驗證報告》(真實性/相關性/權威性評分) - 確保每條引用都可追溯 防止AI幻覺: - 禁止憑空捏造作者、期刊、DOI - 所有文獻必須經過驗證或標記為佔位符 - 保障學術誠信底線 💡 核心價值與適用場景 ✅ 解決的核心痛點 1. 學術不嚴謹:AI生成內容常出現虛假文獻、邏輯漏洞 2. 創新性不足:難以挖掘真正的學術創新點 3. 可行性薄弱:研究方案缺乏系統論證 4. 交叉學科難:跨學科選題容易「兩頭不靠」 🎓 適用用戶 - 高校教師(社科、教育、人文學科) - 科研人員(申請國家級、省部級課題) - 學術團隊(需要系統化評審流程) 📋 典型使用流程 1. 輸入:上傳課題公告 + 申請書草稿 2. 評審:系統執行12步結構化分析 3. 對抗:雙核機制迭代優化關鍵部分 4. 驗證:文獻真實性檢查 5. 輸出:完整評審報告 + 優化建議 + 文獻清單 🔍 與傳統評審的區別 | 維度 | 傳統人工評審 | 專家評審系統 | |------|------------|---------| | 評審深度 | 依賴個人經驗 | 12步結構化+9維質檢 | | 學術嚴謹性 | 難以全面核查 | 文獻驗證+雙核對抗 | | 創新性挖掘 | 主觀判斷 | 7維度系統分析 | | 可行性論證 | 經驗驅動 | 7維度逐項論證 | | 一致性 | 因人而異 | 標準化流程 | | 效率 | 數天到數週 | 1-2小時完成初評 | 這個系統的核心優勢在於:將15年資深評審專家的隱性知識顯性化、結構化、可複製化,讓每位使用者都能獲得頂級專家水準的評審服務。
資訊
- 版本
- v5
- 更新時間
- 執行點數
- 依實際用量
- 模型
- Claude Sonnet 4.5
- 使用能力
- 網路研究