Transcripción de Entrevistas
Conserva borradores, tiempos y dudas, entrega TXT, JSON y SRT
Transcripción de Entrevistas
Conserva borradores, tiempos y dudas, entrega TXT, JSON y SRT
Vista previa
Descripción
Adecuado para quienes necesitan organizar grabaciones autorizadas de entrevistas, reuniones o clases. Proporciona el archivo original, el idioma, el propósito, la transcripción existente o un mapeo temporal de hablantes confiables; no se puede confirmar la identidad solo por la voz ni los guiones se tratarán como lo que realmente se escucha. Conserva el audio original y el hash -> lee duración y pistas -> ASR real -> organiza por cronología real -> etiqueta hablantes de forma anónima con respaldo -> revisa números, negaciones, nombres y dudas escuchando el original -> entrega TXT, JSON, SRT y notas de cobertura. Borradores, revisión y resúmenes van por separado; lo que no se entienda queda pendiente de revisión sin rellenar palabras a la fuerza. Sin herramientas de audio/ASR, se indica claramente que no se transcribió. Instrucciones y asistente local integrado: Python3, FFmpeg/FFprobe, faster-whisper y caché small configurada, CPU/int8, local_files_only, sin descarga automática de pesos. Si el speaker-map proporciona inicios, fines y etiquetas anónimas, se transcribe según el segmento y se mapea el tiempo; sin mapeo, la marca de tiempo es desconocida. El asistente no realiza diarización automática de voz ni identificación de identidad; el paquete no incluye pesos, cuentas ni claves. Cuatro casos de prueba de oratoria personal en chino, entrevistas bilingües, explicación de clases en inglés y reuniones bilingües en chino, con un audio original de unos 40,875 segundos. El audio final utiliza la versión fija local de Kokoro-82M etiquetada con Apache-2.0 (zf_xiaobei, zm_yunjian, af_heart), sin ser personas reales ni clonación de voz; no se distribuyen modelos, voces ni audios de ejemplo con la instalación. Los cuatro casos generan TXT/JSON/SRT con ASR real; los hablantes provienen del tiempo de voz sintético proporcionado, no de diarización automática. Sigue siendo un borrador automático; la divergencia entre la "salida" del ASR y el "borrador" del guion en el segundo caso queda pendiente de escucha para confirmación, sin modificar lo dicho originalmente. Las formas de onda se basan en picos PCM reales, no son ondas decorativas. Se recomienda GPT para organizar el texto y el ASR depende de las herramientas reales; no se llama localmente a la API de transcripción de OpenAI ni se ejecutan CLI externas. El avatar independiente es un concepto visual de ImageGen, la herramienta no devuelve modelos ni se afirma que sea Image2. Las herramientas de YouMind, la caché, las descargas y la vinculación de modelos no consumen créditos de prueba; se debe confirmar según el entorno real. No se garantiza la ejecución sin dependencias de la transcripción y organización de hablantes. Los 299 créditos corresponden al precio de instalación e incluyen modelos, API o servicios de terceros, sin compras automáticas ni subidas de pistas de audio desconocidas a servicios externos. No se promete cero errores, reconocimiento perfecto de acentos, ruido o solapamientos, identificación judicial o de identidad, eficacia temporal ni resultados comerciales. Queda pendiente la revisión de audio independiente, sin publicitar transcripciones verificadas.
Recomendado por
Dancang
Por qué recomendamos esta habilidad
Esta habilidad destaca porque no hace pasar las transcripciones automáticas por definitivas: conserva las pruebas originales, los rangos de tiempo y las bases de revisión de forma íntegra, distingue con cautela el origen de los oradores y señala claramente los pasajes poco claros, superpuestos o sin verificar para entregar al final archivos TXT, JSON y SRT trazables.
Ideal para
Ideal para organizar grabaciones de entrevistas, reuniones o clases con control de transcripción y marcas de incertidumbre.
Cómo usar este Skill
Proporciona los datos
Proporciona el audio o vídeo de entrevistas, reuniones, clases o grabaciones, el idioma, el propósito y el alcance; también puedes adjuntar un mapeo temporal de hablantes.
Ejecuta el Skill
Transcribe el audio y organiza marcas de tiempo reales; etiqueta hablantes anónimos con el mapeo proporcionado, conserva borradores y marca dudas, solapamientos y pasajes no verificados.
Revisa el resultado
Obtén archivos de transcripción en TXT, JSON y SRT con marcas de tiempo y notas de origen, además del alcance del procesamiento, contenido no verificado y notas de revisión.
Habilidades relacionadas
Ver todo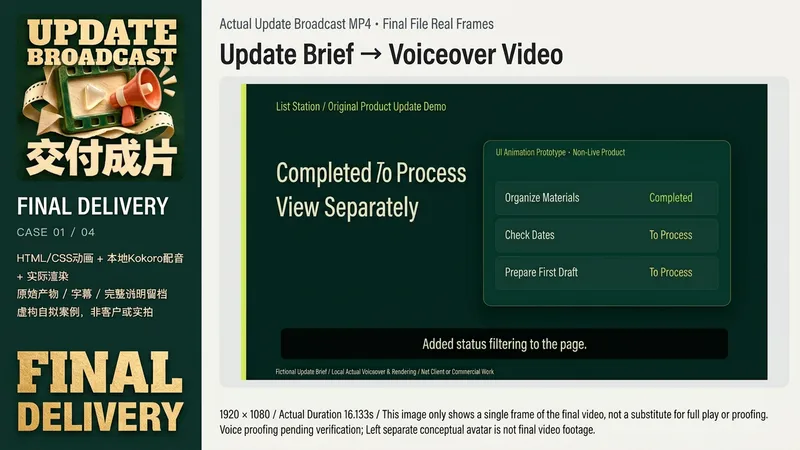 Vídeo
Actualización de Productos
適合需要說明產品變更的創作者、小團隊與教學者。提供真實更新清單、已完成/計劃狀態、授權截圖或原型、目標觀眾、畫幅和原音;缺少的日期、效果與客戶數據不會補造。只有想法時可做顯著標明的虛構產品示意。 輸入簡報 → 核對事實與權限 → 簡明腳本和鏡頭 → 實際配音/接收原音 → 按真實音頻安排字幕和畫面 → 實際渲染 → 播放、視覺與聽校 → 交付MP4、SRT、腳本及實際生成的源工程。真實介面只排版原件,不交給生圖重繪。沒有渲染工具時明確未成片。 本地四例為原創虛構產品:清單篩選、日曆預覽、導出前核對、課程進度。實際Kokoro-82M固定版本、zf_xiaobei聲音本地合成,HyperFrames 0.8.174與Chrome/FFmpeg實際輸出兩份1920×1080、一份1080×1080、一份1080×1920視頻,約16.1—18.5秒;字幕按分句音頻實際樣本時長安排,不宣稱逐字強制對齊。它們不是真實上線軟件、客戶或學習效果。 文字規劃推薦GPT。核心需要真實文件、動畫/視頻渲染、FFmpeg/FFprobe和可用合法原音/TTS。指令附完整原創本地渲染助手,僅檢查/渲染已有HyperFrames項目,不自動生成UI或配音;需要自行配置實際Node、HyperFrames CLI與瀏覽器路徑。圖像工具僅作可選原創輔助;獨立頭像由ImageGen生成,型號未返回,不是案例幀。平台GPT-6.1 Sol只是可選設置,不保證與本地工具或型號相同。YouMind端未耗積分測試,不保證安裝後直接具備這些工具。 299積分僅為安裝價,不含模型、TTS、字體、素材、第三方服務或托管。不自動克隆聲音、購買服務或公開到其他渠道;不保證任意輸入、零錯誤、傳播、審核或商業效果。當前本地案例已真實渲染和播放,音軌獨立聽校仍待補;不會當作全部質量驗收完成。
 Escribir
Notas a Artículo con Tabla
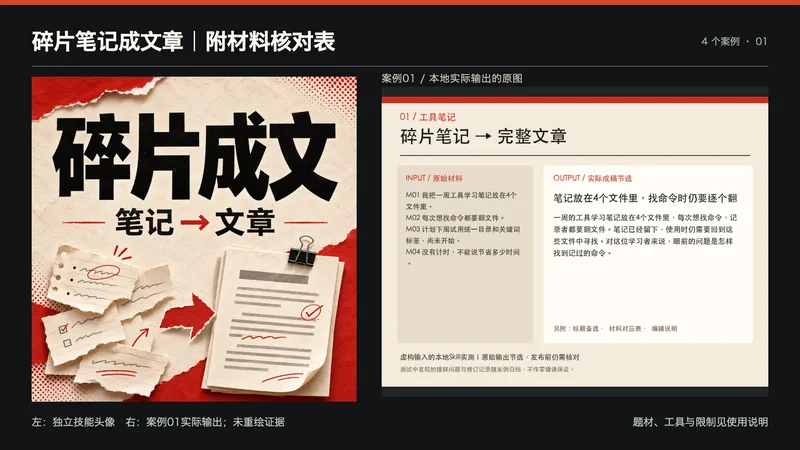
适用人群:已有零散笔记、采访文字或口述转写,希望整理成文章的创作者。 你需要提供:原始材料、目标读者、用途、篇幅和希望保留的表达。 如何处理:给材料编号,区分事实陈述、观点与计划;围绕一条主线成稿,再回查数字、说话人和证据缺口。 最终交付:3个标题备选、完整中文正文、材料对应表、待确认与编辑说明。默认直接输出可复制文字,文件保存取决于运行环境。 使用步骤:粘贴材料并说明读者与字数;运行后先阅读文章,再按对应表核对材料,修订后使用。核心功能仅需文字模型,推荐GPT;当前YouMind实测选择GPT-6.1 Sol,实际效果取决于运行配置。 四张展示图为虚构输入的本地Skill真实测试输出节选,经排版呈现,不是真实客户案例;测试发现的措辞问题已归档,文章仍需人工核对。平台已完成1个文字案例实测,不代表所有场景稳定成功。 不适用:凭空生成真实采访、未经提供的个人经历、替代事实核查或自动发布。材料不足会缩短内容并列出缺口,不以扩写补造事实。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
 Página web
文章转交互知识网页|逐屏讲解与原文定位
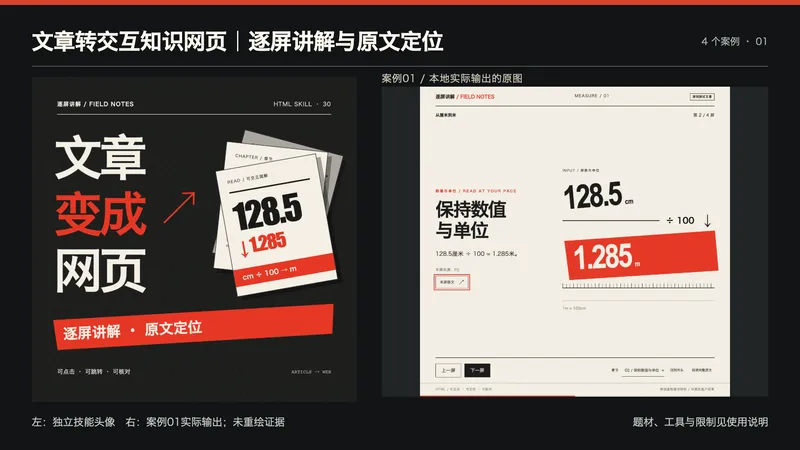
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
Información
- Versión
- v2
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático
- Casos de uso
- Escritura y contenido
- Qué obtendrás
- DocumentoDatos
