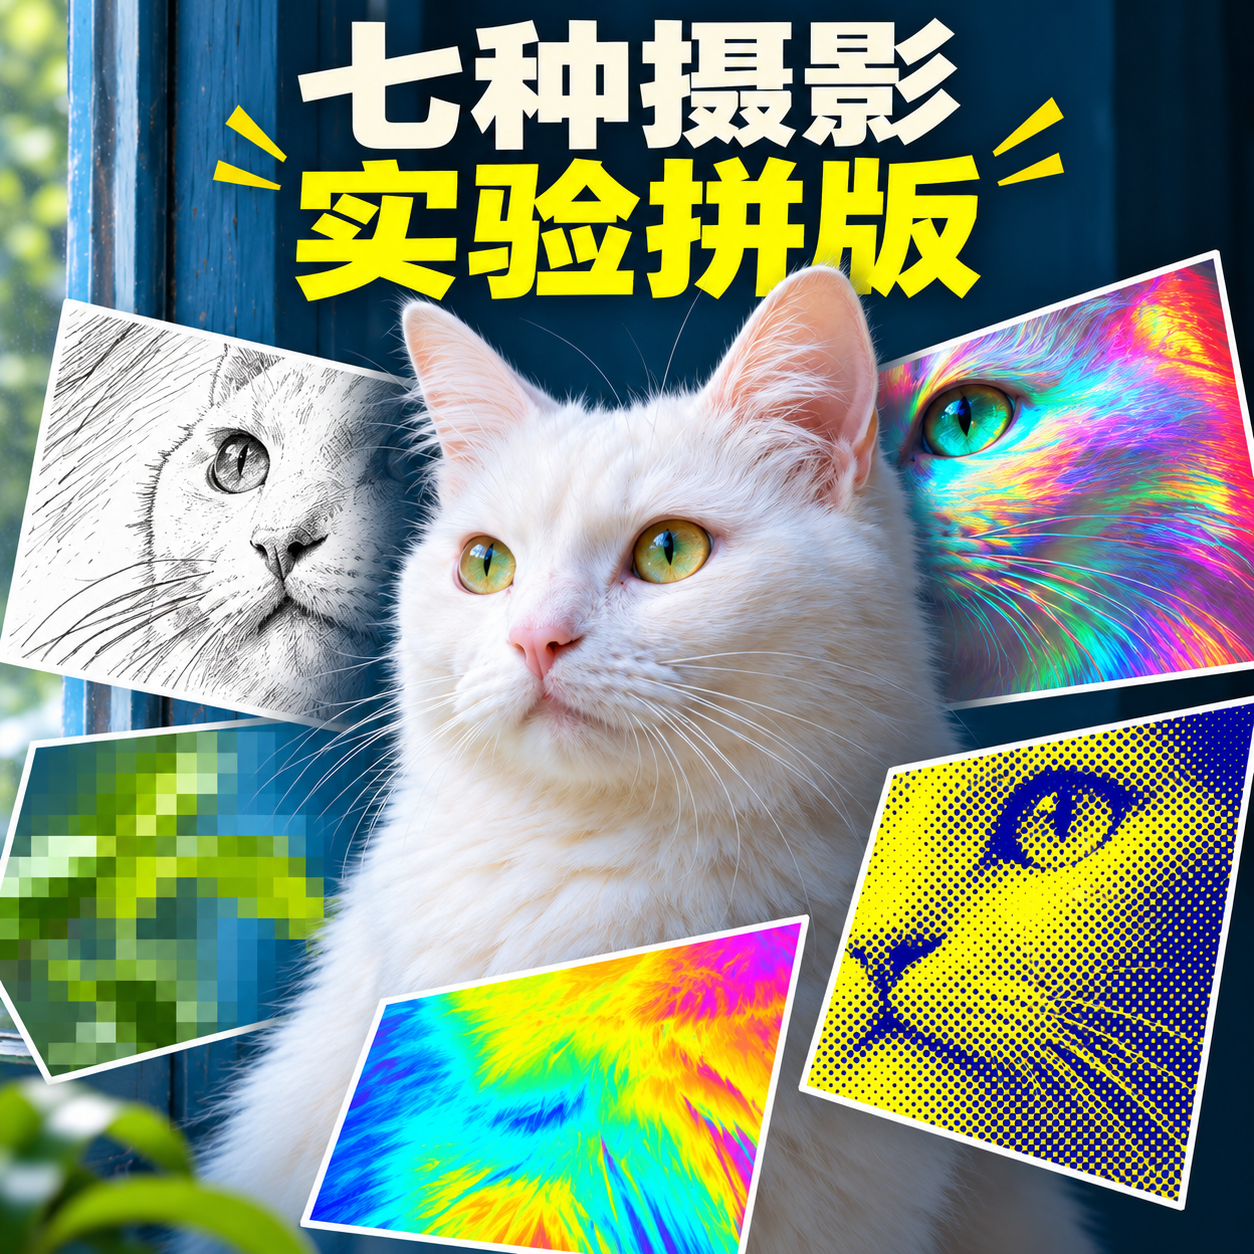
Experimentos de fotografía
Un tema y siete tarjetas de efectos
Experimentos de fotografía
Un tema y siete tarjetas de efectos
Vista previa
Descripción
适合研究照片风格方向、制作视觉练习与内容配图的创作者。提供文字主题或有使用权且可读取的照片、要保留的主体、配色与画幅;默认3:4上下双联。 上格自然摄影,下格保留同一主体作为底,组织七张编号细节实验卡:01细条纹,02灰度纸纹理,03墨线素描,04青红错位,05像素块,06虹彩,07双色网点。卡片可放大主体的可见细节,便于比较不同视觉方向;不是底图同坐标滤镜,不是七张独立成图。 技能列出每张卡的局部和效果,实际调用图片工具生成,核对七个编号、视觉差异、主体和布局,再按具体问题修订。交付一张实际拼版、效果清单和检查说明,需要时附提示词。没有图像工具时成图未完成。 四张最终展示为2026年11月12日本地按修订后的技能重新生成的虚构AI案例:耳机女性、白猫、花瓶、拱廊;不是实拍、客户或算法处理结果。首轮要求同坐标对齐未达成,已保留失败记录并改为明确的局部细节卡,再跑四例。最终每图可见01至07七卡,各效果不同,但卡片细节、花形、构图和上下主体大小有变化,不保证精确身份或结构一致。头像参考自有首轮白猫案例独立生成,为概念展示,不是第五个独立案例或严格七窗验证图。 效果由图像模型视觉模拟,不声称执行了七种真实滤镜算法、可量化参数、无损处理或分层可编辑文件。 文字规划推荐GPT,成图依赖实际可用的图像生成/编辑工具。本地使用内置image_gen,工具未返回具体模型ID,不宣称绑定Image2。照片编辑与YouMind运行未实测,不能保证身份、商品结构、文字或跨图完全一致。无图像工具时明确成图未完成。299积分为技能安装价,不包含平台模型或第三方服务费;不交付PSD/矢量源文件,不自动发布或购买。
Recomendado por
Dancang
Por qué recomendamos esta habilidad
Combina fotografía natural y siete efectos experimentales en un diseño vertical para comparar diferencias visuales de un vistazo de forma fiable.
Ideal para
Ideal para quienes necesitan comparar estilos fotográficos, crear ejercicios visuales o preparar imágenes para contenidos.
Cómo usar este Skill
Proporciona los datos
Proporcione una foto o tema de texto con derechos de uso, indicando el sujeto a conservar, título, gama de colores, formato y uso.
Ejecuta el Skill
El sistema organiza el mismo sujeto en un diseño vertical doble y genera siete tarjetas numeradas con experimentos visuales detallados para su comparación.
Revisa el resultado
Obtenga una imagen de composición final, una lista de los siete efectos y notas de verificación. Requiere herramientas de imagen para completarse.
Habilidades relacionadas
Ver todo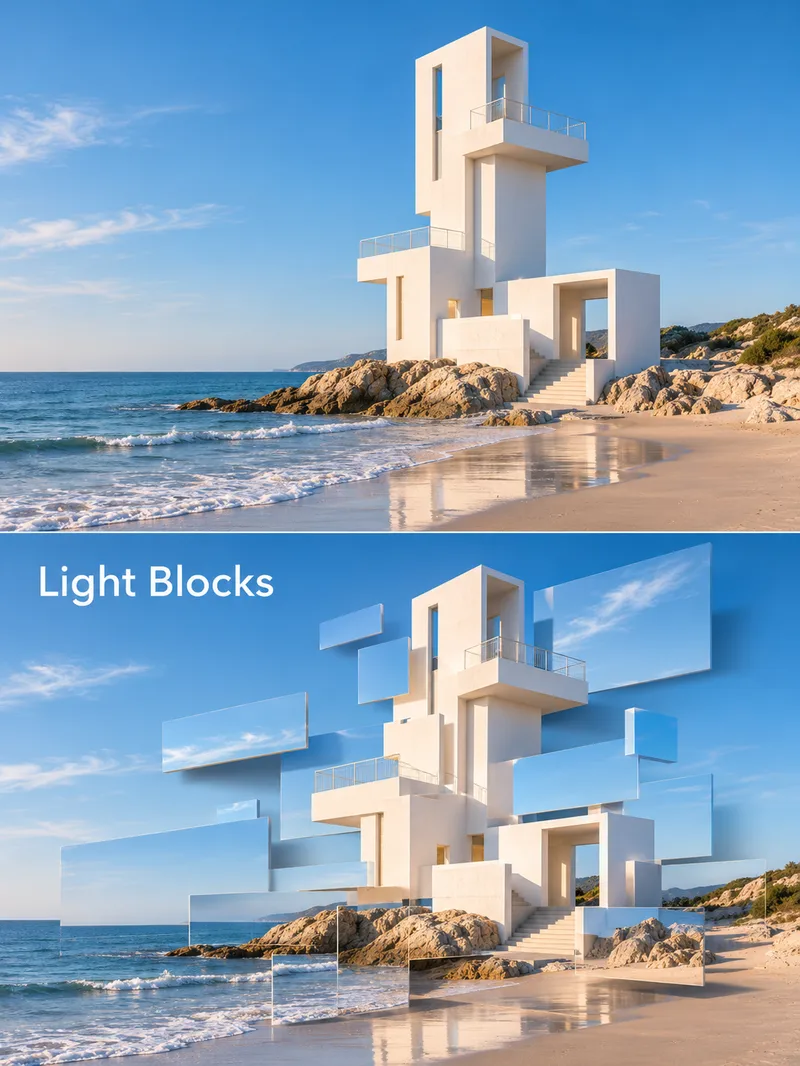 Imagen
Póster de Espacio Fragmentado
Ideal para creadores que elaboran pósteres visuales de arquitectura, naturalezas muertas o retratos. Proporciona un tema de texto o una foto con derechos y legible, y puedes complementar con un título corto, paleta de colores, uso y formato. El skill primero organiza el contorno del sujeto y las partes que deben conservarse, planificando un díptico vertical: la sección superior muestra una fotografía natural y la inferior convierte parte del contenido fotográfico en fragmentos rectangulares flotantes y desplazados, expresando capas de profundidad mediante bordes, sombras sutiles y perspectiva; se reducen los fragmentos cerca de los rasgos faciales en los retratos. Tras invocar las herramientas de imagen disponibles, se verifican el sujeto, los fragmentos, el texto y el recorte, corrigiendo si es necesario. Se entrega un póster real, un título y notas de revisión, acompañados de los pronpts completos cuando sea necesario. Uso: indique el tema y el título, revise ambas secciones, los accesorios y el texto tras la generación, y luego proponga modificaciones específicas. Las cuatro imágenes de muestra son casos de IA ficticios generados localmente el 12 de noviembre de 2026 según el método visual del skill: torre blanca junto al mar, pabellón amarillo, florero de terracota roja y una mujer adulta. No son fotografías reales, registros arquitectónicos reales ni proyectos de clientes. Los cuatro casos presentan fragmentos rectangulares fotográficos y capas espaciales, aunque la torre blanca y el retrato tienen más fragmentos de fondo y el sujeto no se descompone por completo; los detalles de cada sección varían. El avatar se generó por separado basándose en el caso del jarrón rojo para mostrar claramente el efecto y un título en chino, y no constituye un quinto caso independiente. La planificación del texto puede utilizar GPT, pero la obtención de imágenes requiere herramientas de generación o edición de imágenes operativas; con el uso local de image_gen integrado, dado que la herramienta no devuelve un ID de modelo específico, no se puede afirmar que esté vinculada a Image2. La edición de fotos y la ejecución en YouMind no se han probado en la práctica, por lo que no se puede garantizar una consistencia exacta en la identidad de los personajes, la estructura del producto, el texto, el fondo o entre las secciones. Si no se dispone de herramientas de imagen, la entrega de la imagen quedará incompleta. Los 299 créditos corresponden al precio de instalación del skill y no incluyen los modelos de la plataforma ni tarifas de servicios de terceros; no se entregan archivos PSD editables, archivos vectoriales ni parámetros ópticos reales.
 Imagen
Póster Retro Tipográfico
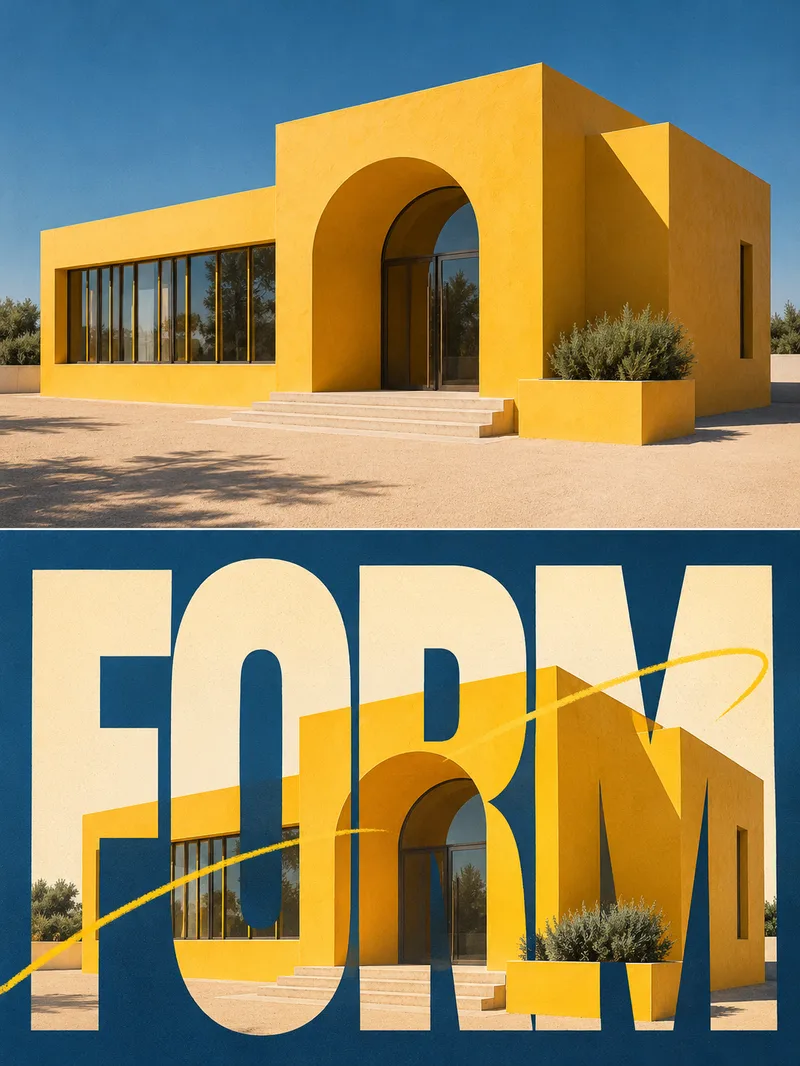
Ideal para creadores que elaboran gráficos para redes sociales, temas deportivos y pósteres editoriales. Proporciona un tema textual o una foto con derechos de uso, una palabra corta en inglés, la paleta de colores y el propósito; se pueden probar personas, mascotas y edificios. La habilidad verifica primero el sujeto y los elementos, planificando una estructura vertical de 3:4: el panel superior muestra fotografía natural y el inferior utiliza tipografía en negrita grande para estructurar la composición, integrando texturas fotográficas en las letras y permitiendo que partes del sujeto sobresalgan frente al texto; se acompaña de un estilo de papel blanco cálido, un fondo de color principal y líneas de movimiento sutiles, invocando luego herramientas de imagen reales para generar y revisar paso a paso. Entrega un póster real, un título copiable y notas de verificación, incluyendo los prompts completos cuando sea necesario. Uso: describe el tema, la palabra corta y el formato; revisa el sujeto, los elementos, la ortografía y las oclusiones, luego especifica partes concretas para modificar. Si no hay herramientas de imagen, el resultado estará incompleto y no se usarán solo prompts en su lugar. Las cuatro imágenes de muestra son casos de IA ficticios generados localmente el 12 de noviembre de 2026 según el flujo final de la habilidad: PLAY de tenis, GO con golden retriever, FORM de arquitectura y MOVE de bailarina; no son fotos reales, registros arquitectónicos ni resultados de clientes. Los cuatro casos presentan integración de texto y capas de profundidad, la máscara de letras oculta parcialmente el cuerpo o la arquitectura, y hay variaciones en posturas y texturas. La planificación del texto recomienda GPT, y la generación de imágenes requiere herramientas disponibles en el entorno actual. Las integraciones no han sido testeadas por completo y no se entregan archivos PSD o vectoriales.
 Imagen
Póster de Escala Gigante
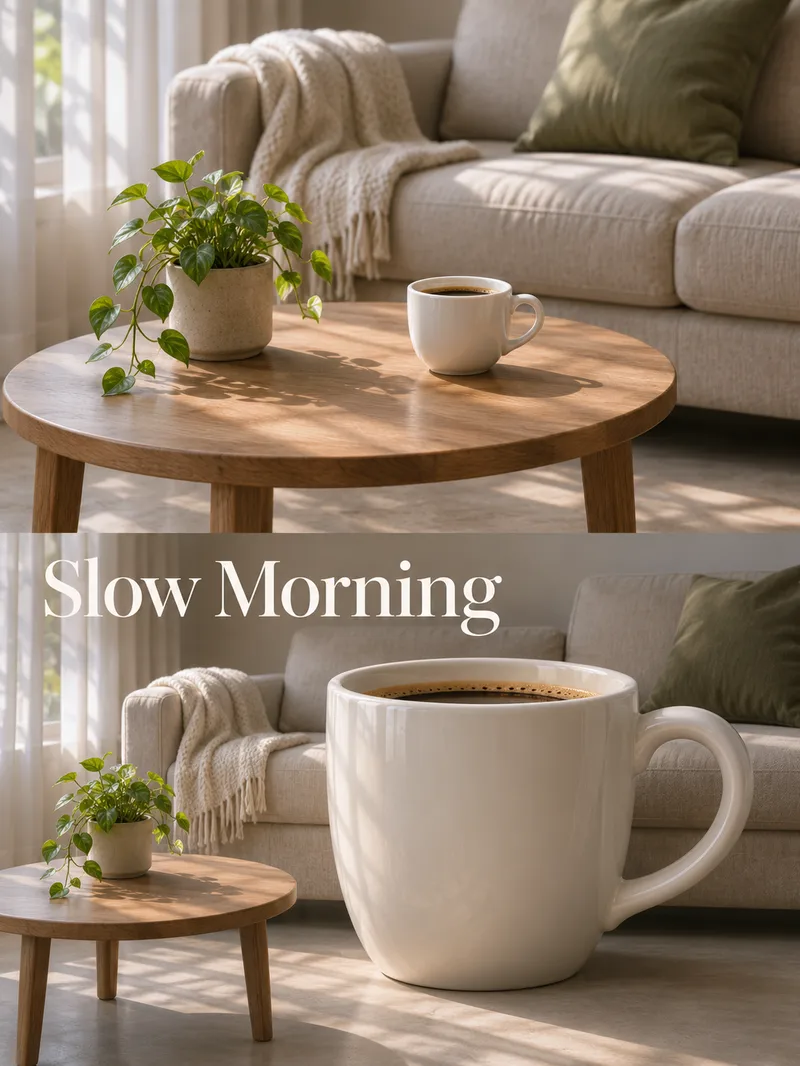
Ideal para creadores que desean diseñar imágenes surrealistas para redes sociales, pósteres visuales o ejercicios creativos. Proporciona un tema de texto o una foto legible con derechos de uso, especificando claramente un objeto a amplificar, un título corto, una escena y un formato. Si no se especifica, confirma el accesorio principal para evitar errores. La habilidad analiza primero el sujeto original, la referencia de escala y la dirección de la luz para planificar un díptico vertical: la sección superior muestra una fotografía natural y la inferior exagera el objeto designado, ajustando el agarre, el soporte en el suelo y las sombras de contacto, para luego invocar la herramienta de imagen actual y revisar el resultado paso a paso. Se entrega el póster real, el título y una explicación de verificación, adjuntando los mensajes completos cuando sea necesario. Uso: introduce el tema y el objeto único a amplificar; tras la generación, revisa las estructuras como manos, asas de tazas o mangos de paraguas, el soporte en el suelo y el título, y edita según los problemas específicos. Es una creación de imagen surrealista y no debe usarse como registro de tamaño o fotografía real. Las cuatro imágenes de muestra son casos de IA ficticios generados localmente el 12 de noviembre de 2026 según el método final de la habilidad: naranja gigante, cámara, taza de café y paraguas azul; no son clientes, fotos reales, funciones de productos reales ni registros arquitectónicos. Los cuatro objetivos muestran un contraste claro de escala, pero las posturas de los personajes, los detalles de la cámara, las proporciones de muebles y escenas, y las áreas superior e inferior variarán; no se garantiza que cada píxel del objetivo cambie. El avatar de referencia se genera por separado a partir del caso de la naranja gigante, y el diseño de la pantalla de efectos y el título en chino se disponen de forma independiente, no siendo un quinto caso independiente. Se recomienda GPT para la planificación de texto, y la generación de imágenes depende de herramientas de generación o edición de imágenes disponibles. El uso local emplea el image_gen integrado, la herramienta no devuelve un ID de modelo específico y no afirma estar vinculada a Image2. La edición de fotos y la ejecución en YouMind no se han probado en la práctica, por lo que no se puede garantizar una consistencia total en identidad, estructura de productos, texto o entre imágenes. Si no hay herramientas de imagen, se indicará claramente que la generación no está completa. Los 299 créditos corresponden al precio de instalación de la habilidad y no incluyen los modelos de la plataforma ni las tarifas de servicios de terceros; no se entregan archivos fuente PSD o vectoriales, ni se publica o compra automáticamente.
Información
- Versión
- v2
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático
- Casos de uso
- Imágenes y diseñoAprendizaje y educación
- Qué obtendrás
- InformeImagenPrompt
- Estilos visuales
- Collage
