Nous avons déployé les Cerebras Wafer Scale Engines avec des GPU pour fournir des tokens ultra-rapides à grande échelle
Le monde est avide de tokens ultra-rapides. En 2026, Cerebras a constaté une demande insatiable en matière d'inférence rapide, tant sur notre cloud d'inférence que via nos partenaires. Pour y répondre, nous avons commencé à développer l'inférence désagrégée : les GPU prennent en charge le traitement des prompts (prefill) et les systèmes Cerebras gèrent la génération des sorties (decode).
Cette solution est désormais en production et fournit cinq fois plus de tokens par mégawatt, tout en conservant les vitesses ultra-rapides caractéristiques de Cerebras.
Nous pouvons désormais servir davantage de tokens ultra-rapides via le Cerebras Inference Cloud afin de répondre à la demande du marché. Les partenaires d'infrastructure peuvent également exploiter la solution désagrégée de Cerebras pour générer plus de tokens ultra-rapides dans leurs propres datacenters.
Parallèlement à notre CS-4 récemment annoncé, à l'augmentation spectaculaire de notre capacité de production et aux 700 MW de capacité de datacenter prévus, l'inférence désagrégée permettra à Cerebras et à ses partenaires de fournir bien plus de tokens ultra-rapides en 2027 et au-delà. Dans cet article, nous abordons :
- Le besoin accru de capacité d'inférence ultra-rapide
- Pourquoi Cerebras dispose d'un avantage pour le décodage
- Les résultats en production de l'inférence désagrégée de Cerebras
- L'inférence désagrégée de Cerebras pour les partenaires d'infrastructure
Le besoin accru de capacité d'inférence rapide
Les applications agentiques comme Muse, Copilot et Codex se développent rapidement et nécessitent une inférence hautement interactive pour maintenir l'engagement des utilisateurs. Pour répondre à la demande croissante de ces applications dans un contexte de contraintes énergétiques, notre secteur doit fournir nettement plus de capacité d'inférence par mégawatt, à des vitesses de réponse qui rendent ces applications véritablement utiles.

Sources : Goldman Sachs Research, « AI Agents Forecast to Boost Tech Cash Flow as Usage Soars », 20 mai 2026 ; estimations de la capacité des datacenters de Goldman Sachs, telles que rapportées par Investing.com
C'est pourquoi Cerebras a investi dans la désagrégation. Associer un accélérateur de prefill pour le traitement des prompts au système Cerebras pour la génération des réponses augmente le débit de tokens par mégawatt tout en préservant les vitesses de génération ultra-rapides de Cerebras. Pour les fournisseurs d'inférence, cela signifie une plus grande capacité à servir leurs clients et un potentiel de revenus supérieur pour un même budget énergétique.
Pourquoi Cerebras dispose d'un avantage pour le décodage
Une requête d'inférence comporte deux étapes principales. Le traitement du prompt, appelé prefill, traite l'entrée et produit un état intermédiaire du modèle. La génération de la réponse, appelée décodage (decode), utilise cet état pour produire les tokens de sortie. Il existe de nombreuses façons de répartir la charge de travail d'inférence, notamment les approches draft-target ou attention-FFN, mais séparer le prefill du décodage présente un avantage unique lorsque l'objectif est une inférence hautement interactive.

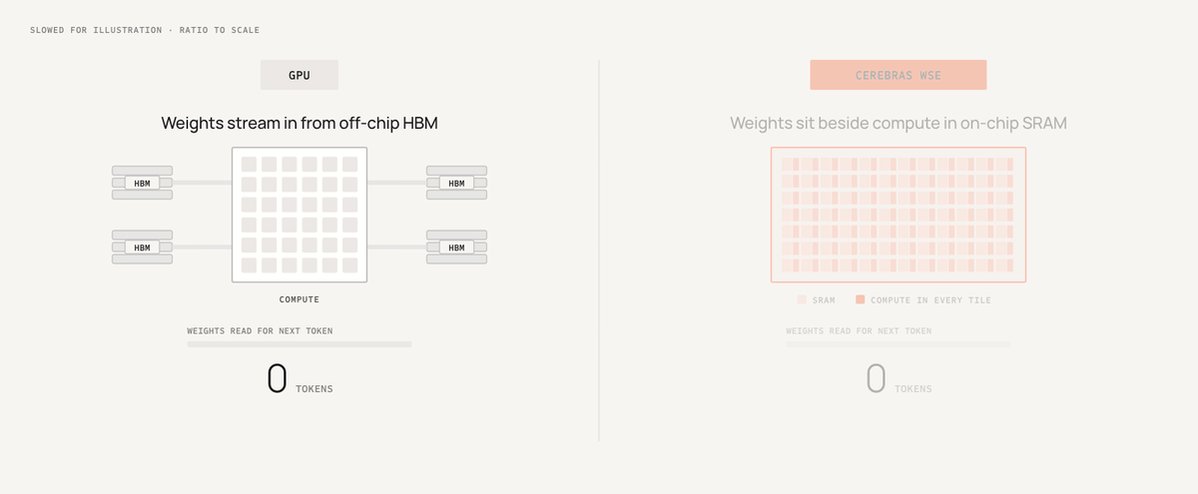
Le décodage est autorégressif. Cela signifie que le modèle génère un token à la fois, en utilisant chaque token généré comme entrée pour produire le suivant. Chaque étape implique de relire les données du modèle depuis la mémoire, ce qui rend la bande passante mémoire cruciale. Dans le domaine de l'inférence ultra-rapide, les puces centrées sur la SRAM ont un avantage car elles peuvent conserver ces données directement sur la puce et les lire beaucoup plus rapidement. Cerebras pousse cette approche à l'échelle du wafer, avec des dizaines de gigaoctets de SRAM et des dizaines de pétaoctets par seconde de bande passante mémoire sur une seule puce — soit 350 fois la capacité SRAM et 5 400 fois la bande passante mémoire d'un GPU GB300 classique. Cela permet au système Cerebras d'intégrer davantage de requêtes simultanées et de couches de modèle directement sur la puce, permettant aux CS-3, CS-4 et CS-5 d'atteindre des vitesses ultra-rapides avec un débit très attractif.
GIF
Résultats en production de l'inférence désagrégée de Cerebras
Associer les systèmes Cerebras, optimisés pour un décodage ultra-rapide, à des accélérateurs parfaitement adaptés aux besoins de calcul du prefill, comme les GPU AMD Instinct, permet de fournir une quantité considérable d'inférence ultra-rapide à grande échelle. Dans un déploiement en production sur le Cerebras Inference Cloud, les GPU AMD Instinct traitent les prompts et les systèmes Cerebras CS-3 génèrent les réponses. Transférer le traitement des prompts vers les GPU permet aux systèmes Cerebras de consacrer toute leur capacité de service à la génération des réponses. Lors de notre déploiement en production mesuré, cette combinaison a offert un débit par mégawatt 5 fois supérieur à celui d'une configuration composée uniquement de CS-3, sans aucune perte de vitesse de génération de tokens.

Source : point de terminaison partagé GPT-OSS-120B du 14 novembre via le Cerebras Inference Cloud, débit par mégawatt avant et après l'activation de l'inférence désagrégée, normalisé par rapport à la référence de l'inférence agrégée (1×).
Nous prévoyons de déployer largement l'inférence désagrégée sur plusieurs centaines de mégawatts dans le Cerebras Inference Cloud ainsi que chez nos partenaires d'ici fin 2027. Notre objectif est d'accroître la capacité d'inférence ultra-rapide mise à la disposition de nos clients.
L'inférence désagrégée de Cerebras pour les partenaires d'infrastructure
La solution d'inférence désagrégée de Cerebras a également été conçue pour être adoptée par nos partenaires. Les partenaires d'infrastructure peuvent déployer des clusters d'inférence désagrégée basés sur l'architecture de référence fournie par Cerebras, en hébergeant côte à côte les accélérateurs de prefill de leur choix et les systèmes Cerebras au sein d'un réseau unifié. Pour l'intégration logicielle, les partenaires peuvent opter pour la pile logicielle désagrégée de bout en bout de Cerebras ou pour un SDK dédié uniquement au décodage.
- La pile logicielle désagrégée de bout en bout convient particulièrement aux partenaires qui souhaitent accélérer leur mise sur le marché. Elle comprend :
- Un framework d'inférence désagrégée pour router les requêtes entre les pools de prefill et de décodage, et gérer la capacité ainsi que l'état de santé des réplicas.
- Un moteur de prefill pour traiter les prompts à l'aide de moteurs d'inférence open source comme vLLM ou SGLang.
- Un moteur de décodage Cerebras pour la génération des réponses sur les systèmes Cerebras.
- Le logiciel KV Portal, une interface permettant de transférer l'état intermédiaire du modèle, y compris les caches clé-valeur, entre les moteurs de prefill et de décodage via RDMA.
Le SDK dédié uniquement au décodage convient mieux aux partenaires qui privilégient le contrôle. Avec ce SDK, les partenaires peuvent associer leur propre framework d'inférence et leur moteur de prefill au moteur de décodage Cerebras et au logiciel KV Portal. De plus, ce SDK fournit des outils de développement tels qu'un réplica de décodage Cerebras simulé et une intégration de référence vers un framework d'inférence désagrégée et un moteur de prefill open source.

Des partenaires en accès anticipé, dont Amazon Web Services, Fireworks AI, Gimlet Labs et General Compute, bénéficient déjà de la solution de désagrégation de Cerebras pour leurs déploiements. Nous élargissons désormais cet accès à d'autres partenaires souhaitant proposer une inférence ultra-rapide à grande échelle à leurs clients.
Pour discuter plus en détail des résultats, des solutions ou des opportunités de déploiement, contactez-nous ici.


