« Le monde est tout ce qui est le cas. » — Ludwig Wittgenstein,
Tractatus Logico-Philosophicus
, 1921
Le monde n'est pas fait de mots.
Dans un essai précédent, nous avons soutenu que l'intelligence spatiale est la prochaine frontière de l'IA et que les modèles du monde sont la voie pour y parvenir. Ici, l'équipe de World Labs et moi souhaitons aller un cran plus loin : parmi les nombreuses choses actuellement construites et appelées « modèles du monde », quelles pièces fonctionnelles composent réellement cette capacité — et à quoi sert chacune ?
Les modèles de langage ont conféré aux machines une maîtrise extraordinaire des concepts, du vocabulaire et du raisonnement, mais le monde physique, virtuel ou réel, fonctionne sur un substrat différent. Là où les modèles de langage apprennent la structure statistique du texte, les modèles du monde apprennent la structure statistique de l'espace et du temps : comment la lumière tombe sur une surface, comment un jardin apparaît depuis un angle qu'aucune caméra n'a capturé, comment les objets réagissent aux forces et suivent les lois de la physique.
Cela fait de « modèle du monde » l'un des termes les plus importants et les plus surchargés de l'IA aujourd'hui. La vision par ordinateur, la robotique, l'apprentissage par renforcement et l'IA générative prétendent toutes construire des modèles du monde, et chacune entend quelque chose de très différent. Un modèle vidéo qui produit des flammes magnifiques mais physiquement impossibles, un modèle de langage improvisant un jeu jouable, et un moteur physique qui simule fidèlement la combustion portent tous le même nom.
Les anciens Grecs n'ont jamais pu s'accorder sur ce dont le monde était fait, que ce soit le feu, l'eau ou les atomes indivisibles, parce que le « monde » n'a jamais été une chose unique. C'était toujours un substitut pour la totalité qu'un penseur donné avait besoin d'envisager. L'IA a hérité du même problème, exactement au moment où le domaine a besoin de précision.
La boucle sous la taxonomie
Pour dissiper cette confusion, commençons par un diagramme plus ancien que n'importe quelle technologie en question. Les manuels d'apprentissage par renforcement, y compris le canonique Sutton et Barto, utilisent une version de la même image depuis des décennies pour décrire comment un agent interagit avec un monde. Le nom formel de cette image est le processus de décision markovien partiellement observable, ou POMDP, et la définition originale du terme « modèle du monde » appartient à cette tradition.
Un agent, qui peut être une personne, un robot ou un système logiciel, prend des actions. Ces actions affectent l'état du monde. L'agent ne voit jamais l'état directement. Ce qui parvient à l'agent, ce sont des observations : les photons qui tombent sur une rétine, les lectures d'un capteur, les pixels d'une image vidéo. De nouvelles observations informent de nouvelles actions, et la boucle continue.
Le mot « état » nécessite une explication, car sa signification change d'un domaine à l'autre. Il ne s'agit pas de l'état du chimiste, la différence entre solide, liquide et gaz. Il s'agit de l'état du physicien et du roboticien : une description complète de ce qui se passe dans le monde à un moment donné, incluant chaque objet, chaque position, chaque vitesse, chaque propriété. L'état est la réalité sous-jacente du monde ; complète en principe, mais jamais directement visible pour un agent à l'intérieur. Les observations sont la vision partielle de cette réalité par un agent. Les actions sont ce que l'agent fait en réponse.
Cette boucle — de l'agent à l'action, à l'état, à l'observation et retour — est la structure qui a donné au terme moderne « modèle du monde » sa signification technique. L'expression elle-même est plus ancienne, remontant à la proposition de Kenneth Craik en 1943 selon laquelle les esprits raisonnent en exécutant des « modèles à petite échelle » de la réalité, et a été introduite dans les réseaux de neurones à la fin des années 1980 et au début des années 1990. Et la boucle explique aussi ce que les gens entendent par ce terme aujourd'hui. Les différentes choses appelées modèles du monde sont en fait différentes projections de cette même boucle. Chacune produit une partie différente de celle-ci.
Trois fonctions d'un modèle du monde
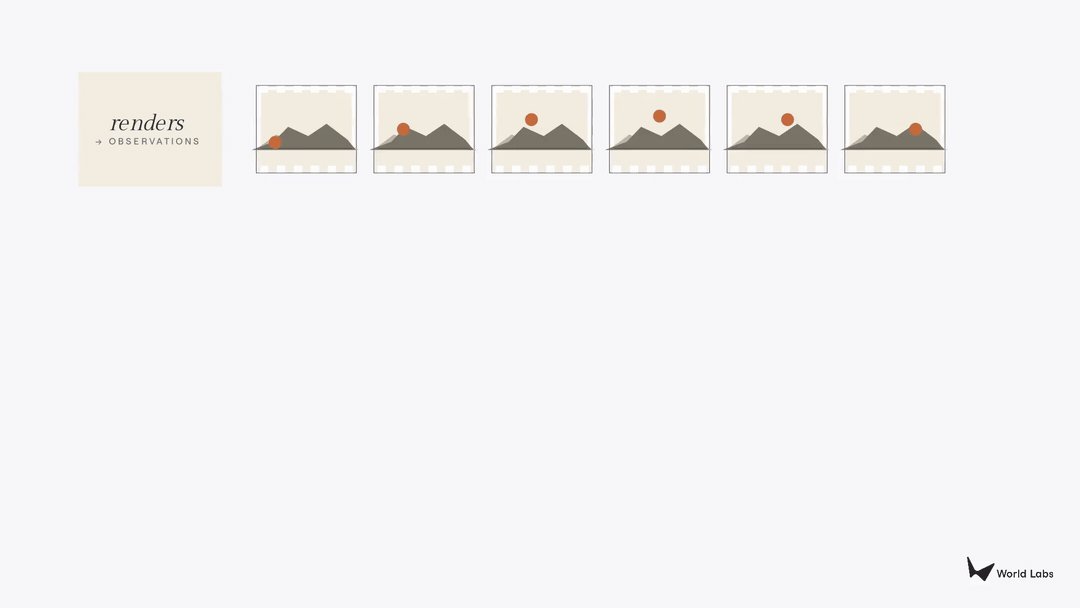
Le premier type de modèle du monde est un moteur de rendu. Un moteur de rendu produit des observations sous forme de pixels destinés à l'œil humain, et la qualité qui importe le plus est la fidélité visuelle. Un modèle vidéo qui transforme une invite textuelle en un plan cinématographique de drone est un moteur de rendu. Il en va de même pour un système interactif comme le Genie 3 de Google, ou RTFM de World Labs, où le modèle génère des images en temps réel conditionnées par les entrées de l'utilisateur. Le modèle ne porte aucune compréhension explicite de la structure tridimensionnelle. Il produit ce qu'un spectateur verrait, pas ce qui est. Les bâtiments dans le plan de drone peuvent sembler parfaits vus d'en haut, mais essayez de traverser la ville en dessous et ils s'effondrent.
Le deuxième type est un simulateur. Un simulateur produit de l'état : une représentation géométriquement, physiquement ou dynamiquement fidèle du monde sur laquelle les humains et les programmes informatiques peuvent tous deux calculer et interagir. Là où le contrat du moteur de rendu est purement visuel, le contrat du simulateur est structurel, exigeant une géométrie qui résiste à l'inspection, une physique qui respecte les lois de Newton, et une dynamique qui se comporte comme le monde doit se comporter compte tenu des lois de la physique. Un simulateur sert deux consommateurs à la fois. Les professionnels humains tels que les architectes, les designers, les cinéastes et les développeurs de jeux ont besoin d'une précision au-delà de la plausibilité visuelle. Les programmes informatiques tels que les agents d'apprentissage par renforcement, les contrôleurs robotiques et les véhicules autonomes utilisent les simulateurs comme terrains d'entraînement où ils peuvent interagir avec le monde à grande échelle, testant des scénarios qui seraient dangereux, coûteux ou impossibles à réaliser dans la réalité.
Le troisième type est un planificateur. Un planificateur produit des actions. Étant donné une observation et un objectif, un planificateur répond à la question de ce que l'agent doit faire ensuite. C'est, à bien des égards, l'inverse du moteur de rendu. Là où un moteur de rendu prend des actions en entrée et produit des observations, un planificateur prend des observations en entrée et produit des actions, fermant la boucle perception-action. Les modèles Vision-Langage-Action, les systèmes basés sur des modèles et la nouvelle vague de modèles d'action mondiale sont tous des tentatives de planificateurs : des systèmes capables de décider ce qu'un robot doit faire dans un monde non structuré.
Ces trois catégories décrivent la plupart de ce qui est effectivement livré aujourd'hui, et la distinction entre elles est utile en pratique. Les catégories ne sont cependant pas fondamentalement séparées. La même connaissance sous-jacente du fonctionnement du monde — géométrie, physique, dynamique — se trouve en dessous de toutes. Un modèle capable de rendre une tasse sous n'importe quel angle devrait, en principe, être capable de simuler ce qui se passe lorsque la tasse est poussée et de planifier une main pour la saisir. De plus en plus, les recherches les plus intéressantes brouillent délibérément les frontières entre les trois.
GIF
Pourquoi la simulation est la clé de voûte
Parmi les trois catégories, le simulateur est celui qui reçoit le moins d'attention du public, et c'est le plus important des trois. Cet essai aborde cette asymétrie.
Le moteur de rendu est de loin le plus mature commercialement. Un certain nombre de produits d'image ou de texte vers vidéo se développent rapidement sur les marchés grand public ou professionnels. Le modèle Nano Banana de Google a mis la génération d'images de qualité moteur de rendu entre les mains de potentiellement centaines de millions d'utilisateurs. La technologie est réelle, et les marchés sont réels. Pourtant, les moteurs de rendu optimisent la plausibilité visuelle plutôt que la précision physique, et ce plafond compte. Leurs résultats sont magnifiques, mais on ne peut pas leur faire confiance pour concevoir un bâtiment ou entraîner un robot.
Le planificateur est le plus intrigant et le plus naissant, étroitement lié au domaine en évolution rapide de l'apprentissage robotique. Le domaine a produit des démonstrations robotiques au cours des deux dernières années qui semblent impressionnantes en vidéo, mais la franchise s'impose sur ce que ces démonstrations montrent réellement. Presque toutes ont été confinées à des installations de laboratoire fortement contraintes, avec des ensembles d'objets restreints et des horizons de tâches courts. Aucune n'a été validée à la complexité, la variabilité ou la durée qu'exige un déploiement dans le monde réel. L'écart entre une démo convaincante et un robot qui fonctionne de manière fiable dans une cuisine, un entrepôt ou une salle d'opération reste immense. Les paris commerciaux n'en sont pas moins substantiels. Une vague de nouveaux entrants bien financés se précipite pour livrer des systèmes de planification à usage général, tandis que les plus grands acteurs d'infrastructure positionnent la planification au sommet de piles de simulation plus larges. Un robot qui peut planifier est un robot qui peut travailler, et toute l'industrie se précipite pour être celle qui y arrivera en premier.
La simulation est le pont entre les deux. Si le langage est une abstraction du monde et les pixels une projection de celui-ci, alors la géométrie, la physique et la dynamique sont le monde lui-même. Un simulateur doit fonctionner à ce niveau : l'épine dorsale structurelle à partir de laquelle l'apparence visuelle (pour les moteurs de rendu) et les conséquences des actions (pour les planificateurs) peuvent être dérivées.
Un modèle qui maîtrise la simulation peut projeter sa compréhension en pixels pour la consommation humaine, et en prédictions d'actions pour les agents incarnés. Un modèle qui ne maîtrise que le rendu, ou seulement la planification, ne peut faire ni l'un ni l'autre. La surface commerciale est énorme. Rien que l'Omniverse de NVIDIA cible ce que l'entreprise estime à plus d'un billion de dollars de marché adressable dans les usines, les entrepôts, les chaînes d'approvisionnement et les jumeaux numériques. La formation robotique, les tests de véhicules autonomes, la visualisation architecturale, l'ingénierie et la découverte de médicaments dépendent tous de quelque chose qui ressemble à une simulation.
Les problèmes ouverts les plus difficiles du domaine s'y trouvent aussi. Les données tridimensionnelles avec géométrie explicite, propriétés matérielles et annotations physiques sont des ordres de grandeur plus rares que la vidéo Internet sur laquelle les moteurs de rendu s'entraînent. Le fossé sim-versus-réel, qui est la différence entre la façon dont les choses se comportent en simulation et la façon dont elles se comportent dans la réalité, persiste. Les simulateurs génératifs introduisent un nouveau risque par-dessus : la géométrie générée par l'IA peut sembler correcte tout en contenant des auto-intersections ou une échelle erronée qui produit une physique absurde. La simulation multiphysique à grande échelle, où les corps rigides, les objets déformables, les fluides et les tissus interagissent tous, reste des ordres de grandeur plus coûteuse que la simulation mono-domaine.
Chez World Labs, Marble est notre premier pas dans ce territoire.** Il prend des invites multimodales (texte, image, vidéo ou croquis spatial) et génère des environnements 3D explorables, produisant des splats gaussiens pour l'exploration visuelle ainsi que des maillages de collision sur lesquels un moteur physique peut opérer. Mais Marble n'est que le premier chapitre d'une arc bien plus long qui s'écrit dans tout le domaine à mesure que les frontières entre rendu, simulation et planification commencent à s'effondrer.
Où les frontières s'effondrent et ce qui vient ensuite
Mais il y a plus à venir. Le modèle le plus important dans le domaine en ce moment est que les trois catégories commencent à se fondre les unes dans les autres. La compréhension partagée est que la connaissance nécessaire pour rendre un monde, le simuler et agir dedans est largement la même. Poursuivant l'exemple précédent, un modèle qui comprend vraiment comment une tasse repose sur une table (sa géométrie, ses propriétés matérielles, sa réponse à la force, etc.) devrait être capable de rendre cette tasse sous n'importe quel angle, de simuler ce qui se passe lorsque la tasse est poussée, et de planifier une main pour la saisir. Les trois catégories sont trois projections d'une seule compréhension sous-jacente.
Par exemple : un petit nombre croissant de travaux récents de divers laboratoires de robotique ont démontré qu'au moins conceptuellement, un moteur de rendu vidéo pré-entraîné peut être utilisé comme épine dorsale pour la prédiction conjointe du monde et des actions, suggérant un pont entre le moteur de rendu et le planificateur en permettant à un seul modèle d'imaginer ce qui va se passer et quoi faire. Marble de World Labs produit déjà des splats gaussiens et des maillages de collision à partir d'un seul modèle, dissolvant la frontière entre le moteur de rendu et le simulateur. Chaque niveau passe de la sortie passive au système interactif, avec des moteurs de rendu devenant conditionnés par l'action, des simulateurs générant des mondes plus contrôlables et éditables, et des planificateurs délibérant plutôt que de simplement réagir.
Le point final logique est un modèle du monde unifié : un modèle fondamental capable de produire des vues photoréalistes, de générer une structure physiquement précise et de planifier des séquences d'actions, en basculant entre les modalités de sortie selon les besoins du consommateur aval. Nous serons encore confrontés à un certain nombre de défis redoutables. Le paysage des données est inégal, avec des moteurs de rendu noyés dans la vidéo Internet tandis que les simulateurs et les planificateurs font face à des pénuries aiguës d'actifs 3D et de démonstrations robotiques. L'optimisation pour la beauté visuelle peut sacrifier la précision dont un robot ou une simulation haute fidélité a besoin. Concilier ces tensions à l'intérieur d'une seule architecture est le problème ouvert déterminant dans la recherche sur les modèles du monde aujourd'hui, et c'est ce que World Labs entreprend alors que nous continuons à faire évoluer Marble.
GIF
La direction, cependant, est claire. Le même pari que le domaine fait depuis la fin des années 1980 — qu'un modèle suffisamment riche du monde est tout ce dont un agent a besoin pour voir des mondes, les construire et agir en eux — est le pari qui motive désormais toute une génération de recherche. Ce qui donne du poids à ce « gros pari », c'est la convergence déjà en cours : trois fils, chacun déjà moteur et façonnant des industries de plusieurs milliards de dollars par lui-même, qui ont commencé comme des programmes de recherche séparés, commencent à se comporter comme un seul. Pris ensemble, à mesure que les frontières entre eux s'effondrent, ils remodeleront quelque chose de plus vaste : la relation entre l'intelligence machine et le monde physique qu'elle habite — la longue arc de l'intelligence spatiale.
Le langage a donné aux machines un moyen de parler de ce monde. Les modèles du monde sont la façon dont les machines vont enfin comprendre, imaginer, raisonner et interagir avec lui.


