Abbiamo implementato i Cerebras Wafer Scale Engine insieme alle GPU per fornire token fulminei su larga scala
Il mondo ha fame di token ultra veloci. Nel 2026, Cerebras ha registrato una domanda insaziabile di inferenza rapida, sia sul nostro cloud di inferenza sia tramite i nostri partner. Per soddisfare questa richiesta, abbiamo iniziato a sviluppare l'inferenza disaggregata: le GPU gestiscono l'elaborazione del prompt (prefill) e i sistemi Cerebras si occupano della generazione dell'output (decode).
Questa soluzione è ora in produzione e fornisce cinque volte più token per megawatt, mantenendo le stesse velocità ultra rapide di Cerebras.
Ora possiamo servire un numero maggiore di token ultra veloci tramite il Cerebras Inference Cloud per rispondere alla domanda del mercato. Anche i partner infrastrutturali possono sfruttare la soluzione disaggregata di Cerebras per ottenere più token ultra veloci nei propri data center.
Insieme al CS-4 annunciato di recente, all'aumento drastico della nostra capacità produttiva e ai 700 MW pianificati di capacità dei data center, l'inferenza disaggregata consentirà a Cerebras e ai suoi partner di fornire molti più token ultra veloci nel 2027 e oltre. In questo blog tratteremo:
- La necessità di una maggiore capacità di inferenza ultra veloce
- Perché Cerebras è avvantaggiata nella fase di decode
- I risultati in produzione dell'inferenza disaggregata di Cerebras
- L'inferenza disaggregata di Cerebras per i partner infrastrutturali
La necessità di una maggiore capacità di inferenza rapida
Le applicazioni agentiche come Muse, Copilot e Codex stanno crescendo rapidamente e richiedono un'inferenza altamente interattiva per mantenere gli utenti coinvolti. Per soddisfare la domanda crescente di queste applicazioni in un contesto con vincoli energetici, il nostro settore deve offrire una capacità di inferenza significativamente superiore per megawatt, con tempi di risposta che rendano queste applicazioni davvero utili.

Fonti: Goldman Sachs Research, “AI Agents Forecast to Boost Tech Cash Flow as Usage Soars” (Previsione: gli agenti AI aumenteranno il flusso di cassa tecnologico con l'impennata dell'utilizzo), 20 maggio 2026; stime sulla capacità dei data center di Goldman Sachs, come riportato da Investing.com
Ecco perché Cerebras ha investito nella disaggregazione. Affiancare un acceleratore di prefill per l'elaborazione dei prompt al sistema Cerebras per la generazione delle risposte aumenta il throughput dei token per megawatt, preservando le velocità di generazione ultra rapide di Cerebras. Per i fornitori di servizi di inferenza, questo significa più capacità per servire i clienti e un maggiore potenziale di ricavi a parità di budget energetico.
Perché Cerebras è avvantaggiata nella fase di decode
Una richiesta di inferenza si compone di due fasi principali. L'elaborazione del prompt, nota come prefill, elabora l'input e produce uno stato intermedio del modello. La generazione della risposta, nota come decode, utilizza quello stato per generare i token di output. Esistono molti modi per suddividere il carico di lavoro dell'inferenza, tra cui draft–target e attention–FFN, ma separare il prefill dal decode offre vantaggi unici quando l'obiettivo è un'inferenza altamente interattiva.

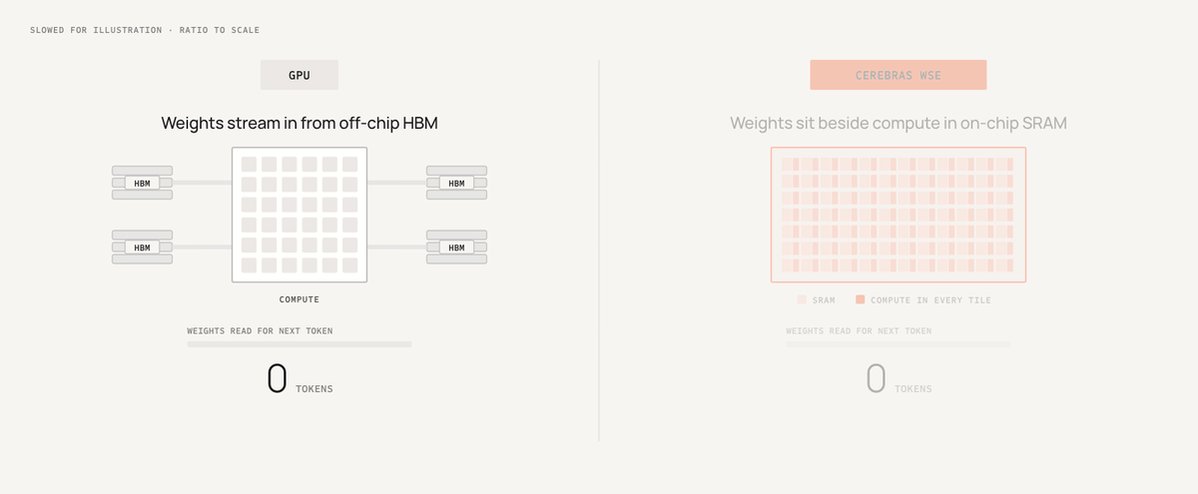
Il decode è autoregressivo. Ciò significa che il modello genera un token alla volta, utilizzando ogni token generato come input per produrre il successivo. Ogni passaggio richiede di leggere nuovamente i dati del modello dalla memoria, quindi la larghezza di banda della memoria è fondamentale. Nel campo dell'inferenza ultra veloce, i chip basati su SRAM sono avvantaggiati perché possono mantenere quei dati on-chip e leggerli molto più rapidamente. Cerebras porta questo concetto su scala wafer, con decine di gigabyte di SRAM e decine di petabyte al secondo di larghezza di banda della memoria su un singolo chip: 350 volte la capacità SRAM e 5.400 volte la larghezza di banda di memoria di una tipica GPU GB300. Questo permette al sistema Cerebras di gestire più richieste concorrenti e layer del modello direttamente sul chip, consentendo a CS-3, CS-4 e CS-5 di raggiungere velocità ultra rapide con un throughput estremamente interessante.
GIF
I risultati in produzione dell'inferenza disaggregata di Cerebras
Affiancare i sistemi Cerebras, ottimizzati per il decode ultra veloce, ad acceleratori particolarmente adatti alle esigenze computazionali del prefill, come le GPU AMD Instinct, consente di erogare un'enorme quantità di inferenza ultra veloce su larga scala. In un'implementazione in produzione sul Cerebras Inference Cloud, le GPU AMD Instinct elaborano i prompt e i sistemi Cerebras CS-3 generano le risposte. Spostare l'elaborazione dei prompt sulle GPU permette ai sistemi Cerebras di dedicare tutta la loro capacità di servizio alla generazione delle risposte. Nella nostra implementazione in produzione misurata, questa combinazione ha offerto un throughput per megawatt 5 volte superiore rispetto a una configurazione basata esclusivamente su CS-3, senza alcuna perdita nella velocità di generazione dei token.

Fonte: endpoint GPT-OSS-120B condiviso il 14 novembre tramite il Cerebras Inference Cloud; throughput per megawatt prima e dopo l'attivazione dell'inferenza disaggregata, normalizzato rispetto al baseline dell'inferenza aggregata (1×).
Entro la fine del 2027 prevediamo di implementare l'inferenza disaggregata su larga scala, per centinaia di megawatt, nel Cerebras Inference Cloud e nelle installazioni dei partner. Il nostro obiettivo è aumentare la capacità di inferenza ultra veloce disponibile per i nostri clienti.
L'inferenza disaggregata di Cerebras per i partner infrastrutturali
La soluzione di inferenza disaggregata di Cerebras è stata progettata anche per essere adottata dai nostri partner. I partner infrastrutturali possono implementare cluster di inferenza disaggregata basati sull'architettura di riferimento fornita da Cerebras, collocando gli acceleratori di prefill scelti e i sistemi Cerebras all'interno di una rete unificata. Per l'integrazione software, i partner possono scegliere se integrarsi con lo stack software disaggregato end-to-end di Cerebras o con un SDK dedicato esclusivamente al decode.
- Lo stack software disaggregato end-to-end è ideale per i partner che vogliono ottimizzare il time-to-market. È composto da:
- Un framework di inferenza disaggregata per instradare le richieste tra i pool di prefill e decode e gestire la capacità e lo stato di salute delle repliche.
- Un motore di prefill per elaborare i prompt utilizzando motori di inferenza open source come vLLM o SGLang.
- Un motore di decode Cerebras per la generazione delle risposte sui sistemi Cerebras.
- Il software KV Portal, un'interfaccia per trasferire lo stato intermedio del modello, incluse le cache key-value, tra i motori di prefill e decode tramite RDMA.
L'SDK solo decode è la scelta migliore per i partner che puntano al massimo controllo. Con l'SDK solo decode, i partner possono utilizzare il proprio framework di inferenza e il proprio motore di prefill insieme al motore di decode Cerebras e al software KV Portal. Inoltre, l'SDK solo decode fornisce strumenti di supporto allo sviluppo, come una replica di decode Cerebras simulata e un'integrazione di riferimento con un framework di inferenza disaggregata open source e un motore di prefill.

I partner in early access, tra cui Amazon Web Services, Fireworks AI, Gimlet Labs e General Compute, hanno già accesso alla soluzione di disaggregazione di Cerebras per le proprie implementazioni. Stiamo ora estendendo l'accesso ad altri partner che desiderano offrire un'inferenza ultra veloce ai propri clienti su larga scala.
Per approfondire i risultati, le soluzioni o le opportunità di implementazione, contattaci qui.


