“Il mondo è tutto ciò che accade.” — Ludwig Wittgenstein,
Tractatus Logico-Philosophicus
, 1921
Il mondo non è fatto di parole.
In un precedente articolo, abbiamo sostenuto che l’intelligenza spaziale è la prossima frontiera dell’IA e che i modelli del mondo sono la via per raggiungerla. Ora, io e il team di World Labs vogliamo andare un livello più in profondità: tra le tante cose che vengono costruite e chiamate ‘modelli del mondo’, quali componenti funzionali compongono effettivamente questa capacità — e a cosa serve ciascuna?
I modelli linguistici hanno dato alle macchine un controllo straordinario di concetti, vocabolario e ragionamento, ma il mondo fisico, virtuale o reale, funziona su un substrato diverso. Mentre i modelli linguistici apprendono la struttura statistica del testo, i modelli del mondo apprendono la struttura statistica dello spazio e del tempo: come la luce cade su una superficie, come appare un giardino da un’angolazione che nessuna macchina fotografica ha mai catturato, come gli oggetti rispondono alla forza e seguono le leggi della fisica.
Questo rende “modello del mondo” uno dei termini più importanti e più sovraccarichi dell’IA odierna. La visione artificiale, la robotica, l’apprendimento per rinforzo e l’IA generativa affermano tutte di costruire modelli del mondo, e ciascuna intende qualcosa di molto diverso. Un modello video che produce fiamme splendide ma fisicamente impossibili, un modello linguistico che improvvisa un gioco giocabile, e un motore fisico che simula fedelmente la combustione vengono tutti chiamati con lo stesso nome.
Gli antichi Greci non riuscivano mai a mettersi d’accordo su cosa fosse fatto il mondo, se fuoco, acqua o atomi indivisibili, perché il “mondo” non è mai stato una singola cosa. Era sempre un sostituto per qualsiasi totalità che un dato pensatore doveva esaminare. L’IA ha ereditato lo stesso problema, proprio nel momento in cui il campo ha bisogno di precisione.
Il ciclo sotto la tassonomia
Per tagliare questa confusione, si inizia con un diagramma più vecchio di qualsiasi tecnologia in questione. I libri di testo sull’apprendimento per rinforzo, inclusi quelli canonici di Sutton e Barto, usano da decenni una versione della stessa immagine per descrivere come un agente interagisce con un mondo. Il nome formale di questa immagine è processo decisionale di Markov parzialmente osservabile, o POMDP, e la definizione originale del termine “modello del mondo” appartiene a questa tradizione.
Un agente, che può essere una persona, un robot o un sistema software, compie azioni. Queste azioni influenzano lo stato del mondo. L’agente non vede mai lo stato direttamente. Ciò che raggiunge l’agente sono le osservazioni: i fotoni che cadono su una retina, le letture di un sensore, i pixel in un fotogramma video. Nuove osservazioni informano nuove azioni, e il ciclo continua.
La parola “stato” va approfondita, perché il significato cambia da campo a campo. Non è lo stato del chimico, la differenza tra solido, liquido e gas. È lo stato del fisico e del roboticista: una descrizione completa di ciò che accade nel mondo in un dato momento, inclusi ogni oggetto, ogni posizione, ogni velocità, ogni proprietà. Lo stato è la realtà sottostante del mondo; completo in linea di principio, ma mai direttamente visibile a nessun agente al suo interno. Le osservazioni sono la visione parziale di un agente di quella realtà. Le azioni sono ciò che l’agente fa in risposta.
Questo ciclo — agente, azione, stato, osservazione e ritorno — è la struttura che ha dato al termine moderno “modello del mondo” il suo significato tecnico. L’espressione stessa è più antica, risalente alla proposta del 1943 di Kenneth Craik secondo cui le menti ragionano eseguendo “modelli in scala ridotta” della realtà, e portata nelle reti neurali tra la fine degli anni ’80 e l’inizio degli anni ’90. E il ciclo spiega anche cosa le persone intendono oggi con questo termine. Le diverse cose che oggi vengono chiamate modelli del mondo sono in realtà diverse proiezioni di questo stesso ciclo. Ciascuna ne produce una parte diversa.
Tre funzioni di un modello del mondo
Il primo tipo di modello del mondo è un renderer. Un renderer produce osservazioni sotto forma di pixel destinati all’occhio umano, e la qualità più importante è la fedeltà visiva. Un modello video che trasforma un prompt testuale in una ripresa cinematografica con drone è un renderer. Lo è anche un sistema interattivo come Genie 3 di Google, o RTFM di World Labs, dove il modello genera fotogrammi in tempo reale condizionati dall’input dell’utente. Il modello non ha una comprensione esplicita della struttura tridimensionale. Produce ciò che uno spettatore vedrebbe, non ciò che è. Gli edifici nella ripresa col drone possono sembrare impeccabili dall’alto, ma prova a guidare per la città sottostante e crollano.
Il secondo tipo è un simulatore. Un simulatore produce stato: una rappresentazione geometricamente, fisicamente o dinamicamente fedele del mondo su cui sia gli umani che i programmi informatici possono calcolare e interagire. Mentre il contratto del renderer è puramente visivo, il contratto del simulatore è strutturale, richiedendo geometria che regga al controllo, fisica che rispetti le leggi di Newton e dinamiche che si comportino come il mondo deve comportarsi date le leggi della fisica. Un simulatore serve due consumatori contemporaneamente. I professionisti umani come architetti, designer, registi e sviluppatori di giochi hanno bisogno di precisione oltre la plausibilità visiva. I programmi informatici come gli agenti di apprendimento per rinforzo, i controller robotici e i veicoli autonomi usano i simulatori come campi di addestramento dove possono interagire con il mondo su larga scala, testando scenari che sarebbero pericolosi, costosi o impossibili da eseguire nella realtà.
Il terzo tipo è un pianificatore. Un pianificatore produce azioni. Data un’osservazione e un obiettivo, un pianificatore risponde alla domanda su cosa l’agente dovrebbe fare dopo. Questo è, per molti versi, l’inverso del renderer. Mentre un renderer prende le azioni come input e produce osservazioni, un pianificatore prende le osservazioni come input e produce azioni, chiudendo il ciclo percezione-azione. I modelli Visione-Linguaggio-Azione, i sistemi basati su modelli e la nuova ondata di World Action Models sono tutti tentativi di pianificatori: sistemi che possono decidere cosa un robot dovrebbe fare in un mondo non strutturato.
Queste tre categorie descrivono gran parte di ciò che viene effettivamente distribuito oggi, e la distinzione tra di esse è utile nella pratica. Le categorie non sono, tuttavia, fondamentalmente separate. La stessa conoscenza sottostante di come funziona il mondo — geometria, fisica, dinamica — sta sotto tutte quante. Un modello che può renderizzare una tazza da qualsiasi angolazione dovrebbe, in linea di principio, essere in grado di simulare cosa succede quando la tazza viene spinta e pianificare una mano per raccoglierla. Sempre più spesso, la ricerca più interessante offusca deliberatamente i confini tra le tre.
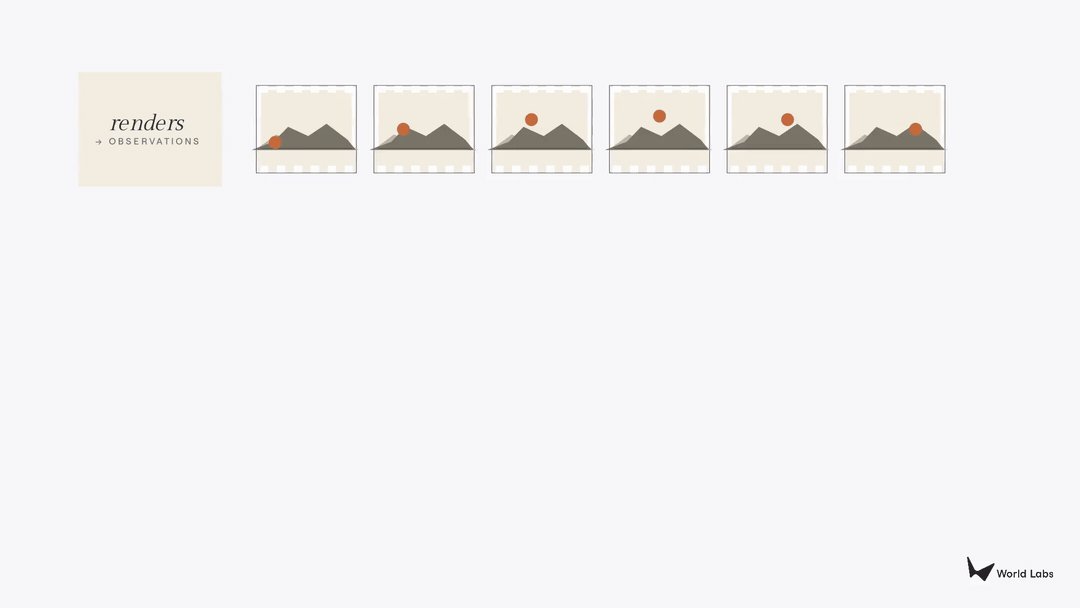
GIF
Perché la simulazione è il perno
Delle tre categorie, il simulatore riceve meno attenzione pubblica, ed è la più consequenziale delle tre. Questo articolo affronta questa asimmetria.
Il renderer è di gran lunga il più maturo commercialmente. Numerosi prodotti di immagine o testo-video si stanno espandendo rapidamente nei mercati consumer o aziendali. Il modello Nano Banana di Google ha messo la generazione di immagini di qualità da renderer nelle mani di potenzialmente centinaia di milioni di utenti. La tecnologia è reale, e i mercati sono reali. Tuttavia, i renderer ottimizzano per la plausibilità visiva piuttosto che per l’accuratezza fisica, e quel limite è importante. I loro output sono belli, ma non ci si può fidare di loro per progettare un edificio o addestrare un robot.
Il pianificatore è il più intrigante e il più nascente, strettamente connesso al campo in rapida evoluzione dell’apprendimento robotico. Il campo ha prodotto dimostrazioni robotiche negli ultimi due anni che sembrano impressionanti nei video, ma è necessaria franchezza su ciò che queste demo mostrano effettivamente. Quasi tutte sono state confinate a configurazioni di laboratorio fortemente vincolate, con insiemi di oggetti ristretti e orizzonti temporali brevi. Nessuna è stata validata alla complessità, variabilità o durata che richiede l’implementazione nel mondo reale. Il divario tra un reel demo accattivante e un robot che funziona in modo affidabile in una cucina, un magazzino o una sala operatoria rimane enorme. Le scommesse commerciali sono comunque sostanziali. Un’ondata di nuovi entranti ben finanziati sta correndo per distribuire sistemi di pianificazione generici, mentre i maggiori player infrastrutturali stanno posizionando la pianificazione sopra stack di simulazione più ampi. Un robot che sa pianificare è un robot che può lavorare, e l’intero settore sta correndo per essere il primo ad arrivarci.
La simulazione è il ponte tra i due. Se il linguaggio è un’astrazione del mondo e i pixel sono una sua proiezione, allora geometria, fisica e dinamica sono il mondo stesso. Un simulatore deve funzionare a quel livello: la spina dorsale strutturale da cui possono essere derivate sia l’aspetto visivo (per i renderer) che le conseguenze delle azioni (per i pianificatori).
Un modello che padroneggia la simulazione può proiettare la sua comprensione in pixel per il consumo umano, e in previsioni di azioni per agenti incarnati. Un modello che padroneggia solo il rendering, o solo la pianificazione, non può fare né l’uno né l’altro. La superficie commerciale è enorme. Il solo Omniverse di NVIDIA punta a ciò che l’azienda stima come un mercato indirizzabile di oltre un trilione di dollari in fabbriche, magazzini, catene di approvvigionamento e gemelli digitali. L’addestramento robotico, i test di veicoli autonomi, la visualizzazione architettonica, l’ingegneria e la scoperta di farmaci dipendono tutti da qualcosa a forma di simulazione.
Anche i problemi aperti più difficili del campo vivono lì. I dati tridimensionali con geometria esplicita, proprietà dei materiali e annotazioni fisiche sono ordini di grandezza più scarsi del video Internet su cui si addestrano i renderer. Il divario sim-reale, che è la differenza tra come le cose si comportano nella simulazione e come si comportano nella realtà, persiste. I simulatori generativi introducono un nuovo rischio in aggiunta: la geometria generata dall’IA può sembrare corretta mentre contiene auto-intersezioni o scale errate che producono fisica senza senso. La simulazione multi-fisica su larga scala, dove corpi rigidi, oggetti deformabili, fluidi e tessuti interagiscono tutti, rimane ordini di grandezza più costosa della simulazione a dominio singolo.
In World Labs, Marble è la nostra prima mossa in questo territorio.** Prende prompt multimodali (testo, immagine, video o schizzo spaziale) e genera ambienti 3D esplorabili, producendo splat gaussiani per l’esplorazione visiva insieme a mesh di collisione su cui un motore fisico può operare. Ma Marble è solo il primo capitolo di un arco molto più lungo che viene scritto in tutto il campo mentre i confini tra rendering, simulazione e pianificazione iniziano a crollare.
Dove i confini stanno crollando e cosa verrà dopo
Ma c’è dell’altro. Il modello più importante nel campo in questo momento è che le tre categorie stanno iniziando a fondersi l’una nell’altra. L’intuizione condivisa è che la conoscenza necessaria per renderizzare un mondo, simularlo e agire in esso è in gran parte la stessa. Continuando l’esempio precedente, un modello che comprende veramente come una tazza sta su un tavolo (la sua geometria, proprietà dei materiali, risposta alla forza, ecc.) dovrebbe essere in grado di renderizzare quella tazza da qualsiasi angolazione, simulare cosa succede quando la tazza viene spinta, e pianificare per una mano di raccoglierla. Le tre categorie sono tre proiezioni di una singola comprensione sottostante.
Ad esempio: un numero piccolo ma crescente di lavori recenti di vari laboratori di robotica ha dimostrato che — almeno concettualmente — un renderer video preaddestrato può essere usato come spina dorsale per la previsione congiunta mondo-azione, suggerendo un ponte tra il renderer e il pianificatore, permettendo a un modello di immaginare cosa accadrà e cosa fare. Marble di World Labs produce già splat gaussiani e mesh di collisione da un singolo modello, dissolvendo il confine tra il renderer e il simulatore. Ogni livello si sta muovendo dall’output passivo al sistema interattivo, con i renderer che diventano condizionati dall’azione, i simulatori che generano mondi più controllabili e modificabili, e i pianificatori che deliberano piuttosto che reagire e basta.
Il punto finale logico è un modello del mondo unificato: un modello foundation che può renderizzare viste fotorealistiche, produrre struttura fisicamente accurata e pianificare sequenze di azioni, passando da una modalità di output all’altra a seconda di ciò di cui il consumatore a valle ha bisogno. Dovremo ancora affrontare una serie di sfide impegnative. Il quadro dei dati è irregolare, con i renderer inondati di video Internet mentre simulatori e pianificatori affrontano acuta scarsità di risorse 3D e dimostrazioni robotiche. Ottimizzare per la bellezza visiva può sacrificare la precisione di cui un robot o una simulazione ad alta fedeltà hanno bisogno. Riconciliare queste tensioni all’interno di un’unica architettura è il problema aperto che definisce la ricerca sui modelli del mondo oggi, ed è ciò che World Labs si propone di fare mentre continuiamo a far evolvere Marble.
GIF
La direzione, tuttavia, è chiara. La stessa scommessa che il campo sta facendo dalla fine degli anni ’80 — che un modello del mondo sufficientemente ricco sia tutto ciò di cui un agente ha bisogno per vedere mondi, costruirli e agire in essi — è la scommessa che ora guida un’intera generazione di ricerca. Ciò che dà peso a questa “grande scommessa” è la convergenza già in atto: tre filoni, ciascuno già trainante e plasmatore di industrie da miliardi di dollari per conto proprio, che sono iniziati come programmi di ricerca separati stanno iniziando a comportarsi come uno solo. Presi insieme, mentre i confini tra di loro crollano, rimodelleranno qualcosa di più grande: la relazione tra l’intelligenza delle macchine e il mondo fisico che abita — il lungo arco dell’intelligenza spaziale.
Il linguaggio ha dato alle macchine un modo per parlare di quel mondo. I modelli del mondo sono il modo in cui le macchine arriveranno finalmente a capire, immaginare, ragionare e interagire con esso.


