Skill di estrazione outfit
Trasforma riferimenti moda in asset visivi riutilizzabili
Skill di estrazione outfit
Trasforma riferimenti moda in asset visivi riutilizzabili
Anteprima
Descrizione
Da usare quando l’utente fornisce immagini di riferimento dell’abbigliamento di un personaggio esistente e chiede di estrarre l’intero outfit, creare una tavola di asset dell’abbigliamento riutilizzabile tramite screenshot, scomporre top, giacche, capi inferiori, scarpe e accessori, oppure preparare materiali per futuri mix and match tra outfit. Per impostazione predefinita, genera una tavola di asset orizzontale in formato 3:2; non gestisce il cambio d’abito del personaggio, le viste a quattro angolazioni del personaggio, i tech pack di fabbrica o video finiti. Se si tratta solo di analizzare, scrivere prompt o discutere di Skill, non genera immagini.
Abilità correlate
Vedi tutto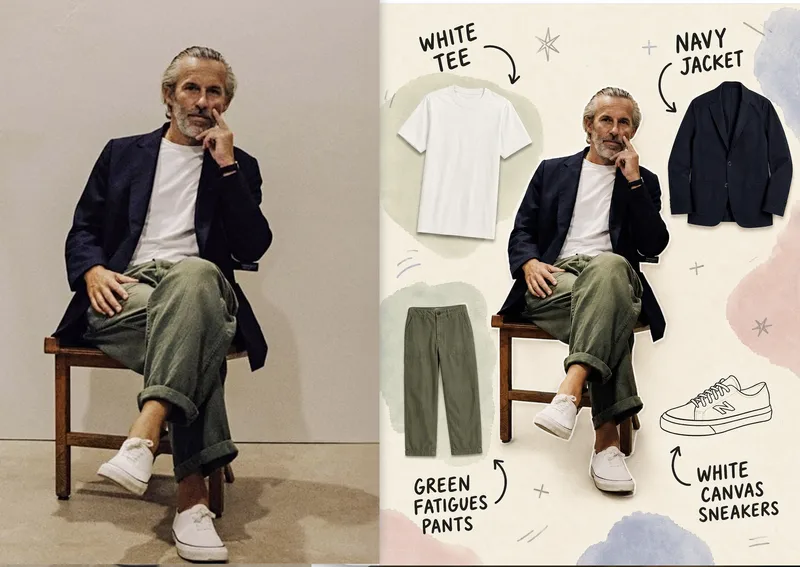 Immagine
Scomposizione outfit annotata
Trasforma una foto di un outfit indossato in una chiara e intuitiva «scomposizione dell’outfit», ideale per condividere look, lavorare nell’editoria di moda, documentare gli styling e creare immagini per i social media. L’immagine conserva i tratti del viso, la posa e l’outfit originale della persona, separando giacca, capo indossato sotto, parte inferiore, scarpe e accessori visibili in immagini indipendenti dei singoli capi, disposte naturalmente attorno al soggetto al centro per rendere l’insieme facile da comprendere. Ogni capo viene accompagnato da un’etichetta testuale in stile scarabocchio a mano e da una freccia curva, che ne indicano con precisione colore, categoria e materiale; le informazioni sul brand vengono aggiunte solo se fornite da te, senza fare supposizioni. L’insieme combina una superficie di carta color avorio caldo, morbide campiture ad acquerello e pochi simboli disegnati a mano con una persona realistica e immagini pulite dei singoli capi, creando un collage leggero dal tocco editoriale, senza coprire il soggetto né inventare indumenti assenti nella foto originale. Puoi anche modificare la lingua delle etichette, lo stile delle immagini dei singoli capi, la gamma cromatica delle campiture, il numero di capi e il rapporto d’aspetto, così da adattare il risultato ai tuoi gusti e al contesto di pubblicazione.
 Immagine
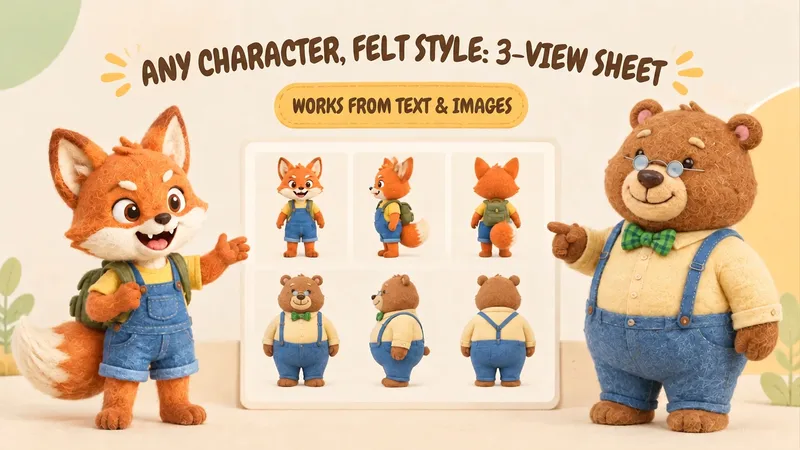
Personaggio in feltro: 3 viste
Dai al tuo personaggio preferito una morbida texture in feltro, con fibre di lana visibili. Carica un’immagine del personaggio oppure descrivilo in una frase per creare tre viste dello stesso personaggio: frontale, laterale a 90° e posteriore. Per i personaggi esistenti puoi mantenere tratti del viso, colori, abiti e accessori distintivi; senza un’immagine di riferimento, puoi iniziare anche solo dal testo. Riceverai: • Una tavola completa del personaggio in feltro, con vista frontale, laterale e posteriore. • Una descrizione chiara dell’aspetto del personaggio, utile per riutilizzarlo in seguito. • Prompt di generazione riutilizzabili, per continuare a modificare ed espandere il risultato. Il processo prima organizza le caratteristiche del personaggio, poi progetta il materiale in feltro, genera le tre viste e verifica la coerenza di prospettiva, abiti, accessori e strutture distintive. Quando rileva differenze visibili, le corregge in modo mirato; per i dettagli posteriori non mostrati nell’immagine di riferimento, completa in modo prudente e lo segnala. È adatto a IP originali, personaggi per libri illustrati e fumetti, sviluppo visivo per video brevi e creator che vogliono trasformare un’immagine amata in stile feltro. La tavola del personaggio può essere usata come riferimento visivo per la generazione di immagini, gli storyboard e la comunicazione nel team. Affida a questo processo il lavoro di perfezionare parole chiave per materiali, prospettive e vincoli del personaggio, e dedica le tue energie al personaggio e alla sua storia.
 Immagine
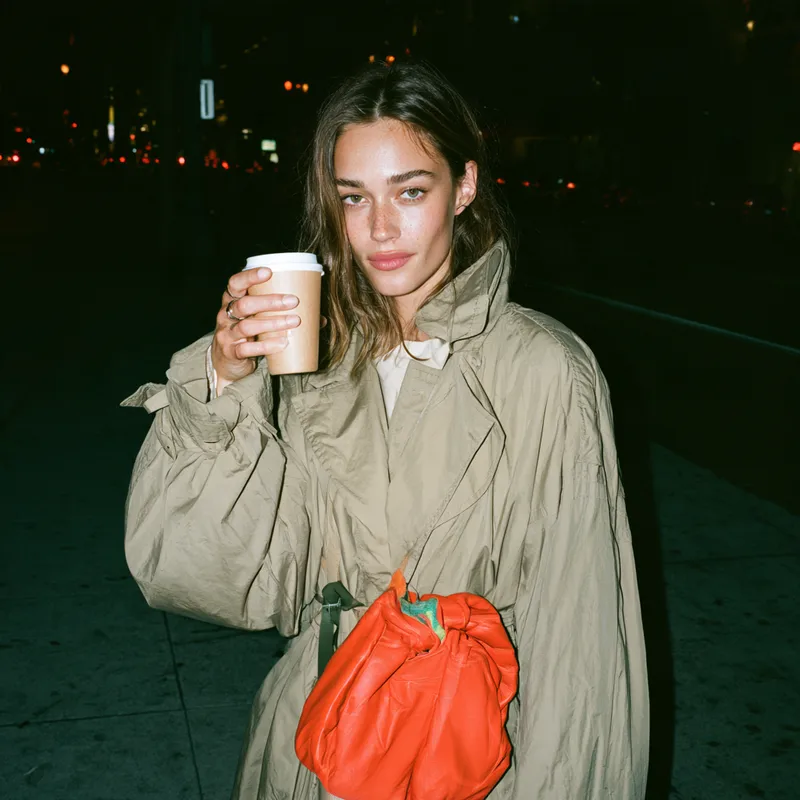
Moda street: prompt con flash
Genera prompt per immagini di moda street, borse, calzature e altri accessori con un autentico effetto da scatto ravvicinato con flash diretto. I prodotti restano nitidi e in evidenza, mantenendo al tempo stesso pose spontanee e l’atmosfera di un’istantanea in un vero ambiente urbano. Ideale per la fase iniziale di concept visivi per brand, contenuti social e moda e accessori, senza trasformare la scena in uno shooting da studio rigido e impostato o in una campagna pubblicitaria eccessivamente ritoccata. Puoi fornire un singolo prodotto, un outfit indossato o una situazione d’uso specifica, indicando colori, materiali, quantità, modalità di trasporto e formato dell’immagine. La skill organizzerà la scena attorno a un flash frontale ravvicinato, ombre brevi e nette, un’esposizione ambientale piuttosto scura ma leggibile e sfondi street in grigio naturale, bianco o blu scuro. Adatterà inoltre la composizione a diverse modalità, come portato a mano, a tracolla o appoggiato su un tavolo, per rendere più visibili la struttura della borsa, i manici, le suole e i dettagli degli abiti. L’output predefinito include idee visive indipendenti in formato 16:9 e prompt utilizzabili direttamente con Midjourney e ImageGen in cinese; se ti serve un solo formato, puoi richiederlo. Per le serie composte da più immagini, può mantenere coerenti le caratteristiche del prodotto e lo stile visivo, cambiando al contempo scena e posa: è ideale per creare una serie coordinata di immagini di moda street.
Informazioni
- Versione
- v2
- Ultimo aggiornamento
- Crediti per esecuzione
- In base all’utilizzo
- Modelli
- Automatico
