コンテンツ紹介
説明
2回の実測コーパス(計1,169篇、約520万文字、100以上の指標、約50万回のモデル意味評価)に基づく脱AI臭 Skill です。lieflat-less-ai-tone として GitHub で 7.3K+ Star を獲得しています。 この Skill は2回のデータ実験を通じて「AI臭さとは何か」を定量化しています。第1回は629篇の記事(283万文字)、第2回は新たに実行した540篇のペア記事(256万文字)であり、前後合わせて1,169篇、計520万文字に及びます。 市場で想定される「AI臭さ」を100以上の指標に分解し、スクリプト検出、大規模モデルの意味検出、および人間によるブラインドテストの3つの方法で検証しました。文ごと・段落ごとの機械による意味評価を50.7万回実行し、最後に大量の人間によるブラインド読み合わせ評価を実施しました。 最終的に、皆さんが使いやすいように Skill という形で提供することになり、lieflat-less-ai-tone プロジェクトが誕生しました。 この Skill は、まず指標、研究の参考、原文の例文、修正方法を含む検出レポートを提供し、ユーザーの返信後に書き換えと再テストを行います。
おすすめした人
Dancang
このスキルをおすすめする理由
大規模な比較コーパスと複数回の意味再テストに基づき、まずは検出と証拠の説明を行い、確認を経て最小限の書き直しと再テストを実施します。単なる語彙のランダムな削除ではなく、統計的シグナル、意味判定、人間によるレビューの境界を明確にし、事実・スタイル・原文の構造を守ります。
こんな方におすすめ
原文の意味、事実、文章構造を維持しながら、テキスト内のAIによる執筆の痕跡を減らしたいライターに最適です。
この Skill の使い方
入力を用意する
チェックしたい文章やテキストを提供し、必要に応じて注目したい範囲を指定します。
Skill を実行する
テキスト内のAI臭さを感じさせる痕跡を分析し、例文と修正方法を記載した検出レポートを提示します。確認を受信後、選択された提案に基づいて最小限の書き直しと再テストを行います。
結果を確認する
修正前の検出レポート、書き直されたテキスト、および修正前後の比較結果を取得できます。
関連スキル
すべて表示 執筆
中国語AIっぽさ除去リライト
中国語の原稿を、特定のシーンで実際の人間が書いたかのような自然な文章に書き換えつつ、元の事実、立場、口調の強さを保持します。微信(WeChat)のメッセージ、メール、小紅書(RED)、業務報告、論文のいずれであっても、まず文体や表現の問題を識別した上で、決まり文句、抽象的な表現、機械的な構造、名詞化された文型、シーンに合わない口調を対象を絞って整理します。これにより、過度に口語的になることなく、より具体的で自然、スムーズな文章に仕上げます。 書き換え時には、事実の境界線を厳守します。勝手に数字、日付、人名、機関、事例、約束、効果を追加したり、「かもしれない」を「必ず」に変更したりせず、重要な限定や結論を削除することもありません。原文に必要な情報が不足している場所については、完全な文章にするための細部の捏造を防ぐため、要補充情報として明確にマークします。また、論文や業務報告における標準的でフォーマルな表現が、「AIっぽさ」と誤認されて無理に崩されることもありません。 事実確認と二重チェックを経た中国語のリライト結果が得られ、そのままコミュニケーション、公開、報告、またはアカデミックな執筆に使用できます。必要に応じて、具体的な痕跡の判定、変更の根拠、要補充情報も確認でき、どの部分がどのように調整されたか、および書き換え前後の情報の完全性と一貫性がどのように保たれているかを明確に把握できます。
AI教材品質検証スペシャリスト
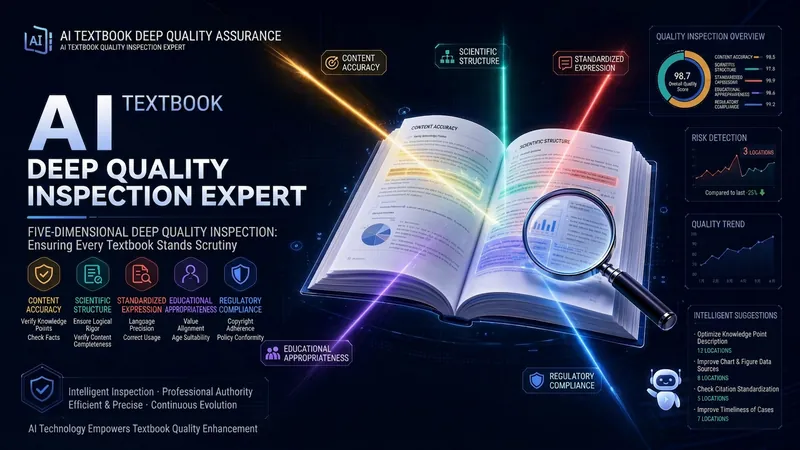
📚 AI教材深層品質検証スペシャリスト — 5次元スキャンで、AIが執筆した教材を審査に耐えられるものにします。 AIアシストで執筆された教材には5つの共通の欠点があります:知識の誤りは自己チェックが難しい、授業設計に教室感がない、大量の「正しいけど役に立たない文」、テンプレート化して機械的な文章、難解で学生が読むのを諦める。本システムは各章を5次元で深層品質検証し、教科専門家、教育デザイナー、事実確認者、文体鑑定士の4つの役割から各章を精査し、定量評価と直接置き換え可能な修正提案を出力します。 5つの次元: 📐 知識の正確性 — 概念、モデル、データを一つひとつ出典を確認して修正し、各誤りには出典を明記 🎯 教育設計 — 難易度曲線、前提知識の補足、章間のつながりを、ベテラン教師のように精査 💎 内容の実質性 — 「正しいけど役に立たない文」を特定し、各節の実際の情報量を計算 🤖 AIらしさ検出 — 教材独自の基準で、通常の書き方とAIテンプレートのパターンを区別 📖 可読性 — 段落のリズム、専門用語の密度を評価し、学生がスムーズに読めるかを判定 注目機能: 🔗 章間の一貫性 — 自動で知識プロファイルを生成し、概念の矛盾、用語の不一致、重複定義を検出 🔄 クローズドループの反復 — 修正後に再提出すると、改善項目、未解決項目、新たな問題を自動追跡 📊 階層的レポート — まず概要スコアとTOP3の問題を表示し、必要に応じて段落ごとの分析を展開 🎤 鋭い指摘 — 問題を美化せず、「この定義は間違っています」と明確に指摘し、各批判には修正の参考を添付 適用:AIアシストで執筆された学部生・大学院生向け教材、学術専門書、講義資料。現バージョンは学部教材向けに最適化されていますが、大学院教材にも対応しています。章を貼り付ける → 評価を取得 → 該当箇所を修正 → 再検証、品質が合格するまで繰り返します。
AIプロンプト設計士 MAX
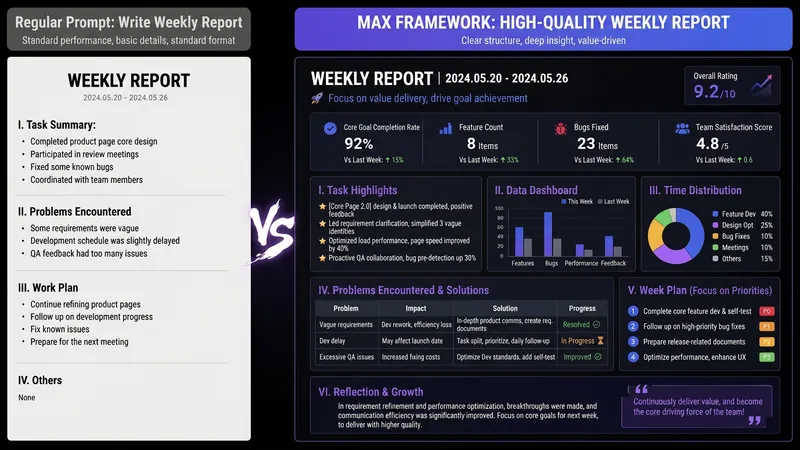
こんな経験はありませんか? AIに週報を書かせたら、小学生の日記のような文章が返ってくる。AIに履歴書を直させたら、「協調性・勤勉・責任感」の決まり文句になる。データ分析を頼んだら、冒頭に「私はAIとして、喜んでお手伝いします……」と書かれる。 AIの性能が低いのではなく、指示の出し方が実務レベルになっていないのです。 世の中にはPromptのテンプレートがすでに数多くあります。それでもテンプレートを使っただけでは、Promptを書けるようになりません。足りないのはテンプレートではなく、要望をPromptに変換する力です。 このSKILLは、AI OPC(一線でAI導入に取り組む実務担当者)である私が、日々チーム向けにPrompt設計を行う中で培った方法論を、「Promptコンパイラ」としてまとめたものです。 あなたが自然な言葉で伝えれば、実用的な設計に変換します。 入力:「月報を書いて」 出力:8つのモジュールで構成された完全なPrompt設計——役割、タスク、対象読者、手順、制約、形式、セルフチェック、例をすべて明確に定義します。ChatGPT / Claude / DeepSeek / Kimiのいずれかにコピー&ペーストすれば、最初の出力から使える内容になります。 さらに、次のことも教えてくれます: ✓ このPromptに最適なモデル ✓ 次回から直接変更できる変数(1度学べば、繰り返し使えます) ✓ 出力をさらに改善するために、あと1つ必要な情報 一般的なPromptテンプレートSKILLとは何が違うのでしょうか? 他のSKILLが魚(完成済みのPrompt)を与えるものだとすれば、このSKILLはコンパイラです。どんな要望でもPromptに変換する力を身につけられます。 一度導入すれば、AIを使うあらゆる場面が向上します。文章作成、報告、分析、翻訳、カスタマーサポート、創作まで、幅広く活用できます。 こんな方におすすめです: 毎日AIを使っているのに、出力に満足できないビジネスパーソン Promptエンジニアリングを学びたいけれど、数千元もする講座には参加したくない方 チームでAIを活用したいものの、標準化の方法がわからない責任者 コンテンツ制作者、研究者、学生、求職者、副業に取り組む方 AIをうまく使えるかどうかは、どのモデルを使うかではなく、要望をPromptに変換できるかで決まります。 これを導入すれば、今日からAIとの対話の質が大きく向上します。
情報
- バージョン
- v4
- 最終更新
- 実行クレジット
- 使用量に応じて消費
- モデル
- 自動選択
- 活用シーン
- 文章・コンテンツ制作
- 得られるもの
- レポート文書
