Transcrição de Vídeo
Transcrição de Vídeo
Prévia
Descrição
Transcreva arquivos locais de vídeo ou áudio em legendas SRT com marcação de tempo e texto simples, priorizando o processamento local e suportando serviços de ASR remotos configurados mediante consentimento.
Habilidades relacionadas
Ver tudo Escrever
Áudio para rascunho
Transforme um arquivo de áudio, nota de voz, vídeo com fala ou transcrição em um único rascunho editável e coerente. O conteúdo falado ausente é transcrito automaticamente, com continuidade em segundo plano quando necessário, para que você não precise voltar para retomar o processo.
 Pesquisa
Áudio em Tarefas e Decisões
Transforme um arquivo de áudio ou uma transcrição em um registro conciso e editável de decisões, tarefas, responsáveis, datas, impedimentos e questões em aberto. Trechos de fala ausentes são transcritos automaticamente, com continuidade em segundo plano quando necessário, antes que sejam propostas ações opcionais do Agent.
 Pesquisa
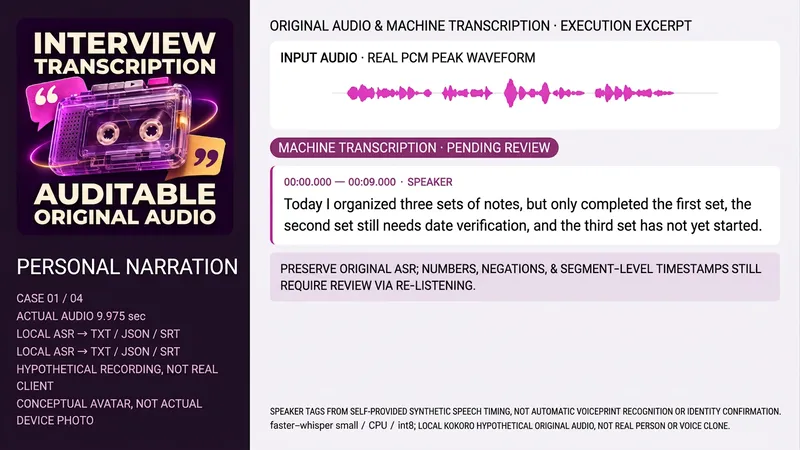
Transcrição de Entrevista
Ideal para quem precisa organizar gravações autorizadas de entrevistas, reuniões ou aulas. Forneça o arquivo original, idioma, finalidade, transcrição existente ou mapeamento confiável de locutores por tempo; a identidade não pode ser confirmada apenas pela voz e os roteiros não substituem o que foi efetivamente ouvido. Preserva o áudio original e o hash, lê a duração e a faixa, executa o ASR real, organiza na linha do tempo correta, rotula locutores anônimos quando houver base, confere números, negações, nomes e dúvidas ouvindo o áudio original, e entrega TXT, JSON, SRT e notas de abrangência. A primeira versão da máquina, a revisão de escuta e o resumo são separados; o que não estiver claro é mantido pendente, sem preenchimento automático para fluidez. Sem ferramentas de áudio ou ASR, a transcrição é explicitamente omitida. O comando e o pacote incluem um assistente local original completo: Python3, FFmpeg/FFprobe, faster-whisper e o cache small pré-configurado, CPU/int8, local_files_only, sem download automático de pesos. O speaker-map confiável realiza a transcrição real por janela e mapeia o tempo; sem mapeamento, o carimbo é desconhecido. O assistente não realiza separação automática de timbre nem identificação de identidade, e o pacote não inclui pesos, contas ou chaves. Os quatro exemplos consistem em monólogo pessoal em chinês criado para este fim, entrevista dupla em chinês, apresentação de curso em inglês e reunião dupla em chinês, totalizando cerca de 40,875 segundos de áudio. O áudio original final utiliza versão fixa local de Kokoro-82M rotulada no modelo Apache-2.0, zf_xiaobei, zm_yunjian, af_heart, sem vozes reais ou clonagem; modelos, vozes ou áudios de exemplo não são distribuídos com o instalador. Os quatro exemplos de ASR real geram TXT/JSON/SRT, e os locutores vêm do tempo de fala sintético fornecido, e não de separação automática de locutores. Ainda é uma versão preliminar da máquina; a divergência entre o ASR da segunda vez e a primeira versão do roteiro aguarda conferência auditiva, sem alteração arbitrária para o que foi dito. A forma de onda vem dos picos PCM de entrada reais, não sendo apenas decorativa. Para a organização de texto, recomenda-se o GPT, e o ASR depende das ferramentas reais; nenhuma API de transcrição da OpenAI foi chamada localmente nem CLI upstream executada. O avatar independente é o visual de conceito ImageGen, a ferramenta não retornou modelo e Image2 não é reivindicado. Ferramentas, cache, downloads de arquivos e vinculação de modelos na YouMind não consomem pontos de teste; é preciso confirmar conforme o ambiente real. A transcrição e a organização de locutores não garantem execução sem dependências após a instalação. Os 299 pontos equivalem ao preço de instalação, sem incluir modelos, APIs ou serviços de terceiros, sem compra automática e sem upload oculto de faixas de áudio desconhecidas para serviços externos. Não há promessa de zero erros, reconhecimento perfeito de sotaques, ruídos ou múltiplos locutores sobrepostos, perícia judicial ou de identidade, eficiência de tempo ou resultado comercial. A revisão de áudio independente requer complementação, sem propaganda de verificação de transcrição exata.
Informações
- Versão
- v2
- Última atualização
- Créditos por execução
- Conforme o uso
- Modelos
- Automático
