"O mundo é tudo o que é o caso." — Ludwig Wittgenstein,
Tractatus Logico-Philosophicus
, 1921
O mundo não é feito de palavras.
Em um ensaio anterior, argumentamos que a inteligência espacial é a próxima fronteira da IA e que os modelos de mundo são o caminho para alcançá-la. Aqui, a equipe do World Labs e eu queremos ir um nível mais fundo: das muitas coisas que estão sendo construídas e chamadas de 'modelos de mundo', quais peças funcionais realmente compõem essa capacidade — e para que serve cada uma?
Modelos de linguagem deram às máquinas um domínio extraordinário de conceitos, vocabulário e raciocínio, mas o mundo físico, virtual ou real, opera em um substrato diferente. Onde os modelos de linguagem aprendem a estrutura estatística do texto, os modelos de mundo aprendem a estrutura estatística do espaço e do tempo: como a luz incide sobre uma superfície, como um jardim se parece de um ângulo que nenhuma câmera capturou, como os objetos respondem à força e seguem as leis da física.
Isso faz de "modelo de mundo" um dos termos mais importantes e mais sobrecarregados da IA hoje. Visão computacional, robótica, aprendizado por reforço e IA generativa afirmam estar construindo modelos de mundo, e cada um significa algo bastante diferente. Um modelo de vídeo que produz chamas deslumbrantes, mas fisicamente impossíveis, um modelo de linguagem improvisando um jogo jogável e um motor de física que simula fielmente a combustão, todos recebem o mesmo nome.
Os gregos antigos nunca conseguiam concordar sobre do que o mundo era feito, se fogo, água ou átomos indivisíveis, porque "mundo" nunca foi uma coisa única. Era sempre um substituto para qualquer totalidade que um determinado pensador precisava para raciocinar. A IA herdou o mesmo problema, exatamente no momento em que o campo precisa de precisão.
O loop abaixo da taxonomia
Cortar essa confusão começa com um diagrama mais antigo do que qualquer uma das tecnologias em questão. Livros didáticos de aprendizado por reforço, incluindo o canônico Sutton e Barto, usam uma versão da mesma imagem há décadas para descrever como um agente interage com um mundo. O nome formal para esta imagem é o processo de decisão de Markov parcialmente observável, ou POMDP, e a definição original do termo "modelo de mundo" pertence a essa tradição.
Um agente, que pode ser uma pessoa, um robô ou um sistema de software, realiza ações. Essas ações afetam o estado do mundo. O agente nunca vê o estado diretamente. O que chega ao agente são observações: os fótons que incidem sobre uma retina, as leituras de um sensor e os pixels em um quadro de vídeo. Novas observações informam novas ações, e o loop continua.
A palavra "estado" precisa ser desempacotada, porque o significado muda de campo para campo. Este não é o estado do químico, a diferença entre sólido, líquido e gasoso. Este é o estado do físico e do roboticista: uma descrição completa do que está acontecendo no mundo em um determinado momento, incluindo cada objeto, cada posição, cada velocidade, cada propriedade. Estado é a realidade subjacente do mundo; completo em princípio, mas nunca diretamente visível para nenhum agente dentro dele. Observações são a visão parcial de um agente dessa realidade. Ações são o que o agente faz em resposta.
Este loop — agente para ação para estado para observação e de volta — é a estrutura que deu ao termo moderno "modelo de mundo" seu significado técnico. A frase em si é mais antiga, traçada até a proposta de Kenneth Craik em 1943 de que as mentes raciocinam executando "modelos em pequena escala" da realidade, e carregada para redes neurais no final dos anos 1980 e início dos anos 1990. E o loop também explica o que as pessoas querem dizer com o termo hoje. As diferentes coisas agora chamadas de modelos de mundo são, na verdade, diferentes projeções deste mesmo loop. Cada uma produz uma peça diferente dele.
Três funções de um modelo de mundo
O primeiro tipo de modelo de mundo é um renderizador. Um renderizador produz observações na forma de pixels destinados a olhos humanos, e a qualidade mais importante é a fidelidade visual. Um modelo de vídeo que transforma um prompt de texto em uma tomada cinematográfica de drone é um renderizador. Assim como um sistema interativo como o Google Genie 3, ou o próprio RTFM do World Labs, onde o modelo gera quadros em tempo real condicionados à entrada do usuário. O modelo não carrega nenhum entendimento explícito de estrutura tridimensional. Ele produz o que um espectador veria, não o que é. Os edifícios na tomada de drone podem parecer impecáveis de cima, mas tente dirigir pela cidade abaixo e eles se desfazem.
O segundo tipo é um simulador. Um simulador produz estado: uma representação geometricamente, fisicamente ou dinamicamente fiel do mundo sobre a qual humanos e programas de computador podem computar e interagir. Enquanto o contrato do renderizador é puramente visual, o contrato do simulador é estrutural, exigindo geometria que se sustente sob inspeção, física que respeite as leis de Newton e dinâmica que se comporte como o mundo precisa se comportar dadas as leis da física. Um simulador atende a dois consumidores ao mesmo tempo. Profissionais humanos, como arquitetos, designers, cineastas e desenvolvedores de jogos, precisam de precisão além da plausibilidade visual. Programas de computador, como agentes de aprendizado por reforço, controladores de robôs e veículos autônomos, usam simuladores como campos de treinamento onde podem interagir com o mundo em escala, testando cenários que seriam perigosos, caros ou impossíveis de executar na realidade.
O terceiro tipo é um planejador. Um planejador produz ações. Dada uma observação e um objetivo, um planejador responde à pergunta sobre o que o agente deve fazer em seguida. Isso é, em muitos aspectos, o inverso do renderizador. Enquanto um renderizador recebe ações como entrada e produz observações, um planejador recebe observações como entrada e produz ações, fechando o loop percepção-ação. Modelos Visão-Linguagem-Ação, sistemas baseados em modelo e a nova onda de Modelos de Ação Mundial são todas tentativas de planejadores: sistemas que podem decidir o que um robô deve fazer em um mundo não estruturado.
Essas três categorias descrevem a maior parte do que está realmente sendo enviado hoje, e a distinção entre elas é útil na prática. As categorias, no entanto, não são fundamentalmente separadas. O mesmo conhecimento subjacente de como o mundo funciona — geometria, física, dinâmica — está por baixo de todas elas. Um modelo que pode renderizar um copo de qualquer ângulo deveria, em princípio, ser capaz de simular o que acontece quando o copo é empurrado e planejar uma mão para pegá-lo. Cada vez mais, as pesquisas mais interessantes borram deliberadamente os limites entre as três.
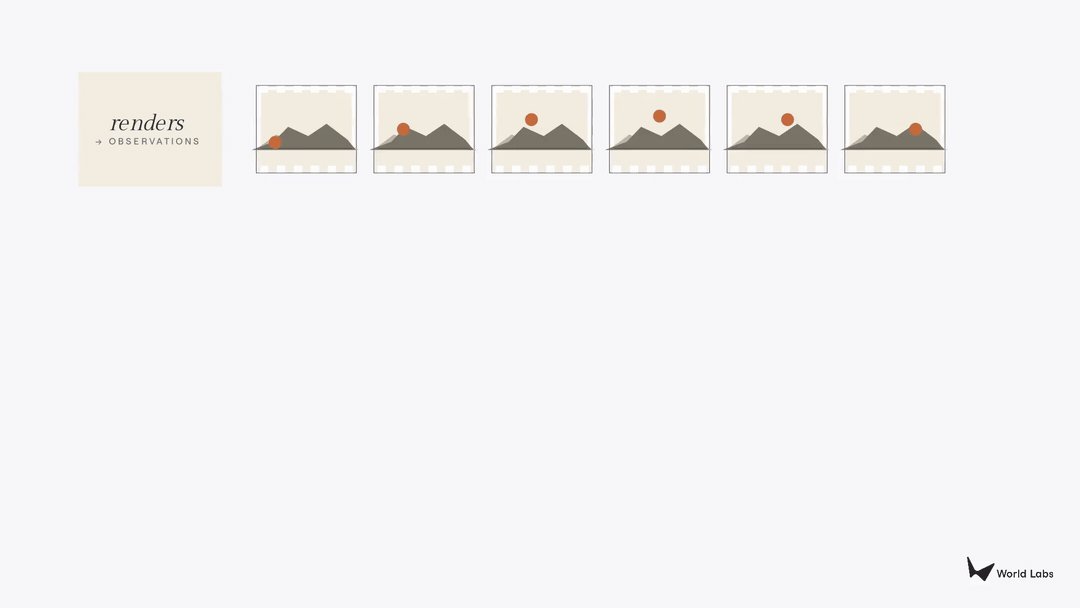
GIF
Por que a simulação é a peça central
Das três categorias, o simulador recebe menos atenção pública e é o mais consequente dos três. Este ensaio aborda essa assimetria.
O renderizador é de longe o mais maduro comercialmente. Vários produtos de imagem ou texto para vídeo estão se expandindo rapidamente nos mercados consumidor ou empresarial. O modelo Google Nano Banana colocou a geração de imagens de qualidade de renderizador nas mãos de potencialmente centenas de milhões de usuários. A tecnologia é real, e os mercados são reais. No entanto, os renderizadores otimizam para plausibilidade visual em vez de precisão física, e esse teto é importante. Seus resultados são bonitos, mas não se pode confiar neles para projetar um edifício ou treinar um robô.
O planejador é o mais intrigante e o mais nascente, intimamente ligado ao campo em rápida evolução da aprendizagem robótica. O campo produziu demonstrações robóticas nos últimos dois anos que parecem impressionantes em vídeos, mas é preciso franqueza sobre o que essas demonstrações realmente mostram. Quase todas foram confinadas a montagens de laboratório fortemente restritas, com conjuntos estreitos de objetos e horizontes de tarefas curtas. Nenhuma foi validada na complexidade, variabilidade ou duração que a implantação no mundo real exige. A lacuna entre um demo reel convincente e um robô que funciona de forma confiável em uma cozinha, armazém ou sala de cirurgia continua imensa. As apostas comerciais são, no entanto, substanciais. Uma onda de participantes bem financiados está correndo para enviar sistemas de planejamento de propósito geral, enquanto os maiores players de infraestrutura estão posicionando o planejamento sobre pilhas de simulação mais amplas. Um robô que pode planejar é um robô que pode trabalhar, e toda a indústria está correndo para ser a primeira a chegar lá.
A simulação é a ponte entre os dois. Se a linguagem é uma abstração do mundo e os pixels são uma projeção dele, então geometria, física e dinâmica são o próprio mundo. Um simulador deve trabalhar nesse nível: a espinha dorsal estrutural da qual tanto a aparência visual (para renderizadores) quanto as consequências das ações (para planejadores) podem ser derivadas.
Um modelo que domina a simulação pode projetar seu entendimento em pixels para consumo humano e em previsões de ações para agentes incorporados. Um modelo que domina apenas a renderização, ou apenas o planejamento, não pode fazer nenhum dos dois. A superfície comercial é enorme. Somente o NVIDIA Omniverse visa o que a empresa estima como mais de um trilhão de dólares de mercado endereçável em fábricas, armazéns, cadeias de suprimentos e gêmeos digitais. Treinamento de robótica, teste de veículos autônomos, visualização arquitetônica, engenharia e descoberta de medicamentos dependem de algo com formato de simulação.
Os problemas abertos mais difíceis no campo também vivem lá. Dados tridimensionais com geometria explícita, propriedades de materiais e anotações físicas são ordens de magnitude mais escassos do que o vídeo da Internet no qual os renderizadores treinam. A lacuna sim-para-real, que é a diferença entre como as coisas se comportam na simulação e como elas se comportam na realidade, persiste. Simuladores generativos introduzem um novo risco além disso: a geometria gerada por IA pode parecer correta enquanto contém auto-interseções ou escala errada que produzem física sem sentido. A simulação multifísica em escala, onde corpos rígidos, objetos deformáveis, fluidos e tecido interagem, permanece ordens de magnitude mais cara do que a simulação de domínio único.
No World Labs, Marble é nosso primeiro movimento neste território. Ele recebe prompts multimodais (texto, imagem, vídeo ou esboço espacial) e gera ambientes 3D exploráveis, produzindo splats Gaussianos para exploração visual juntamente com malhas de colisão nas quais um motor de física pode operar. Mas Marble é apenas o primeiro capítulo de um arco muito mais longo que está sendo escrito em todo o campo, à medida que as linhas entre renderização, simulação e planejamento começam a colapsar.
Onde os limites estão colapsando e o que vem a seguir
Mas mais está por vir. O padrão mais importante no campo agora é que as três categorias estão começando a se misturar umas nas outras. A percepção compartilhada é que o conhecimento necessário para renderizar um mundo, simulá-lo e agir nele é em grande parte o mesmo. Continuando com o exemplo anterior, um modelo que realmente entende como um copo está sobre uma mesa (sua geometria, propriedades de materiais, resposta à força, etc.) deve ser capaz de renderizar esse copo de qualquer ângulo, simular o que acontece quando o copo é empurrado e planejar uma mão para pegá-lo. As três categorias são três projeções de um único entendimento subjacente.
Por exemplo: um número pequeno, mas crescente, de trabalhos recentes de vários laboratórios de robótica demonstrou que — pelo menos conceitualmente — um renderizador de vídeo pré-treinado pode ser usado como espinha dorsal para a predição conjunta de mundo e ação, sugerindo uma ponte entre o renderizador e o planejador ao permitir que um modelo imagine o que acontecerá e o que fazer. O Marble do World Labs já produz splats Gaussianos e malhas de colisão a partir de um único modelo, dissolvendo o limite entre o renderizador e o simulador. Cada nível está se movendo de saída passiva para sistema interativo, com renderizadores se tornando condicionados por ação, simuladores gerando mundos que são mais controláveis e editáveis, e planejadores deliberando em vez de apenas reagir.
O ponto final lógico é um modelo de mundo unificado: um modelo fundacional que pode renderizar vistas fotorrealistas, produzir estrutura fisicamente precisa e planejar sequências de ações, alternando entre modalidades de saída dependendo do que o consumidor downstream precisa. Ainda enfrentaremos vários desafios assustadores. O cenário de dados é desigual, com renderizadores inundados em vídeo da Internet enquanto simuladores e planejadores enfrentam escassez aguda de ativos 3D e demonstrações robóticas. Otimizar para a beleza visual pode sacrificar a precisão que um robô ou uma simulação de alta fidelidade precisa. Reconciliar essas tensões dentro de uma única arquitetura é o problema aberto definidor na pesquisa de modelos de mundo hoje, e é isso que o World Labs se propõe a fazer à medida que continuamos a evoluir o Marble.
GIF
A direção, no entanto, é clara. A mesma aposta que o campo vem fazendo desde o final dos anos 1980 — que um modelo suficientemente rico do mundo é tudo o que qualquer agente precisa para ver mundos, construí-los e agir neles — é a aposta que agora está impulsionando uma geração inteira de pesquisa. O que dá peso a essa "grande aposta" é a convergência já em andamento: três fios, cada um já impulsionando e moldando indústrias de vários bilhões de dólares por conta própria, que começaram como programas de pesquisa separados estão começando a se comportar como um só. Em conjunto, à medida que os limites entre eles colapsam, eles remodelarão algo maior: a relação entre a inteligência da máquina e o mundo físico que ela habita - o longo arco da inteligência espacial.
A linguagem deu às máquinas uma maneira de falar sobre esse mundo. Modelos de mundo são como as máquinas finalmente virão a entender, imaginar, raciocinar e interagir com ele.


