Transcrição de Vídeo
Transcrição de Vídeo
Pré-visualização
Descrição
Transcreva vídeos locais ou áudio para legendas SRT com carimbo de data/hora e texto simples, preferindo processamento local e suportando serviços de ASR remotos configurados com consentimento.
Habilidades relacionadas
Ver tudo Escrever
Áudio para rascunho
Converta um ficheiro de áudio, uma nota de voz, um vídeo falado ou uma transcrição num único rascunho coerente e editável. O texto em falta é transcrito automaticamente, com continuação em segundo plano quando necessário, para que não tenha de voltar para retomar o processo.
 Investigação
Áudio para tarefas e decisões
Transforme um ficheiro de áudio ou uma transcrição num registo conciso e editável de decisões, tarefas, responsáveis, datas, bloqueios e questões em aberto. O texto falado em falta é transcrito automaticamente, com continuação em segundo plano quando necessário, antes de serem propostas quaisquer ações opcionais do Agent.
 Investigação
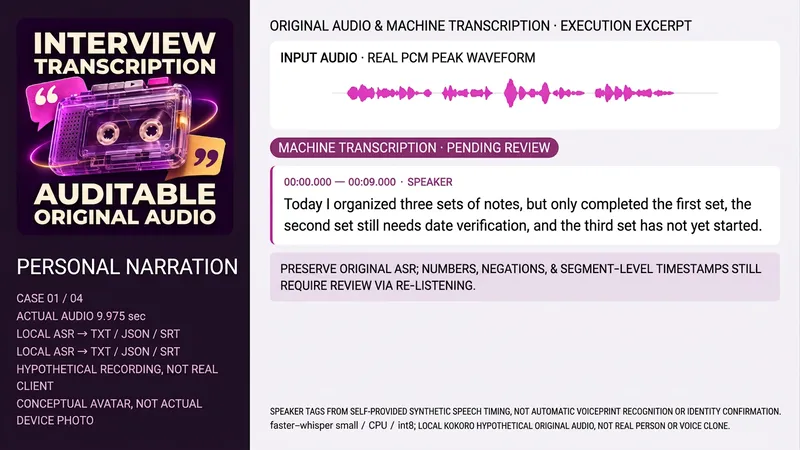
Transcrição de Entrevistas
Ideal para quem precisa de organizar gravações autorizadas de entrevistas, reuniões ou aulas. Forneça o ficheiro original, idioma, finalidade, transcrição anterior ou mapeamento de oradores fiável; não identifica identidades apenas por voz nem substitui o guião pelo que realmente se ouve. Preserva o áudio original e o hash, lê a duração/faixa de áudio, executa a ASR real, organiza por cronologia real, atribui oradores anónimos com base em evidências e verifica números, negações, nomes e dúvidas ouvindo o áudio original. Entrega TXT, JSON, SRT e notas de cobertura. O rascunho automático, a revisão auditiva e o resumo são separados; o que não for percetível mantém-se por verificar. Sem áudio ou ferramentas ASR, fica explicitamente por transcrever. Instruções e assistente local original incluído: Python3, FFmpeg/FFprobe, faster-whisper e cache small pré-configurada, CPU/int8, local_files_only, sem transferência automática de pesos. Com um speaker-map fiável, transcreve por janela e mapeia o tempo; sem mapeamento, o carater temporal é desconhecido. O assistente não faz separação automática de voz nem identificação de identidade. O pacote não inclui pesos, contas ou chaves. Quatro exemplos de teste com áudio original resumido em cerca de 40,875 segundos. Áudio original gerado localmente com versão fixa do Kokoro-82M (modelo Apache-2.0): zf_xiaobei, zm_yunjian, af_heart (sem clonagem de voz). Os quatro exemplos ASR geram TXT/JSON/SRT e os oradores derivam do tempo fornecido, sem separação automática. Ainda constitui um rascunho automático; a divergência no segundo exemplo carece de confirmação auditiva e não foi alterada indevidamente. A forma de onda baseia-se em picos PCM reais, não sendo decorativa. Recomenda-se o GPT para organização de texto, ficando a ASR dependente das ferramentas reais. Não foi chamada nenhuma API de transcrição da OpenAI nem executada CLI localmente. Avatar independente com imagem conceptual ImageGen, sem versão de modelo devolvida. Testado sem custos em ferramentas e transferências do YouMind; confirme com o ambiente real. A transcrição e a organização de oradores não garantem execução sem dependências após a instalação. Os 299 créditos correspondem ao preço de instalação, sem incluir modelos, APIs ou serviços terceiros, nem carregar faixas desconhecidas para serviços externos. Não garante ausência de erros, reconhecimento total de sotaques/ruído/sobreposição, exames judiciais, eficiência temporal ou eficácia comercial. Revisão auditiva pendente, sem publicitar verificação palavra a palavra.
Informações
- Versão
- v2
- Última atualização
- Créditos por execução
- Conforme a utilização
- Modelos
- Automático
