Відеотранскрипція
Відеотранскрипція
Попередній перегляд
Опис
Транскрибуйте локальне відео або аудіо в субтитри SRT з мітками часу та звичайний текст, віддаючи перевагу локальній обробці та підтримуючи налаштовані віддалені служби ASR за згодою.
Схожі навички
Переглянути всі Письмо
Аудіо в чернетку
Перетворює аудіофайл, голосову нотатку, відео з мовленням або транскрипт на один цілісний документ, який можна редагувати. Відсутній текст мовлення автоматично транскрибується, за потреби у фоновому режимі, тож користувачеві не потрібно повертатися, щоб продовжити процес.
 Дослідження
Аудіо в завдання й рішення
Перетворюйте аудіофайл або транскрипт на стислий редагований запис рішень, завдань, відповідальних осіб, дат, блокерів і відкритих питань. Відсутній текст мовлення автоматично транскрибується, за потреби у фоновому режимі, перш ніж буде запропоновано будь-які необов’язкові дії агента.
 Дослідження
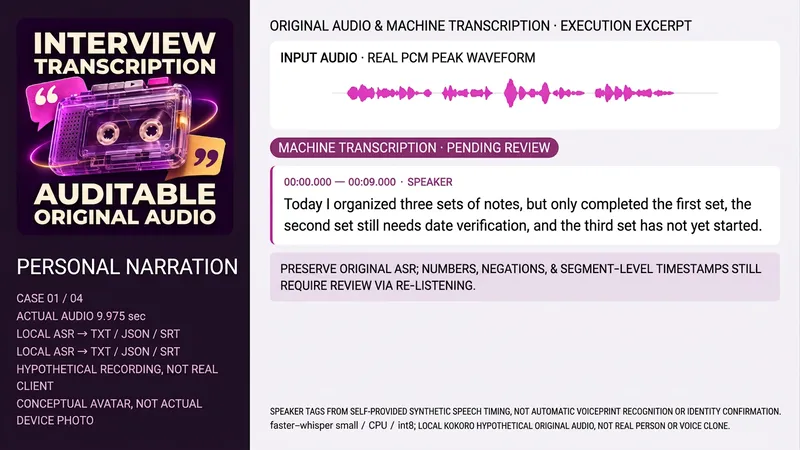
Транскрипція інтерв'ю з часом та мовцями
Підходить для тих, хто потребує впорядкування аудіозаписів авторизованих інтерв'ю, нарад або лекцій. Надайте вихідний файл, мову, призначення, наявну розшифровку або надійне часове зіставлення мовців; ідентифікацію неможливо підтвердити лише за голосом, а сценарії не перетворюються на реально почуте. Збереження оригінального звуку та хешу → зчитування тривалості/доріжки → фактичний ASR → впорядкування за реальним часом → позначення анонімних мовців за наявності підстав → звірка цифр, заперечень, імен та сумнівних місць із першоджерелом → видача TXT, JSON, SRT та пояснень щодо охоплення. Первинний машинопис, редагування під час прослуховування та зведення розділені; те, що неможливо розчути, залишається на перевірку і не дописується заради плавності. За відсутності аудіо чи інструментів ASR нерозшифровані частини чітко зазначаються. Інструкція та пакет містять повного оригінального локального помічника: Python3, FFmpeg/FFprobe, faster-whisper та заздалегідь налаштований кеш small, CPU/int8, local_files_only, без автоматичного завантаження ваги. Надійне зіставлення мовців надає маркери початку/кінця та анонімні мітки для фактичної розшифровки у вікні із зіставленням часу; без зіставлення час залишається невідомим. Помічник не виконує автоматичне розділення за голосом чи ідентифікацію особи, а пакет не містить ваги, облікових записів чи ключів. Чотири приклади містять самостійно підготовлені китайські особисті спогади, китайське інтерв'ю двох осіб, англійський опис курсу та китайську нараду двох осіб загальною тривалістю близько 40,875 секунд. Кінцевий звук синтезовано локально у фіксованій версії Kokoro-82M, зазначеній у картці моделі Apache-2.0 (zf_xiaobei, zm_yunjian, af_heart), це не живі голоси чи клонування; моделі, голоси чи аудіоприклади не поширюються з інсталяційним пакетом. Усі чотири приклади реального ASR згенерували файли TXT/JSON/SRT, а мовці взяті з наданих часових послідовностей синтезованих виступів, а не шляхом автоматичного поділу мовців. Наразі це все ще машинна чернетка; розбіжності між «випуском» ASR та «чернеткою» сценарію в другому прикладі підлягають повторному прослуховуванню для підтвердження і не були самовільно змінені на фактично сказані слова. Форма хвилі базується на реальних пікових значеннях вхідного PCM, а не є декоративною. Для впорядкування тексту рекомендується GPT, а ASR залежить від фактичних інструментів; локально не викликається API транскрипції OpenAI та не запускаються висхідні CLI. Незалежний аватар створено на основі концептуального візуального ряду ImageGen, інструмент не повертав модель, заяв про Image2 немає. Інструменти, кеш, завантаження файлів та прив'язка моделей YouMind не споживали бали під час тестування; необхідно підтвердити відповідно до фактичного середовища. Транскрипція та впорядкування мовців не гарантують роботу без залежностей після встановлення. 299 балів — це ціна встановлення, яка не включає моделі, API чи сторонні сервіси, не купує їх автоматично та не передає невідомі доріжки стороннім сервісам. Немає обіцянок нульової кількості помилок, повної розшифровки будь-яких акцентів, шумів чи накладання кількох голосів, судової або особистої ідентифікації, часової ефективності чи комерційного ефекту. Незалежне прослуховування та редагування додаються окремо, перевірка дослівних стенограм не рекламується.
Інформація
- Версія
- v2
- Останнє оновлення
- Кредити за запуск
- За фактичним використанням
- Моделі
- Автоматично
