“世界就是一切实际情况。” ——路德维希·维特根斯坦,
《逻辑哲学论》
,1921 年
世界不是由词语构成的。
在上一篇文章中,我们认为空间智能是 AI 的下一个前沿,而世界模型是实现它的路径。在此,我与 World Labs 团队希望深入一层:在如今正在构建并被称为“世界模型”的众多事物中,哪些功能模块真正构成了这种能力——每个模块又各自承担什么作用?
语言模型赋予了机器对概念、词汇和推理的非凡掌控力,但物理世界——无论是虚拟还是现实——运行在完全不同的底层之上。语言模型学习的是文本的统计结构,而世界模型学习的是空间与时间的统计结构:光线如何在表面上投射,花园从某个从未被相机捕捉过的角度看起来是什么样子,物体如何响应力并遵循物理定律。
这使得“世界模型”成为当今 AI 中最重要但也最被滥用的术语之一。计算机视觉、机器人学、强化学习和生成式 AI 都宣称自己在构建世界模型,但各自所指的含义大相径庭。一个能生成华丽但物理上不可能实现的火焰的视频模型、一个即兴创作可玩游戏的语言模型,以及一个忠实模拟燃烧过程的物理引擎——它们全都顶着同一个名字。
古希腊人从未就世界的构成达成一致,无论是火、水还是不可分割的原子,因为“世界”从来就不是单一的事物。它总是某个思想家需要推理的整体性的代名词。AI 继承了这个相同的问题,恰逢该领域需要精确性的关键时刻。
分类法底层的循环
要厘清这种混乱,需从一张比任何相关技术都更古老的图表入手。强化学习教科书——包括经典之作 Sutton 和 Barto 的版本——几十年来一直使用这个图的变体来描述 Agent 如何与世界交互。这个图的正式名称是部分可观察马尔可夫决策过程(POMDP),而“世界模型”这一术语的原始定义正源于此传统。
一个 Agent(可以是人、机器人或软件系统)会采取行动。这些行动影响世界的状态。Agent 永远无法直接看到状态。到达 Agent 的是观测:落在视网膜上的光子、传感器的读数、视频帧中的像素。新的观测驱动新的行动,循环持续进行。
“状态”一词需要解包,因为其含义在不同领域间有所变化。这不是化学家的状态(固体、液体、气体的区别),而是物理学家和机器人学家的状态:对某一时刻世界中发生的一切的完整描述,包括每个物体、每个位置、每个速度、每个属性。状态是世界底层的现实;原则上完整,但任何身处其中的 Agent 都无法直接看到。观测是 Agent 对该现实的不完整视图。行动是 Agent 对此做出的回应。
这个循环——从 Agent 到行动到状态到观测再回到 Agent——赋予了现代术语“世界模型”其技术含义。这个短语本身更古老,可追溯到 Kenneth Craik 在 1943 年提出的心智通过运行“现实的小规模模型”进行推理的设想,并在 20 世纪 80 年代末和 90 年代初被引入神经网络。这个循环也解释了今天人们使用该术语时的含义。如今被称为世界模型的不同事物,实际上都是该循环的不同投影。每个事物输出的是该循环的不同部分。
世界模型的三种功能
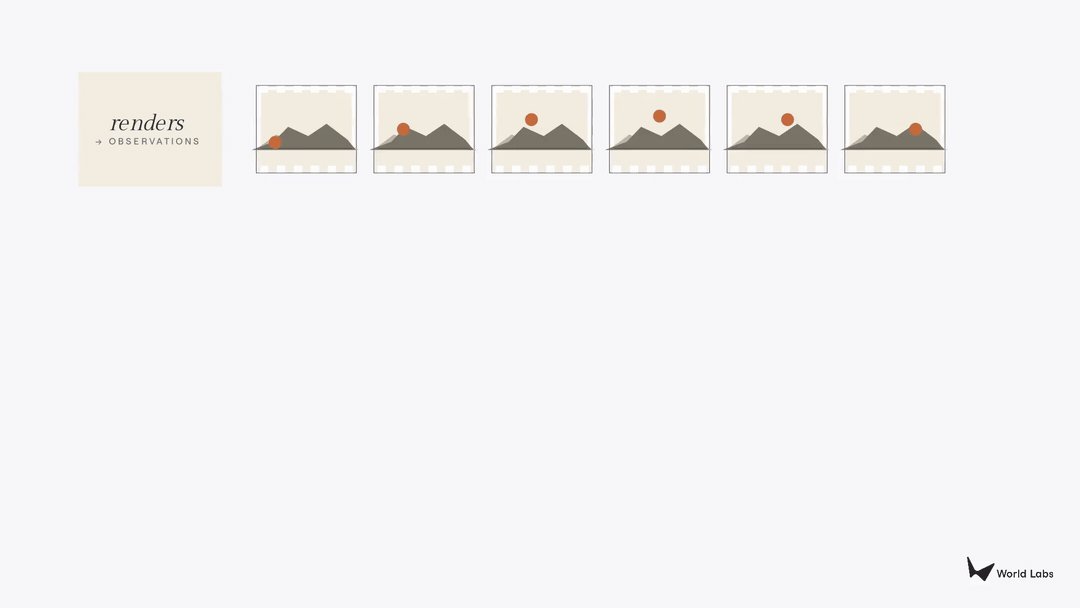
第一种世界模型是渲染器。 渲染器输出以人为目的像素形式的观测,最重要的质量指标是视觉保真度。 一个将文本提示转化为电影级无人机镜头的视频模型就是渲染器。同样,像 Google 的 Genie 3 或 World Labs 自家的 RTFM 这样的交互式系统,模型根据用户输入实时生成帧,也属于渲染器。模型不包含对三维结构的显式理解。它产生的是观察者会看到的东西,而非真实的存在。无人机镜头中的建筑物从上方看可能完美无缺,但若试图在下面的城市中穿行,它们就会坍塌。
第二种是模拟器。模拟器输出状态:对世界的几何、物理或动态上忠实的表示,人类和计算机程序都可以在上面计算和交互。 渲染器只负责视觉,而模拟器的契约是结构性的,要求几何经得起检查,物理尊重牛顿定律,动态行为遵循物理定律所要求的方式。模拟器同时服务于两类消费者。人类专业人士——如建筑师、设计师、电影制作人和游戏开发者——需要超越视觉合理性的准确性。计算机程序——如强化学习 Agent、机器人控制器和自动驾驶车辆——则将模拟器作为训练场,在其中大规模与世界交互,测试那些在现实中可能危险、昂贵或无法运行的场景。
第三种是规划器。规划器输出行动。 给定一个观测和一个目标,规划器回答 Agent 下一步应该做什么的问题。这在很多方面是渲染器的逆过程。渲染器以行动为输入并产生观测,而规划器以观测为输入并产生行动,从而闭合感知-行动循环。视觉-语言-行动模型、基于模型的系统以及新一波的世界行动模型(World Action Models)都是规划器的尝试:能够在非结构化世界中决定机器人应如何行动。
这三个类别描述了当今实际交付的大部分内容,它们之间的区分在实践中很有用。然而,这些类别并非根本性分离。支撑所有这三种功能的,是同一套关于世界如何运作的底层知识——几何、物理、动力学。一个能够从任何角度渲染杯子的模型,原则上也应该能够模拟杯子被推后会发生什么,并规划出手去拿起杯子。越来越有趣的研究正在有意模糊这三者之间的界限。
GIF
为何模拟器是关键
在这三类中,模拟器获得的公众关注最少,却是三者中影响最大的。本文旨在解决这种不平衡。
渲染器在商业上最为成熟。 许多图像或文本到视频的产品正在消费者或企业市场快速扩张。Google 的 Nano Banana 模型已将渲染器质量的图像生成交到潜在数亿用户手中。技术是真实的,市场也是真实的。然而,渲染器优化的是视觉合理性而非物理准确性,这个天花板很重要。它们的输出很美,但不能被信任用来设计建筑或训练机器人。
规划器是最引人入胜也最不成熟的, 与快速演进的机器人学习领域紧密相连。过去两年,该领域产出的机器人演示在视频中看起来令人印象深刻,但需要坦诚地看待这些演示实际展示的内容。几乎所有这些演示都局限于高度受控的实验室环境,物体集合狭窄,任务时间跨度短。没有一个在真实世界部署所要求的复杂性、变异性或持续时间上得到验证。一个令人信服的演示集锦与一个能在厨房、仓库或手术室中可靠工作的机器人之间的差距依然巨大。尽管如此,商业赌注依然可观。一波资金雄厚的入局者正竞相推出通用规划系统,而最大的基础设施玩家则将其规划技术置于更广泛的模拟栈之上。一个能规划的机器人就是一个能工作的机器人,整个行业都在争抢率先抵达终点。
模拟器是两者之间的桥梁。 如果语言是世界的抽象,像素是世界的投影,那么几何、物理和动力学就是世界本身。模拟器必须在这个层面工作:它是结构性的骨干,从中可以推导出视觉外观(供渲染器使用)以及行动后果(供规划器使用)。
一个掌握了模拟的模型,可以将其理解投影为供人类消费的像素,以及供具身 Agent 使用的行动预测。而仅掌握渲染或仅掌握规划的模型,两者都无法做到。商业潜力巨大。仅 NVIDIA 的 Omniverse 就瞄准了公司估计价值超过一万亿美元的可寻址市场,涵盖工厂、仓库、供应链和数字孪生。机器人训练、自动驾驶测试、建筑可视化、工程设计和药物发现都依赖于某种类似模拟的东西。
该领域最难的开放性问题也在此处。具有显式几何、材料属性和物理标注的三维数据,其稀缺程度比渲染器训练所依赖的互联网视频高出几个数量级。模拟到现实的差距(sim-to-real gap)——即事物在模拟中的行为与在现实中的行为之间的差异——依然存在。生成式模拟器在此基础上引入了新的风险:AI 生成的几何结构看似正确,却可能包含自相交或错误的尺度,从而产生无意义的物理行为。大规模多物理场模拟——涉及刚体、可变形物体、流体和布料之间的交互——其成本比单域模拟高出数个数量级。
在 World Labs,Marble 是我们进入这一领域的首次尝试。它接受多模态提示(文本、图像、视频或空间草图),生成可探索的 3D 环境,同时输出高斯泼溅以进行视觉探索,以及物理引擎可操作的碰撞网格。但 Marble 只是一个更长故事的第一章,这个故事正在整个领域中被书写——随着渲染、模拟和规划之间的界限开始崩塌。
边界正在何处崩塌,下一步是什么
但更多的还在后面。当前领域最重要的趋势是:这三个类别开始相互融合。共同的洞察是:渲染一个世界、模拟它并在其中行动所需的知识在很大程度上是相同的。延续之前的例子,一个真正理解杯子如何放在桌面上的模型(其几何、材料属性、对力的响应等),应该能够从任何角度渲染杯子,模拟杯子被推后会怎样,并规划出手去拿起杯子。这三个类别是同一个底层理解的三个投影。
例如:来自各个机器人实验室的少量但不断增长的最新工作已经证明——至少在概念上——预训练的视频渲染器可以用作联合世界与行动预测的骨干网络,暗示着渲染器和规划器之间的桥梁:让一个模型既能想象会发生什么,又能决定该做什么。World Labs 的 Marble 已经从单一模型同时输出高斯泼溅和碰撞网格,消解了渲染器和模拟器之间的边界。每一个层次都在从被动输出转向交互式系统, 渲染器变得依赖行动,模拟器生成更可控、更可编辑的世界,规划器则进行深思熟虑而非仅仅反应。
逻辑上的终极目标是统一的世界模型:一个基础模型,既能渲染逼真的视图,又能产生物理上准确的结构,还能规划行动序列,根据下游消费者的需求在输出模态间切换。 我们仍将面临大量艰巨挑战。数据状况不均衡:渲染器被互联网视频淹没,而模拟器和规划器则面临 3D 资产和机器人演示的严重短缺。优化视觉美感可能会牺牲机器人或高保真模拟所需要的精度。在单一架构内调和这些矛盾,是当今世界模型研究中决定性的开放问题,而这正是 World Labs 在继续发展 Marble 时着手去做的事情。
GIF
然而,方向是清晰的。自 20 世纪 80 年代末以来,该领域一直在下的同一个赌注——足够丰富的世界模型就是任何 Agent 看到世界、构建世界并在其中行动所需的全部——如今正驱动着整整一代研究。这个“大赌注”之所以分量重,是因为已经发生的融合:三条各自在驱动和塑造数十亿美元产业的道路,最初作为独立的研究计划开始,如今开始表现得像一条。当它们之间的边界崩塌时,它们将重塑更宏大的事物:机器智能与其所栖身的物理世界之间的关系——空间智能的漫长弧线。
语言给了机器谈论那个世界的方式。世界模型将是机器最终得以理解、想象、推理并与之交互的方式。


