展示内容
描述
一个基于两轮实测语料(共 1,169 篇、约 520 万汉字、100+ 项指标、约 50 万次模型语义判断)的去 AI 味 skill,lieflat-less-ai-tone ,在 GitHub 有 7.3K+ Star。 该 Skill 基于两轮数据实验来量化“什么是 AI 味”,第一轮 629 篇文章(283 万字),第二轮新跑了 540 篇配对文章(256 万字),前后包括 1169 篇文章,一共 520 万汉字。 Skill 把市面上能想到的“AI 味”拆成了 100 多项指标,用脚本检测、大模型语义检测和人工盲评三种方式检验,跑了 50.7 万次逐句逐段的机器语义判断,最后还做了大量人工盲读测评。 最后,选择了 Skill 这个方式来呈现,方便大家使用,也就有了 lieflat-less-ai-tone 这个项目。 Skill 会先交付有指标、研究参照、原文例句和改法的检测报告,用户回复后再改写和复测。
推荐自
Dancang
为什么我们推荐这个技能
基于大规模对照语料与多轮语义复测,先检测、解释证据,再经确认最小改写并复测。它不靠词表乱删,而是区分统计信号、语义判断与人审边界,守住事实、风格和原文结构。
适合人群
适合希望减少文本中 AI 写作痕迹、同时保留原意、事实和文章结构的写作者。
如何使用此 Skill
提供输入
提供需要检查的文章或文本,并可说明希望关注的范围。
运行 Skill
先分析文本中的疑似 AI 写作痕迹,给出带例句和改法的检测报告;收到确认后,再按选定建议进行最小改写并复测。
查看结果
获得改前检测报告、改写后的文本,以及改写前后的对比结果。
相关技能
查看全部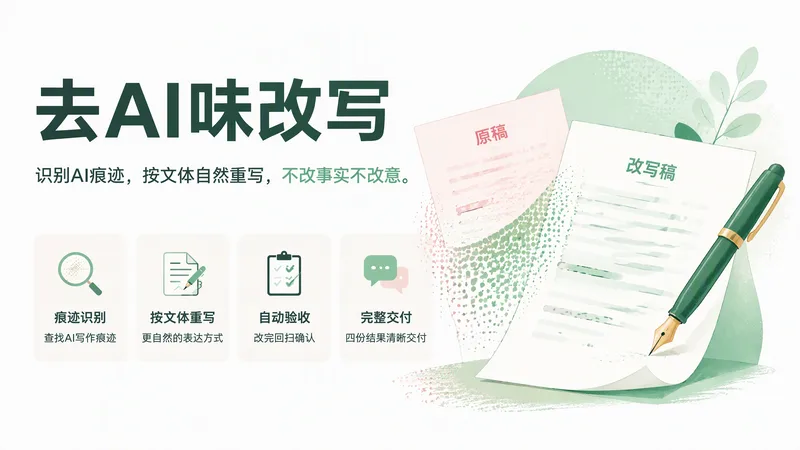 写作
中文去AI味改写
把中文稿件改得更像真实的人在特定场景下写出来,同时保留原有事实、立场和语气强度。无论是微信消息、邮件、小红书、工作报告还是论文,都能先识别文体与表达问题,再针对性清理套话、空泛表达、机械结构、名词化句式和不合场景的语气,让文字更具体、自然、顺口,但不过度口语化。 改写时会严格守住事实边界:不擅自增加数字、日期、人名、机构、案例、承诺或效果,不把“可能”改成“一定”,也不删掉关键限定和结论。原文缺少必要信息的地方,会明确标记待补内容,避免为了让文章完整而编造细节;论文和工作报告中的规范正式表达,也不会被误判为“AI味”而强行改轻。 你将得到经过事实复核和二次检查的中文改写结果,适合直接用于沟通、发布、汇报或学术写作。需要时还可查看具体的痕迹判断、改动依据和待补信息,清楚了解哪些地方被调整,以及如何确保改写前后的信息完整一致。
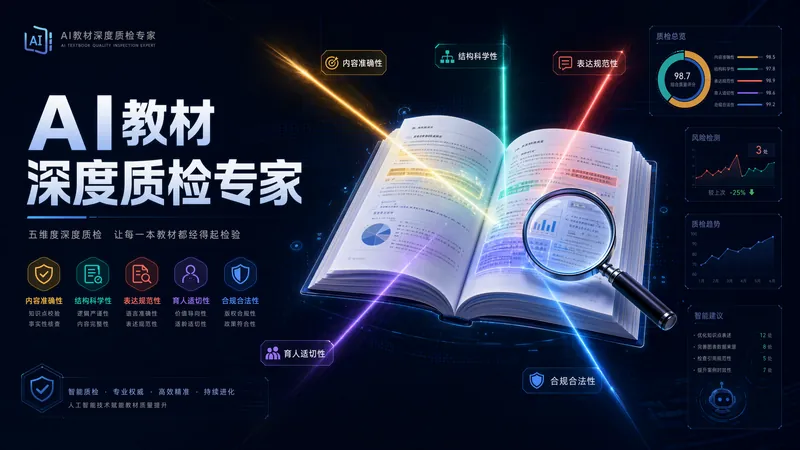
AI教材深度质检专家
📚 AI教材深度质检专家 — 五维扫描,让AI写的教材经得起审稿 AI辅助撰写的教材有五个通病:知识错误难自查、教学设计没课堂感、大量"正确的废话"、模板化像机器写的、晦涩难懂学生弃读。本系统逐章执行五维深度质检,从学科专家、教学设计师、事实核查员、文体鉴定师四个角色审视每一章,输出量化评分和可直接替换的修改建议。 五大维度: 📐 知识准确性 — 概念、模型、数据逐一溯源纠正,每条错误标注来源 🎯 教学设计 — 难度曲线、前置铺垫、章节衔接,像资深教师一样审视 💎 内容实质性 — 揪出"正确的废话",计算每一节真实信息增量 🤖 AI味检测 — 教材专属标准,区分正常写法与AI模板套路 📖 可读性 — 段落节奏、术语密度,评估学生能否顺畅读完 亮点功能: 🔗 跨章一致性 — 自动生成知识档案,检测概念矛盾、术语不一致、重复定义 🔄 闭环迭代 — 修改后重新提交,自动追踪改善项、遗留项、新问题 📊 分层报告 — 先看总览评分+TOP3问题,再按需展开逐段分析 🎤 说话犀利 — 不粉饰太平,该说"这个定义错了"绝不含糊,每条批评附带修改参考 适用:AI辅助撰写的本科及研究生教材、学术专著、课程讲义。当前版本针对本科教材优化,研究生教材同样适用。粘贴章节 → 获取评分 → 针对性修改 → 重新检测,直到质量过关。
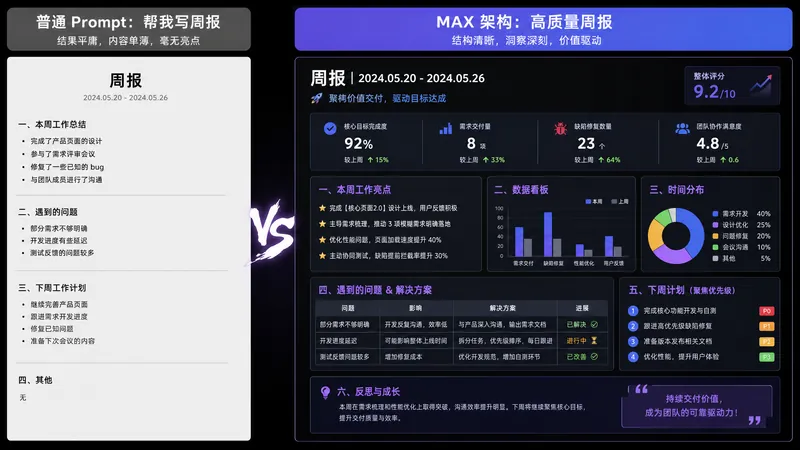
AI 提示词架构师 MAX | 把模糊需求编译成顶级Prompt
你有没有过这种时刻—— 让 AI 写周报,它给你一篇小学生流水账; 让 AI 改简历,它给你套「团结、勤奋、认真负责」; 让 AI 帮你分析数据,它开头一句「作为一个AI,我很乐意帮您……」 不是 AI 不行,是你给它的指令太业余。 市面上教你 Prompt 的模板已经够多了,但你套完模板还是不会写——因为你缺的不是模板,是编译需求的能力。 这个 SKILL 是我作为 AI OPC(一线做 AI 落地的人),把日常给团队写 Prompt 架构的方法论,压缩成了一个「Prompt 编译器」。 你说人话,它给你顶级架构。 输入:「帮我写月报」 输出:一份 8 模块的完整 Prompt 架构 —— 角色、任务、受众、流程、约束、格式、自检、示例,全部锁死。你复制粘贴到 ChatGPT / Claude / DeepSeek / Kimi 任意一个,第一次输出就能用。 更狠的是,它还会告诉你: ✓ 这份 Prompt 用哪个模型效果最好 ✓ 哪些变量下次可以直接改(一次学会,反复使用) ✓ 还差哪 1 条信息可以让输出再上一个台阶 它和普通 Prompt 模板 SKILL 有什么不同? 别的 SKILL 给你鱼(一个成品 Prompt); 这个 SKILL 给你编译器(把任何需求编译成 Prompt 的能力)。 装一次,你所有AI 使用场景都会升级——写作、汇报、分析、翻译、客服、创作,全部通吃。 谁应该装它: 每天都在用 AI,但每次都对输出不满意的打工人 想学 Prompt 工程但不想花几千块报课的人 团队要把 AI 用起来但不知道怎么标准化的负责人 内容创作者、研究者、学生、求职者、副业玩家 AI 用得好不好,不看你用哪个模型,看你会不会编译需求。 装上它,从今天开始,你和 AI 的对话质量会有一个断层式的提升。
信息
- 版本
- v4
- 更新时间
- 运行积分
- 按实际用量
- 模型
- 自动选择
- 使用场景
- 写作与内容
- 你将获得
- 报告文档
