Bio/Med深度可靠调研
Bio/Med深度可靠调研
展示内容
描述
适用场景:完成一轮生物/生物医学类科研文献检索并给用户提供详实可靠的输出 1. 用户发起检索后系统拆解问题和关键词 2. 使用公开、可复现的数据源检索文献 3. 对检索结果进行去重、分层、证据分级和排序 4. 回复中使用可点击正文引用 5. 文末逐条列出完整文献信息,并用公开可查路线标注 IF;如果无法高置信核验,必须标为“待核验”或“未检出”。
推荐自
Nico@YouMind
为什么我们推荐这个技能
这项技能是生物医学研究的可靠指南,通过结构化查询、多阶段文献筛选和严谨的IF核查,确保提供高度准确且可验证的科研信息。
指令
这套流程的核心是:先用多 query 在 PubMed / NCBI E-utilities 做可复现初筛,再用 PMID 去重和摘要证据分级;只有少量关键文献进入 PMC / BioC 全文复核;正文引用必须可点击;文末必须列完整文献信息;IF 只能通过公开可访问来源保守核查,不能默认有 JCR 或本地数据库,不能猜,不能把低置信匹配当成确定结果。
1. 用户发起检索后的预处理
1.1 先解析用户问题
收到用户问题后,先把自然语言问题拆成结构化要素。
必须识别:
• 研究对象:基因、蛋白、药物、通道、细胞类型、组织、疾病、模型。
• 生物系统:人、小鼠、大鼠、斑马鱼、类器官、视网膜、脑区、细胞系等。
• 关系类型:表达、调控、功能、机制、表型、死亡、生存、治疗、毒性、发育、退化等。
• 证据需求:是否需要直接证据、机制证据、全文证据、图表、剂量参数、实验方法。
• 时间范围:不限时间、近 5 年、近 1 年、最新进展、经典文献。
• 输出类型:简答、代表文献、综述式总结、实验设计建议、证据表、机制图谱。
示例:
用户问题:
“帮我找视网膜类器官死亡相关文献。”
结构化拆解(示例):
• 核心模型:retinal organoid, retina organoid, hPSC-derived retinal organoid, optic cup organoid。
• 表型:cell death, apoptosis, degeneration, survival loss, stress, necrosis。
• 相关细胞:photoreceptor, cone, rod, retinal ganglion cell, Müller glia。
• 潜在机制:oxidative stress, ER stress, mitochondrial dysfunction, hypoxia, inflammation, ferroptosis, necroptosis。
• 证据目标:优先找直接在人源或动物源 retinal organoid 中观察到细胞死亡/凋亡/退化的原始研究;再找间接机制文献。
1.2 关键词拆分原则(示例)
不要只写一个检索式。每个概念至少准备三类词。
第一类:精确词。
• retinal organoid
• retina organoid
• human retinal organoid
• hPSC-derived retinal organoid
• iPSC-derived retinal organoid
第二类:同义词和上位词。
• optic cup organoid
• 3D retinal culture
• stem cell-derived retina
• retinal differentiation
• retinal tissue model
第三类:机制和表型词。
• apoptosis
• cell death
• degeneration
• survival
• stress
• oxidative stress
• ER stress
• mitochondrial dysfunction
• hypoxia
• necroptosis
• ferroptosis
如果用户限定细胞类型,加入:
• photoreceptor
• cone
• rod
• retinal ganglion cell
• Müller glia
• bipolar cell
• amacrine cell
如果用户限定物种或来源,加入:
• human
• mouse
• rat
• zebrafish
• hESC
• iPSC
• pluripotent stem cell
1.3 生成分层检索式
至少生成 3–6 组 query。每组 query 对应一个检索目的。
第一层:直接证据检索。
用于找目标模型 + 目标表型直接命中的文献。
```text
("retinal organoid" OR "retina organoid" OR "human retinal organoid") AND (apoptosis OR "cell death" OR degeneration)
```
第二层:扩展模型检索。
用于捕捉作者没有使用 retinal organoid 精确词但实际相关的文献。
```text
("optic cup organoid" OR "3D retinal culture" OR "stem cell-derived retina") AND (survival OR apoptosis OR stress)
```
第三层:机制专项检索。
用于验证具体通路或机制。
```text
("retinal organoid" OR "retina organoid") AND ("oxidative stress" OR "ER stress" OR hypoxia OR mitochondria)
```
第四层:细胞类型专项检索。
```text
("retinal organoid" OR "retina organoid") AND (photoreceptor OR cone OR rod OR "retinal ganglion cell") AND (death OR apoptosis OR degeneration)
```
第五层:疾病模型检索。
```text
("retinal organoid" OR "retina organoid") AND (disease OR degeneration OR dystrophy OR retinitis OR glaucoma)
```
第六层:综述/背景检索。
```text
("retinal organoid" OR "retina organoid") AND (review OR protocol OR model)
```
2. 使用什么方法、在什么网站检索
2.1 首选:PubMed / NCBI E-utilities
PubMed 是生物医学文献检索首选。不要默认抓 PubMed 网页。应使用 NCBI E-utilities API。
2.1.1 ESearch:用 query 获取 PMID
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi
```
参数:
```text
db=pubmed
term=<检索式>
retmode=json
retmax=20
sort=relevance
```
也可按时间排序:
```text
sort=pub+date
```
示例:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=pubmed&term=(%22retinal%20organoid%22%20OR%20%22retina%20organoid%22)%20AND%20(apoptosis%20OR%20%22cell%20death%22)&retmode=json&retmax=20&sort=relevance
```
返回中读取:
```text
esearchresult.idlist
```
这就是 PMID 列表。
2.1.2 ESummary:获取文献 metadata
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi
```
参数:
```text
db=pubmed
id=PMID1,PMID2,PMID3
retmode=json
```
提取字段:
• PMID
• title
• fulljournalname
• source / journal abbreviation
• pubdate
• authors
• articleids 中的 DOI、PMCID
• volume、issue、pages
2.1.3 EFetch:获取摘要和 XML 细节
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi
```
参数:
```text
db=pubmed
id=PMID1,PMID2
retmode=xml
rettype=abstract
```
提取字段:
• ArticleTitle
• AbstractText
• Journal Title
• ISOAbbreviation
• ISSN / eISSN
• PubDate
• DOI
• PMCID
• MeSH terms
2.1.4 批量检索策略
推荐流程:
1. 对每个 query 调用 ESearch。
2. 每个 query 取前 5–20 篇。
3. 合并所有 PMID。
4. 按 PMID 去重。
5. 用 ESummary / EFetch 批量获取 metadata 和 abstract。
6. 初筛阶段只读 metadata + abstract,不要一开始抓全文。
────────────────
2.2 第二阶段:PMC / BioC 全文复核
只有以下情况才进入全文:
• 用户要求精读全文。
• 摘要不足以判断机制。
• 需要图表、实验方法、浓度、剂量、IC50、EC50、Kd、Ki。
• 已筛出少量关键 PMID,需要逐篇机制复核。
2.2.1 PMID 转 PMCID
接口:
```text
https://www.ncbi.nlm.nih.gov/pmc/utils/idconv/v1.0/?ids=<PMID>&format=json
```
如果返回 PMCID,说明可能有 PMC 开放全文。
2.2.2 优先 BioC JSON
接口:
```text
https://www.ncbi.nlm.nih.gov/research/bionlp/RESTful/pmcoa.cgi/BioC_json/<PMCID>/unicode
```
优点:结构化程度高,适合抽取正文段落。
2.2.3 BioC 不可用时尝试 PMC XML
接口:
```text
https://www.ncbi.nlm.nih.gov/pmc/articles/<PMCID>/?report=xml
```
抽取正文时跳过:
• references
• bibliography
• acknowledgements
• author contributions
• competing interests
全文复核必须设置停止判据:
• 每篇文献只扫描一次。
• 默认只抽取与问题相关的段落。
• 如果未命中目标字段,标注“未见直接证据”。
• 不要无限换关键词重复抓取。
────────────────
2.3 bioRxiv / medRxiv
用于补充最新预印本。
可以使用官方 API:
```text
https://api.biorxiv.org/details/biorxiv/YYYY-MM-DD/YYYY-MM-DD
https://api.biorxiv.org/details/medrxiv/YYYY-MM-DD/YYYY-MM-DD
```
也可用普通搜索作为补充:
```text
site:biorxiv.org retinal organoid apoptosis
site:medrxiv.org retina organoid degeneration
```
预印本必须标注:
```text
预印本,未经同行评议。
```
────────────────
2.4 Crossref / OpenAlex / Unpaywall
用于补全 DOI、开放全文地址、出版信息。
Crossref:
```text
https://api.crossref.org/works?query.title=<title>
```
OpenAlex:
```text
https://api.openalex.org/works?search=<title or topic>
```
Unpaywall:
```text
https://api.unpaywall.org/v2/<DOI>?email=<your_email>
```
用途:
• DOI 补全。
• OA PDF 链接查找。
• 期刊名核验。
• 出版年份核验。
────────────────
2.5 出版商页面
只有在 API 信息不足时才访问出版商页面。
访问规则:
• 每个出版商 URL 只尝试一次。
• 遇到验证码、登录墙、Cloudflare、Access Denied、机构权限墙,立即停止。
• 不要反复刷新、换同站路径、循环等待。
• 改用 PubMed、PMC、Crossref、OpenAlex、Unpaywall、DOI metadata 兜底。
3. 检索后如何整理信息
3.1 建立统一记录结构
每篇文献整理成统一 record。
字段:
```text
pmid
doi
pmcid
title
authors
journal
journal_abbrev
issn
eissn
year
abstract
query_source
evidence_level
evidence_tags
paper_type
url
```
3.2 去重
优先级:
1. PMID 去重。
2. 没有 PMID 时用 DOI 去重。
3. 没有 DOI 时用 lower(title) + year + first_author 去重。
保留第一次命中的 query_source,同时记录该文献被哪些 query 命中。
3.3 证据分级
必须区分:
直接证据:
目标物种、组织、细胞类型、模型、处理条件直接命中。
间接证据:
相邻系统、相似模型、相近机制支持,但不是用户问题的直接系统。
未见直接证据:
只能找到背景、推测、综述或相邻模型,没有直接实验结果。
3.4 文献类型标注
至少标注:
• original research
• review
• protocol
• preprint
• dataset/resource
• clinical study
• method paper
3.5 排序规则
推荐排序:
1. 直接证据原始研究。
2. 关键机制研究。
3. 最新重要研究。
4. 经典奠基研究。
5. 高质量综述。
6. 间接证据。
不要只按 IF 排序。IF 是期刊层面指标,不等于单篇文献质量。
4. 回复中如何组织引用
4.1 正文引用格式
正文引用必须可点击。
格式:
```markdown
[[1. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
```
示例:
```markdown
已有研究在人源 retinal organoids 中观察到发育阶段相关的光感受器应激和退化现象[[1. **Cell Stem Cell**, 2019]](https://pubmed.ncbi.nlm.nih.gov/xxxxxxx/)。
```
不要写成:
```text
[1]
(PMID: xxxxx)
见文献1
```
4.2 推荐回答结构
第一段:直接结论。
```text
结论:已有相关报道,但直接证据主要集中在……;关于……仍缺少直接证据。
```
第二段:证据分级。
```text
直接证据:
- 文献 A:……
间接证据:
- 文献 B:……
未见直接证据:
- 本轮未找到……
```
第三段:机制归纳。
按主题分组,例如:
• apoptosis / caspase pathway
• oxidative stress
• mitochondrial dysfunction
• ER stress
• hypoxia / metabolic stress
• inflammation
• developmental mismatch
第四段:研究空白。
明确说明哪些问题没有直接证据。
第五段:实验启发。
如果用户需要实验设计,给出 marker、assay、time point、control。
5. 文末完整文献信息列表
只要正文引用具体文献,文末必须附完整列表。
格式:
```markdown
## 完整文献信息列表
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Qn}*
2. Wang X et al., **Journal Name** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=待核验}*
```
作者格式:
• 1–3 位作者:列出全部。
• 超过 3 位:第一作者 et al.
PMID / DOI / URL 必须可点击。
6. IF 核查与标注
6.1 先说明 IF 核查的现实限制
正常情况下,官方 Journal Impact Factor 来自 Clarivate Journal Citation Reports(JCR)。但任意外部 Agent 通常没有 Clarivate/JCR 账号,也没有本地 JCR 表,所以不要通过这个路径核查。
```
6.2 IF skill 的实际方法
主要路线:
1. 如果输入是 PMID,先用 NCBI E-utilities 获取 PubMed metadata。
- 获取 FullJournalName。 - 获取 Source / ISO abbreviation。 - 获取 ISSN / eISSN。 - 获取标题、年份、DOI 等辅助字段。
2. 用公开的 iikx / 爱科学移动端 JSON 接口查询期刊。
搜索接口:
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=<journal_query>
```
详情接口:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=<id>&classid=<classid>
```
3. 对搜索结果做保守匹配。
- 优先 exact normalized journal title match。 - 其次 exact abbreviation match。 - 对短词和宽泛词非常谨慎。 - 不接受明显 substring 误配,例如 Nature 被误配成 Nature Reviews 系列。 - 如果匹配不稳,返回 ambiguous / not_found,而不是猜。
4. 如果 PubMed 给的是缩写,尝试用 NLM Catalog 扩展为全称或 alternate title。
NLM Catalog 搜索接口仍然是 NCBI E-utilities:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=<abbr>[Title Abbreviation]&retmode=xml&retmax=1
```
然后用 ESummary 取 Title / TitleAlternate。
5. 从 iikx detail 结果中读取:
- impact factor。 - IF 年份。 - JCR quartile。 - CAS / 中科院分区,如果有。 - source URL。 - match confidence。
6. 标注时不把 IF 年份写进正文紧凑标注。
最终标注只写:
```text
*{IF=X,Qn}*
```
如果失败:
```text
*{IF=待核验}*
```
或:
```text
*{IF=未检出}*
```
6.3 具体步骤
对每篇文献执行以下流程。
第一步:准备期刊查询名。
优先从 PubMed metadata 取:
```text
FullJournalName
ISOAbbreviation / Source
ISSN
eISSN
```
如果只有 DOI,则先用 Crossref 或 OpenAlex 取期刊名。
Crossref:
```text
https://api.crossref.org/works/<DOI>
```
OpenAlex:
```text
https://api.openalex.org/works/https://doi.org/<DOI>
```
第二步:规范化期刊名。
规范化规则:
• 全部小写。
• HTML unescape。
• 将 & 替换为 and。
• 去除标点。
• 多个空格合并。
• 比较时可同时使用 compact 形式,即去除所有空格。
示例伪代码:
```python
import re, html
def norm(s):
s = html.unescape(s or '').lower()
s = re.sub(r'&', ' and ', s)
s = re.sub(r'[^a-z0-9]+', ' ', s)
return re.sub(r'\s+', ' ', s).strip()
def compact(s):
return norm(s).replace(' ', '')
```
第三步:查询 iikx 搜索接口。
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=<journal_query>
```
建议设置 User-Agent,例如:
```text
Mozilla/5.0
```
如果第一页没找到 exact match,可以有限翻页,例如最多 8 页。
翻页参数通常为:
```text
page=2
page=3
```
第四步:从搜索结果中选候选。
候选字段通常包括:
```text
id
classid
title
smalltitle
IF 或 IF2024
zky2020
url
```
匹配规则:
• 如果 compact(query) == compact(candidate.title),接受。
• 如果 norm(query) == norm(candidate.title),接受。
• 如果 compact(query) == compact(candidate.smalltitle),接受。
• 如果 norm(query) == norm(candidate.smalltitle),接受。
• 如果只是 substring,不要直接接受,除非 query 足够长且无歧义。
• 对 Nature、Science、Cell、Brain、Vision、Retina 等短词尤其谨慎。
第五步:如果没有匹配,用 NLM Catalog 扩展缩写。
例如 PubMed 里 Source 是:
```text
Free Radic Biol Med
```
可以查:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=Free%20Radic%20Biol%20Med%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1
```
拿到 NLM Catalog ID 后,再用:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=nlmcatalog&id=<id>&retmode=xml
```
读取:
```text
Title
TitleAlternate
```
然后用这些全称再查 iikx。
第六步:查 iikx 详情接口。
如果搜索结果里有:
```text
id=<id>
classid=<classid>
```
调用:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=<id>&classid=<classid>
```
从 detail 中读取:
```text
IF2024, IF2023, IF2022 ...
IF
zky2020 或其他 JCR quartile 字段
jcr22 / jcr12 或分区字段
issn
eissn
title
smalltitle
category
```
第七步:选择最新 IF。
在返回字段中查找所有形如:
```text
IF20xx
```
例如:
```text
IF2024
IF2023
IF2022
```
选年份最大的有效数字。
如果没有 IF20xx,则尝试读取:
```text
IF
if_value
```
如果没有有效值,则标为未检出。
第八步:输出置信度和标注。
如果 exact title / abbreviation 命中,并且 detail 返回有效 IF:
```text
*{IF=X,Qn}*
```
如果匹配不确定:
```text
*{IF=待核验}*
```
如果公开接口没有结果:
```text
*{IF=未检出}*
```
6.4 IF 标注格式
固定格式:
```text
*{IF=X,Qn}*
```
示例:
```markdown
Smith J et al., **Neuron** (2020), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=15.0,Q1}*
```
注意:
• IF 标注内部不写 JCR 年份。
• 不写“2024 JCR IF”。
• 不写“JCR 2024”。
• 年份只保留在文献发表年份处。
• 如果 IF 为 0.0、空值、来源不稳、匹配不稳,不展示数字。
6.5 IF 核查失败时的标准处理
不要猜。
不要用期刊名印象补数字。
不要用大模型记忆补 IF。
失败时只允许三种状态:
```text
*{IF=待核验}*
```
用于:
• 搜索结果模糊。
• 有多个相似期刊。
• 只找到缩写但无法确认全称。
• 公开来源返回的 IF 可疑。
```text
*{IF=未检出}*
```
用于:
• 公开接口没有结果。
• 期刊不在 SCI / JCR 覆盖范围。
• 新刊暂无 IF。
```text
*{IF=不可公开核验}*
```
用于:
• 用户要求必须官方 JCR,但当前 Agent 没有 Clarivate/JCR 权限。
7. 最终回复自检清单
发出前必须检查:
• 是否先回答用户核心问题。
• 是否区分直接证据、间接证据、未见直接证据。
• 是否所有正文引用都可点击。
• 是否文末有完整文献信息列表。
• 是否每篇文献都带 IF 标注或待核验/未检出标注。
• PMID/DOI/URL 是否可点击。
• 是否避免把整体组织结果偷换成特定细胞类型结论。
• 是否避免把活化/磷酸化偷换成总表达量升高。
• 是否标注预印本。
• 是否说明检索边界。
• IF 是否没有凭记忆猜测。
8. 可复现伪代码
```python
queries = build_queries(user_question)
all_pmids = []
for query in queries:
pmids = ncbi_esearch(query, retmax=20, sort='relevance')
all_pmids.extend(pmids)
pmids = deduplicate_keep_order(all_pmids)
metadata = ncbi_esummary(pmids)
abstracts = ncbi_efetch_abstract(pmids)
records = merge_metadata_and_abstracts(metadata, abstracts)
records = tag_evidence(records, user_question)
records = rank_records(records)
selected = select_top_records(records)
if need_fulltext:
for record in selected_key_records:
pmcid = idconv_pmid_to_pmcid(record.pmid)
if pmcid:
record.fulltext = fetch_bioc_or_pmc_xml(pmcid)
for record in selected:
journal_query = record.full_journal_name or record.journal_abbrev
if_result = lookup_if_public_iikx(journal_query)
if if_result.confident:
record.if_annotation = f'*{IF={if_result.if_value},{if_result.quartile}}*'
elif if_result.ambiguous:
record.if_annotation = '*{IF=待核验}*'
else:
record.if_annotation = '*{IF=未检出}*'
answer = compose_answer(
conclusion,
evidence_groups,
clickable_body_citations,
full_reference_list_with_if
)
```
9. 推荐最终交付模板
```markdown
结论:
……
证据等级:
直接证据:
- ……[[1. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
间接证据:
- ……[[2. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
未见直接证据:
- ……
机制归纳:
1. ……
2. ……
检索边界:
本轮主要检索 PubMed / PMC / BioC / bioRxiv;初筛基于 metadata + abstract,仅对关键文献进入全文复核。IF 标注基于公开可访问来源核查;无法高置信匹配时标为待核验或未检出。
完整文献信息列表:
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Q1}*
2. Wang X et al., **Journal Name** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=待核验}*
```
相关技能
查看全部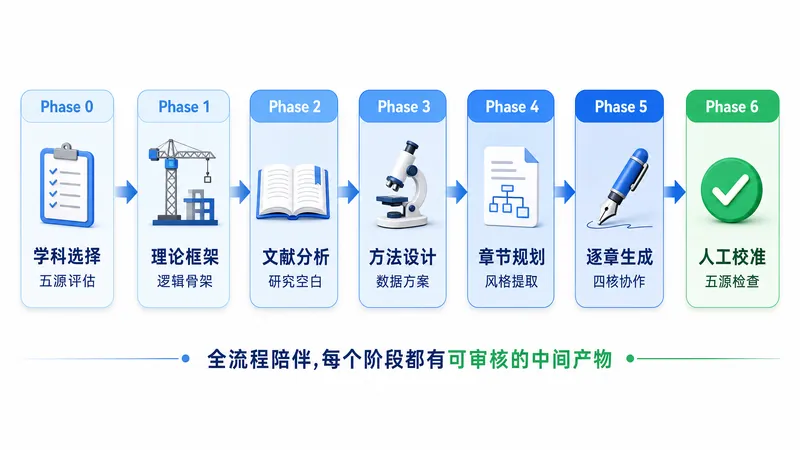
论文开题体检器·五源准备度诊断
在你投入几十小时写论文之前,先花十分钟做一次结构化体检。 【这个技能只做一件事】 诊断,不代写。它告诉你:选题能不能立住、材料够不够、缺什么、去哪补、按什么顺序补,然后交给你一份可执行的补料清单和检索式。它不会替你写引言、综述、方法或讨论。 【四个环节】 1. 学科诊断:按 1A 人文艺术 / 1B 社会科学 / 2A 理工 / 2B 农医生命四类归位,加载对应的规范红线;2B 类强制拦截伦理审查。 2. 选题体检:从「势·形·词」三维查选题,判断研究单位能否操作化、研究问题能否被回答、题目是否已被做烂。 3. 材料体检:把你手上的文献登记成 M1/M2… 材料库,逐条核验四要素(作者/年份/篇名/可核验定位符),算出真实覆盖率。 4. 缺口清单与检索式:明确还缺几篇什么类型的文献、缺哪一环证据,并给出可直接粘贴进数据库的检索式(含关键词布尔组合、时间范围、筛选标准)。 【什么时候用它】(触发词) 「帮我体检一下开题」「这个题能不能做」「我文献够不够」「开题报告被打回了」「动笔前想先确认一下」——刚定方向还没动笔的研究生;开题报告被打回来但不知道问题在哪的;手上攒了一堆文献却不确定够不够开工的;想在正式投入前先确认这个题值不值得做的。 【交付物】 一份《开题体检报告》文档 + 五源准备度评分卡(每档都有行为化判定标准,不是模糊打分)+ 补料优先级清单 + 检索式 + 一段存档码。存档码与《学术论文全流程撰写系统 v4.0》通用,体检完直接粘过去就能续写,不用重新交代学科、选题、期刊。 【明确不做】 不写正文,不生成参考文献列表,不编造作者年份卷期页码 DOI。联网检索到的文献一律标 ⚠️ 待核,必须由你自行核实后才能使用。本技能不承诺任何录用或通过结果。
 研究
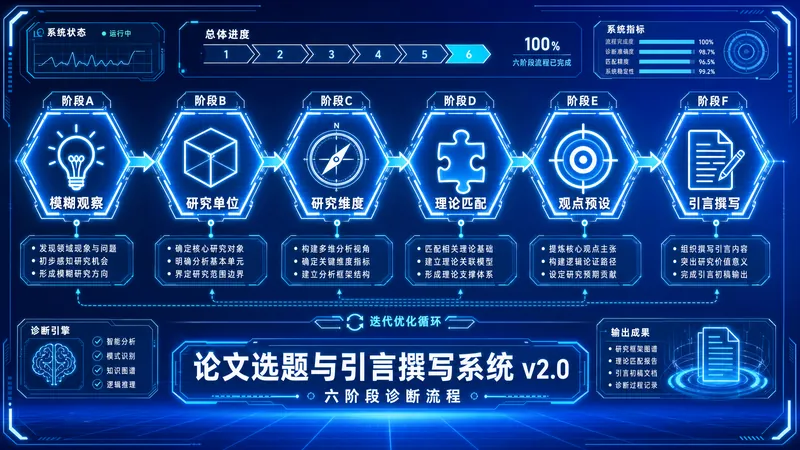
论文选题与引言撰写系统 v3.2(五源×AFP·证据链门禁)
10 秒读懂:把一句模糊观察,推成能立住的选题,再推成能过审的引言。全程只用你提供的真实材料,不编造一篇文献。触发词:论文选题、选题、引言、研究空白、学术写作、毕业论文开题、文献综述前的选题。适用:期刊论文 / 学位论文 / 会议论文 / 课程论文,人文社科与理工农医全学科。3 分钟可上手:先锁定学科与起点 → 逐层成形选题 → 证据链硬门禁 → 分模块引言 → 棘轮定稿。 【与其他技能的分工】体检在前、撰写在后、润色在最后。本技能负责中间那段:选题成形 + 引言初稿。它不做全流程正文(那是《学术论文全流程撰写系统 v4.x》),也不做语言逐句打磨(那是《学术论文三轨润色系统 v8.x》)。 【六道关口】1. 学科归位:1A 人文艺术 / 1B 社会科学 / 2A 理工 / 2B 农医生命四类归位,加载对应规范红线;2B 类伦理审查状态强制过问。2. 阶段定位:你处在模糊观察、有单位缺角度、有对象缺理论、缺方法、缺观点、还是只缺引言——从对应关口起跑,不从头重来。3. 选题成形:研究单位 → 维度罗盘 → 理论视角 → 研究方法 → 研究观点,逐层锁定,每层锁定前先判定上一层是否立住。4. 证据链硬门禁:引言前强制把你的文献登记成 M1/M2… 材料库,逐条核验作者/年份/篇名/定位符四要素;对话位不足 3 条,系统拒绝生成研究空白陈述——不是降级,是拒绝。5. 分模块生成:引言按倒金字塔五模块分块产出,每块必须标注引用编号 [Mn],无源不得成句。6. 棘轮定稿:只在已通过版本上加分,达标模块锁定不再改动,评分只升不降。 【交付物】《[选题关键词]·选题与引言》文档 + 逐句可追溯引用映射表 + ⚠️待核清单 + 一段 AFP 存档码。存档码与开题体检器、v4.x 全流程、三轨润色系统四方通用,换技能不用重新交代学科、选题、期刊、材料库。 【明确不做】不编造作者、年份、卷期、页码、DOI;联网检索题录一律标 ⚠️ 待核,须你核实后方可写入参考文献表;不承诺任何录用或过审结果。署名与责任都是你的——请务必逐条核实引用与数据。
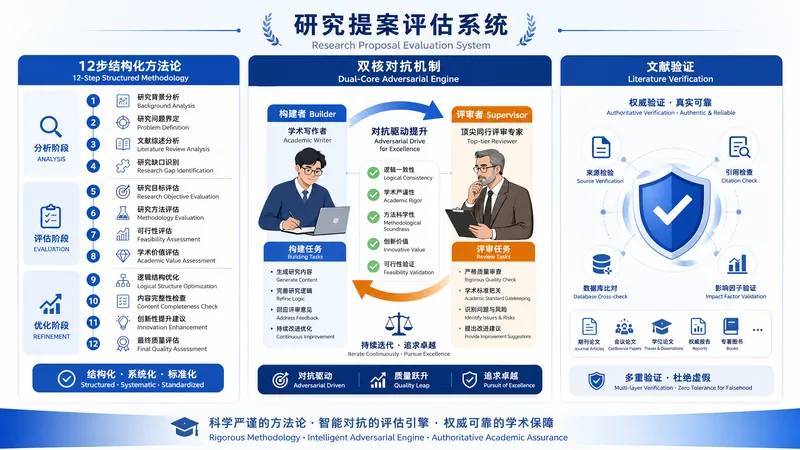
课题申报书创作、评审与润色PRO V2.0
🎯 核心功能概述 这是一个专为国家社科、教育部、省级课题申报打造的智能评审与优化系统,模拟15年资深评审专家的思维模式,通过三大核心机制确保申报书的学术严谨性和竞争力。 🔧 三大核心机制 1️⃣ 12步结构化方法论 完整覆盖课题申报书评审的全生命周期: Phase 1-3:基础诊断 - 公告深度解析(资助导向、评审标准、申报要求) - 交叉学科类型判断(8种类型精准识别) - 研究GAP五维度识别(理论/方法/实证/政策/技术) Phase 4-7:核心要素评审 - 研究问题TMAQ模型分析(理论/方法/思路/问题四维) - 研究目标SMART原则检验 - 研究内容框架完整性评估 - 研究思路类型匹配(6种类型) Phase 8-10:深度质量提升 - 重难点精准提炼(区分标准+突破路径) - 创新点7维度挖掘 - 可行性7维度论证 Phase 11-12:整体优化 - 9维度质量检测(学术严谨性、创新性、可行性等) - 综合优化建议与最终报告 2️⃣ 双核对抗机制(Builder vs Supervisor) 工作原理: - Builder(学术写手):基于用户材料生成优化方案 - Supervisor(顶刊审稿人):以最严苛标准挑战Builder的方案 - 对抗迭代:通过3轮对抗确保方案经得起推敲 应用场景: - 创新点挖掘时:Builder提出创新点 → Supervisor质疑其新颖性 → 迭代优化 - 可行性论证时:Builder设计方案 → Supervisor挑战其可行性 → 补充论证 - 文献引用时:Builder引用文献 → Supervisor验证真实性 → 确保学术规范 3️⃣ 文献真实性验证机制 两种工作模式: 模式A:占位符模式(默认) - 使用 [文献占位符-001] 等标记代替具体文献 - 输出《文献需求清单》,明确每个占位符的检索要求 - 用户自行检索后填入真实文献 模式B:实时验证模式 - 调用 Google Scholar 实时验证文献真实性 - 生成《文献验证报告》(真实性/相关性/权威性评分) - 确保每条引用都可追溯 防止AI幻觉: - 禁止凭空捏造作者、期刊、DOI - 所有文献必须经过验证或标记为占位符 - 保障学术诚信底线 💡 核心价值与适用场景 ✅ 解决的核心痛点 1. 学术不严谨:AI生成内容常出现虚假文献、逻辑漏洞 2. 创新性不足:难以挖掘真正的学术创新点 3. 可行性薄弱:研究方案缺乏系统论证 4. 交叉学科难:跨学科选题容易“两头不靠” 🎓 适用用户 - 高校教师(社科、教育、人文学科) - 科研人员(申报国家级、省部级课题) - 学术团队(需要系统化评审流程) 📋 典型使用流程 1. 输入:上传课题公告 + 申报书草稿 2. 评审:系统执行12步结构化分析 3. 对抗:双核机制迭代优化关键部分 4. 验证:文献真实性检查 5. 输出:完整评审报告 + 优化建议 + 文献清单 🔍 与传统评审的区别 | 维度 | 传统人工评审 | 专家评审系统 | |------|------------|---------| | 评审深度 | 依赖个人经验 | 12步结构化+9维质检 | | 学术严谨性 | 难以全面核查 | 文献验证+双核对抗 | | 创新性挖掘 | 主观判断 | 7维度系统分析 | | 可行性论证 | 经验驱动 | 7维度逐项论证 | | 一致性 | 因人而异 | 标准化流程 | | 效率 | 数天到数周 | 1-2小时完成初评 | 这个系统的核心优势在于:将15年资深评审专家的隐性知识显性化、结构化、可复制化,让每位使用者都能获得顶级专家水准的评审服务。
信息
- 版本
- v5
- 更新时间
- 运行积分
- 按实际用量
- 模型
- Claude Sonnet 4.5
- 使用能力
- 网络研究