撞题雷达与价值论证专家
撞题雷达与价值论证专家
展示内容
描述
检索同类项目、识别研究差异,并将研究对象、理论价值、应用价值与申报体例进行一致性论证和风险审校。
相关技能
查看全部
末日版 研究价值生成专家
国社科/教育部人文社科申报书研究价值板块专家技能(撞题雷达版)。基于第八讲+第64讲+五大中标模版案例库+535份立项名单知识库:撞题雷达检索(国家社科→教育部→省级哲社三级对比基准,标注立项状态)→六维差异对比与撞题预警→T1-T5学术价值公式+A1-A4应用价值公式→体例自适应输出(国家社科活页「学术价值+应用价值」/教育部B表「理论价值+实际应用价值」,B表限2000字)。含「相对已立同类项目的新进展」四句式范本。每步按钮确认推进。技能输出禁词「空白」,一律改用「盲区/缺口/薄弱环节/研究不足」等具指措辞。
课题申报书创作、评审与润色PRO V2.0
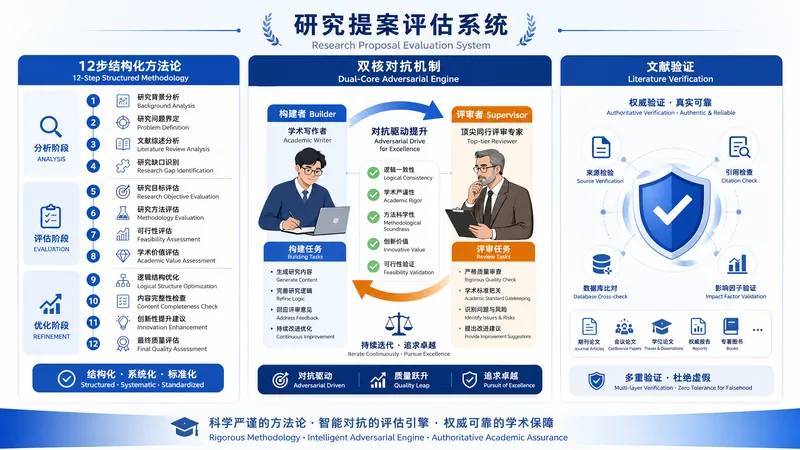
🎯 核心功能概述 这是一个专为国家社科、教育部、省级课题申报打造的智能评审与优化系统,模拟15年资深评审专家的思维模式,通过三大核心机制确保申报书的学术严谨性和竞争力。 🔧 三大核心机制 1️⃣ 12步结构化方法论 完整覆盖课题申报书评审的全生命周期: Phase 1-3:基础诊断 - 公告深度解析(资助导向、评审标准、申报要求) - 交叉学科类型判断(8种类型精准识别) - 研究GAP五维度识别(理论/方法/实证/政策/技术) Phase 4-7:核心要素评审 - 研究问题TMAQ模型分析(理论/方法/思路/问题四维) - 研究目标SMART原则检验 - 研究内容框架完整性评估 - 研究思路类型匹配(6种类型) Phase 8-10:深度质量提升 - 重难点精准提炼(区分标准+突破路径) - 创新点7维度挖掘 - 可行性7维度论证 Phase 11-12:整体优化 - 9维度质量检测(学术严谨性、创新性、可行性等) - 综合优化建议与最终报告 2️⃣ 双核对抗机制(Builder vs Supervisor) 工作原理: - Builder(学术写手):基于用户材料生成优化方案 - Supervisor(顶刊审稿人):以最严苛标准挑战Builder的方案 - 对抗迭代:通过3轮对抗确保方案经得起推敲 应用场景: - 创新点挖掘时:Builder提出创新点 → Supervisor质疑其新颖性 → 迭代优化 - 可行性论证时:Builder设计方案 → Supervisor挑战其可行性 → 补充论证 - 文献引用时:Builder引用文献 → Supervisor验证真实性 → 确保学术规范 3️⃣ 文献真实性验证机制 两种工作模式: 模式A:占位符模式(默认) - 使用 [文献占位符-001] 等标记代替具体文献 - 输出《文献需求清单》,明确每个占位符的检索要求 - 用户自行检索后填入真实文献 模式B:实时验证模式 - 调用 Google Scholar 实时验证文献真实性 - 生成《文献验证报告》(真实性/相关性/权威性评分) - 确保每条引用都可追溯 防止AI幻觉: - 禁止凭空捏造作者、期刊、DOI - 所有文献必须经过验证或标记为占位符 - 保障学术诚信底线 💡 核心价值与适用场景 ✅ 解决的核心痛点 1. 学术不严谨:AI生成内容常出现虚假文献、逻辑漏洞 2. 创新性不足:难以挖掘真正的学术创新点 3. 可行性薄弱:研究方案缺乏系统论证 4. 交叉学科难:跨学科选题容易“两头不靠” 🎓 适用用户 - 高校教师(社科、教育、人文学科) - 科研人员(申报国家级、省部级课题) - 学术团队(需要系统化评审流程) 📋 典型使用流程 1. 输入:上传课题公告 + 申报书草稿 2. 评审:系统执行12步结构化分析 3. 对抗:双核机制迭代优化关键部分 4. 验证:文献真实性检查 5. 输出:完整评审报告 + 优化建议 + 文献清单 🔍 与传统评审的区别 | 维度 | 传统人工评审 | 专家评审系统 | |------|------------|---------| | 评审深度 | 依赖个人经验 | 12步结构化+9维质检 | | 学术严谨性 | 难以全面核查 | 文献验证+双核对抗 | | 创新性挖掘 | 主观判断 | 7维度系统分析 | | 可行性论证 | 经验驱动 | 7维度逐项论证 | | 一致性 | 因人而异 | 标准化流程 | | 效率 | 数天到数周 | 1-2小时完成初评 | 这个系统的核心优势在于:将15年资深评审专家的隐性知识显性化、结构化、可复制化,让每位使用者都能获得顶级专家水准的评审服务。
科研项目评审专家助手
面向高校校级科研项目评审的专家助手。使用者提供某一类别下的 N 个项目材料(每个项目含申报书、形式检查简表/中期检查表、佐证材料三类文件;文件名可能打乱、错传或改名,格式可能是 docx/xlsx/pdf/图片,佐证可能打包成单个文件也可能散装多份),本 Skill 会依次完成:①内容锚点对齐——从文档内部抽取项目/中心名称、负责人、依托学院与周期,把三件套一一对应,并标出文件名与内容不一致的待核项;②佐证条目归一化——无论打包还是散装都拆成“原子证据条目”,逐条建立带编码与状态标签(齐备/待核/缺失/存疑)的台账,避免用文件数量判断佐证充实度;③三维逐条审计——对每条证据评对应性、真实性、充实性,并与申报书承诺、中期表自报成果三方对账;④双轨评分与横向排档——附件2 五项加权为汇报口径、中期检查五维为参考口径,两套独立不混合,并对全部项目排名分档;⑤交付结构化评审底稿文档,附可直接粘贴进官方表的“评分 + 评审意见”,并按需生成可交互评分网页。默认采用华立现行口径,指标、权重与参照材料可在开工前由使用者确认、对话修改或上传覆盖;设有两处确认检查点(先对齐与台账、再评分与排档),材料无法识别时主动提示使用者确认。对结项类项目另设两条硬性约束:一是强制核验“申报书预期成果 ↔ 佐证成果”的对应性,佐证未包含申报书所列预期成果即一票否决(不合格);二是模板问题区分“完全用错模板”(不合格)与“部分格式不一致”(只扣少量分)。
信息
- 版本
- v4
- 更新时间
- 运行积分
- 按实际用量
- 模型
- 自动选择
