非語言洞察分析
解讀表情、肢體語言與隱藏社交線索
非語言洞察分析
解讀表情、肢體語言與隱藏社交線索
展示內容
描述
不只停留在「開心」、「生氣」或「自信」等顯而易見的標籤。 非語言洞察分析會檢視影響他人如何感受一個人或一段互動的細微視覺訊息:臉部緊繃程度、視線方向、眼瞼、嘴部與下顎、頭部位置、肩膀、姿勢、雙手、身體朝向、彼此距離、不對稱,以及各種訊號之間的矛盾。 分析開始前,它只會詢問幾個相關的背景問題,避免脫離情境解讀影像。自然流露的瞬間、擺拍肖像、對話、工作場合或關係互動,可能各自代表截然不同的含義。 接著,這項 Skill 會將個別線索串連成一致的解讀,而不是單純逐項列出。它會尋找相互支持的訊號、彼此競爭的解釋,以及容易被忽略的細節——例如放鬆的臉部搭配緊繃的雙手、微笑卻沒有獲得身體其他部位支持,或視線方向與軀幹朝向互相衝突。 如有需要,報告也可以納入傳統相術觀點,例如土耳其/鄂圖曼 kıyafetname 與 firaset 傳統、西方相術、中國面相(Mian Xiang),或跨文化比較。歷史詮釋會與現代非語言分析清楚區分,若有研究資料,也會註明來源。 最終報告旨在深入但易於閱讀:提供清楚的解讀、細微線索、替代性解釋、重要矛盾與最值得注意的重點——不會將結果寫成學術論文,也不會簡化成膚淺的情緒標籤。
相關技能
查看全部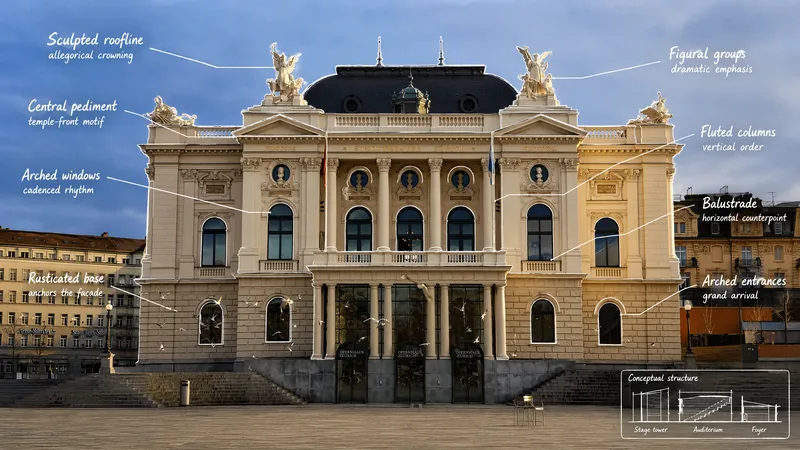 圖片
視覺場景解說員
將照片轉化為一份視覺化說明,解釋其中細節為何重要。此 Skill 會在原始影像上標示具有意義的角度、形狀、接合處、層次與元件,接著說明它們的功能、視覺意義、相關背景,以及可能受到的設計影響。適合時,還會在照片旁加入清楚標示的概念性剖面圖或爆炸圖,展示主體內部可能的結構。觀察到的事實、經查證的脈絡與視覺推論會清楚區分。
 研究
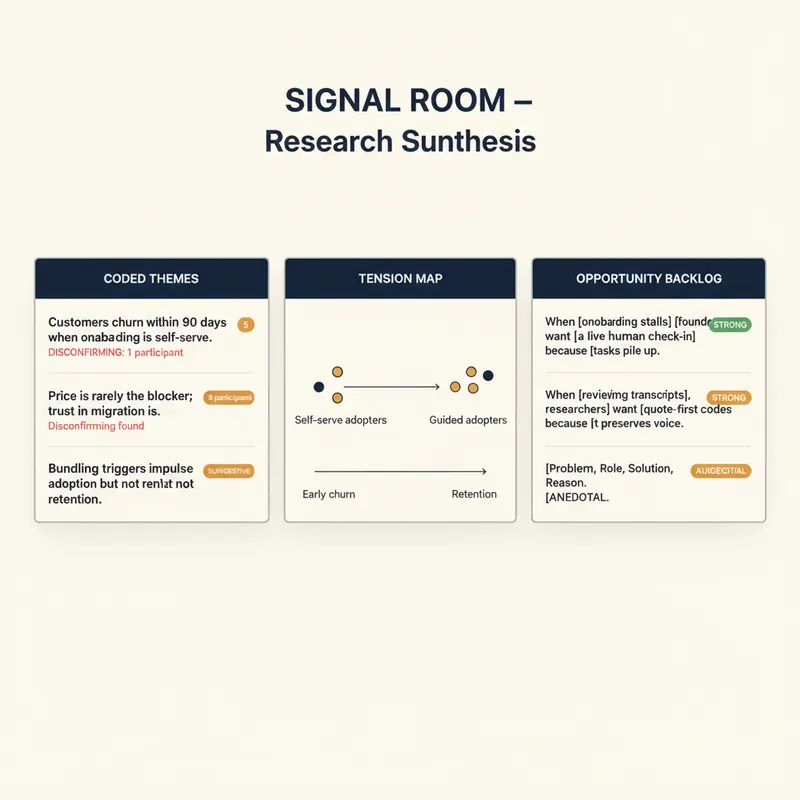
Signal Room: 訪談綜合分析
YouMind 已經為你轉錄通話、訪談和播客。Signal Room 是接下來發生的事。 丟入一份或二十份逐字稿,就能獲得真實分析師會簽名的研究綜合:編碼主題、帶時間戳的逐字證據、參與者意見分歧的地方,以及針對你要做的決策的排名答案。 這個方法是真正的質化研究實務,不是摘要: • 以引文優先的開放式編碼——沒有引文就沒有編碼——編碼名稱使用參與者自己的話語,而非分析師的行話 • 每個編碼標記為行為、信念或期望,因為「我絕對會付費購買」與「我上個月付費了」是不同的證據類別 • 主題以可否證的句子陳述,強度以參與者人數而非引文數量計算,並刻意尋找反證 • 一張張力地圖,顯示參與者真正分歧之處,以及預測他們會落在哪一方的因素 • 機會待辦清單以「當[情境]時,[誰]想要[結果],因為[原因]」的形式撰寫,每個項目評為強烈、暗示或軼事 • 直接回答你的決策問題,說明信心水準,以及什麼會改變它 • 這輪無法回答的三個問題,以及接下來該訪談誰 重要的防護措施:它絕不會捏造或潤飾引文,拒絕在少於十二位參與者時報告百分比,預設對參與者進行假名化,並且會直接告訴你,當 n=1 時,你擁有的是假設而非發現。 適合產品經理、UX 與市場研究人員、記者、顧問、正在進行客戶探索的創辦人,以及任何擁有數小時錄音卻沒有發現的人。
建立電影感人像
描述人物與場景——包括人物身分、穿著、所在位置,以及光線或氛圍——此技能會組合提示詞,生成一組具有電影感、逼真寫實的人像圖像。缺少的細節會以雅緻且協調的預設內容補足,確保每次都能產出可用的結果。適用於任何人物、文化、服裝或環境。
資訊
- 版本
- v9
- 更新時間
- 執行點數
- 依實際用量
- 模型
- 自動選擇
