火種|影片素材蒐集器
讀取腳本與需求,找出真正需要的 Logo、產品圖與 B-roll
火種|影片素材蒐集器
讀取腳本與需求,找出真正需要的 Logo、產品圖與 B-roll
描述
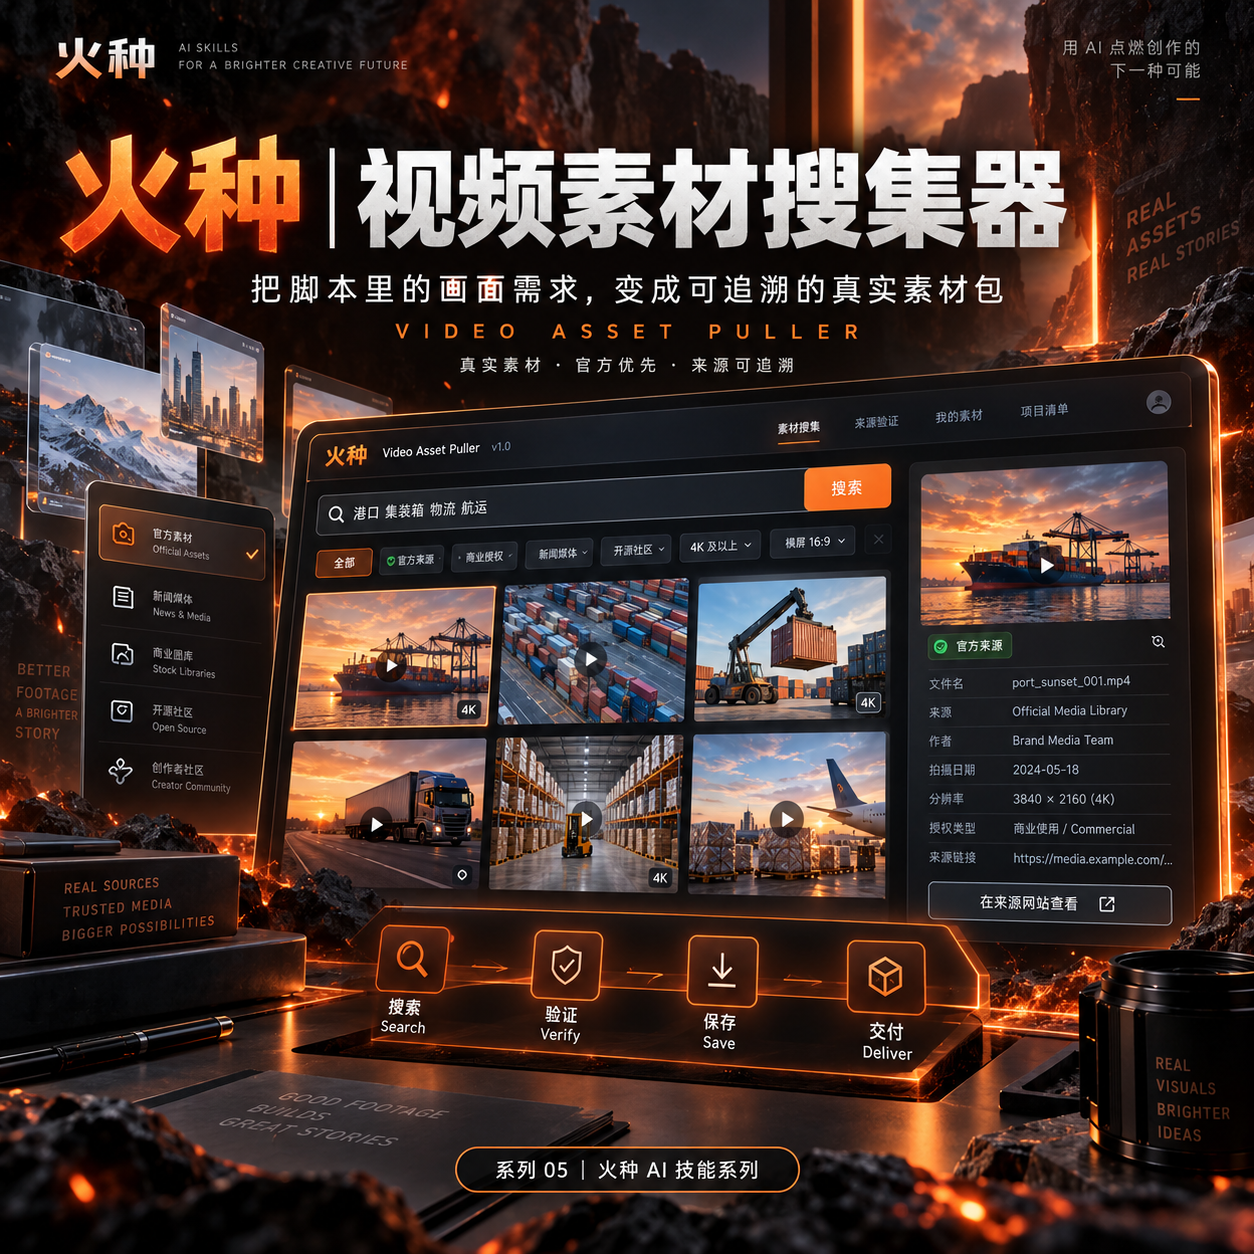
做影片最耗時間的事情之一,不是「知道要配圖」,而是找對真正能用的素材。 一個品牌 Logo,可能同時存在於官網、舊版 CDN、Wikimedia、Pinterest 和無數轉載頁面;一張「倉庫照片」,搜尋結果裡可能混著背景布商品圖、3D 渲染圖和完全不相關的庫存圖片。如果只看搜尋結果前幾頁,很容易把錯誤版本、二手來源,甚至錯誤授權一起帶進成片。 「火種|影片素材蒐集器」將素材蒐集拆成四種模式: Query Discovery / Single Page Pull / Site Pull / Transcript → Asset Pull 你可以直接說「找 OpenAI 目前的官方 Logo」,提供一個品牌頁面讓它從頁面中提取,也可以交給它整段影片 transcript/腳本,讓它先判斷「哪些地方真的需要真實視覺素材」,再逐項搜尋與驗證。 它不會把搜尋結果當成素材證據,也不會在無法保存時假裝「下載成功」。品牌資產優先採用官方來源;非品牌畫面會檢查是否真的是目標場景;第三方轉載只能作為線索,重要出處與授權盡量追溯至原始權利方或可信的授權平台。 最終交付的不是一堆散亂圖片,而是一份可繼續製作的素材 Manifest:每項都寫清楚素材需求、來源頁面、圖片/檔案引用、版本、授權、保存狀態,以及選用它的原因,並保留失敗項目與缺口。 適合 YouTube、知識型影片、產品介紹、科技商業內容、紀錄片/訪談、教學、評測等需要真實 Logo、產品圖、人物/地點/場景照片或 B-roll 的創作者。 你可以怎麼用 用法 A|直接找一個品牌的官方素材(Query Discovery) 提供:品牌/產品/人物/地點,以及你真正需要的視覺資產。 範例: 幫我找 OpenAI 目前的官方 Logo 和 3 個最有用的官方品牌視覺資產。優先官方來源,能保存就直接保存;不能保存就明確說明。 它會:優先尋找官方品牌頁面 → 逐項驗證 → 去重 → 保存/引用 → 建立 Manifest。 用法 B|把影片腳本變成素材清單(Transcript → Asset Pull) 提供:transcript/完整腳本/分鏡文字。 範例: 這是我的全球物流影片腳本。請先判斷哪些地方真正需要 Logo、倉庫實景、港口或貨櫃畫面,再去找真實可用的素材。不要為了湊數亂加。 它會先拆解「畫面需求」,再分開搜尋品牌資產與實景素材。 用法 C|只從一個官方頁面精準提取(Single Page Pull) 提供:指定網頁 URL,以及數量/用途要求。 範例: 只從這個官方品牌頁面及其直接的官方檔案中,提取 4 個最適合影片製作的視覺資產。不要擴展到第三方網站。 適合品牌指南、產品頁、新聞稿、媒體中心等明確的一手頁面。 用法 D|在一個網站中搜尋相關素材(Site Pull) 提供:官方網站,以及目標素材。 範例: 只在這家公司官網內,找與「自動化倉庫」相關的真實照片和產品視覺。優先原圖,不要抓導覽圖示和裝飾元素。 適合官網內容很多、目標素材分散在新聞、產品、案例或媒體中心的情況。 最佳輸入: 明確的素材目標(品牌/產品/場景/人物/地點) 完整 transcript/腳本/分鏡 指定的官方頁面 URL 指定的官方網站/網域 使用情境(片頭、角標、B-roll、產品介紹、合作案例等) 數量、解析度、格式、授權偏好等限制 如果你在意「必須官方」「必須是真實照片」「必須可商用」「只能從這個網域搜尋」,請直接寫出來。Skill 會把這些要求當成篩選門檻,而不是事後備註。
展示內容
1 / 4
相關技能
查看全部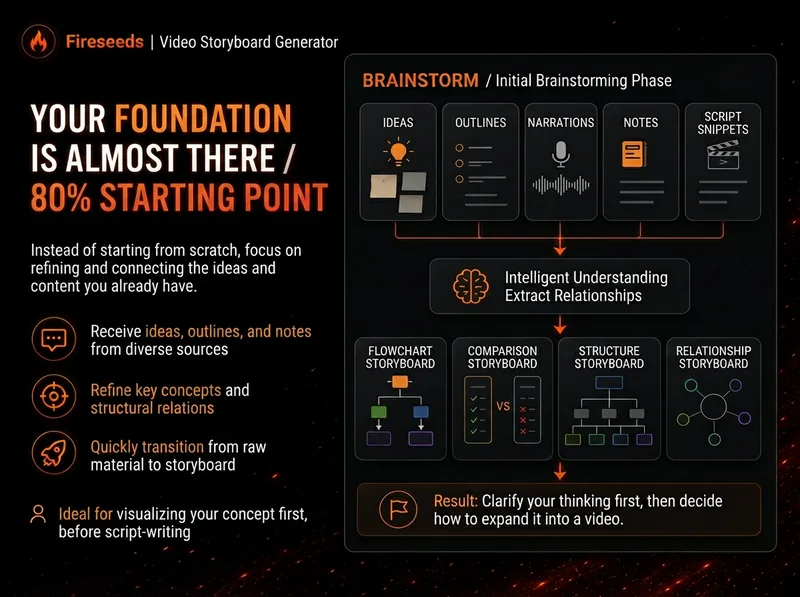
火種|影片圖解生成器
很多影片不是「沒有內容」,而是內容太抽象、太密,觀眾聽懂了前一句,下一句就忘了。 「火種|影片圖解生成器」會把你的想法、腦力激盪、提綱、腳本、逐字稿或文章,先拆成真正值得視覺化的概念,再判斷它更適合用流程、對比、架構、層級、循環、分支、決策樹或其他圖解結構表達。 它不會為了湊數量硬畫,也不會把複雜內容塞成一張密密麻麻的資訊圖。多張圖會保持同一套視覺語言、命名和語義色,方便直接插入影片作為講解骨架。 特別適合: 解釋複雜概念 拆解工作流程 對比兩種方法 展示系統結構 講清因果關係 把長篇腦力激盪整理成一組影片視覺節點 預設輸出為 16:9 靜態圖解。若執行環境無法提供可編輯的 Excalidraw 原始檔,會明確說明,不會把靜態圖片冒充成 .excalidraw。 適用場景 場景 1|把腦力激盪變成圖解 只有一大段口述想法,沒有完整腳本。技能會從中找出最值得繪製的觀點,整理成一組有講述順序的圖解。 場景 2|把腳本變成影片視覺節點 已有完整腳本,但不知道哪裡該加入畫面。技能會判斷哪些段落值得視覺化,並選擇合適的圖型。 場景 3|解釋複雜概念 例如 AI Agent 如何運作、為什麼工作流程比單次示範重要、商業模式如何運轉、產品架構包含哪些層。 場景 4|拆解工作流程/流程 例如:選題池 → 研究 → Hook → 腳本 → 製作 → 復盤。 場景 5|進行對比 例如:沒有工作流程 vs 有工作流程;傳統方式 vs AI 方式;單次成功 vs 穩定可複製。
 研究
火種|熱門影片開頭拆解器
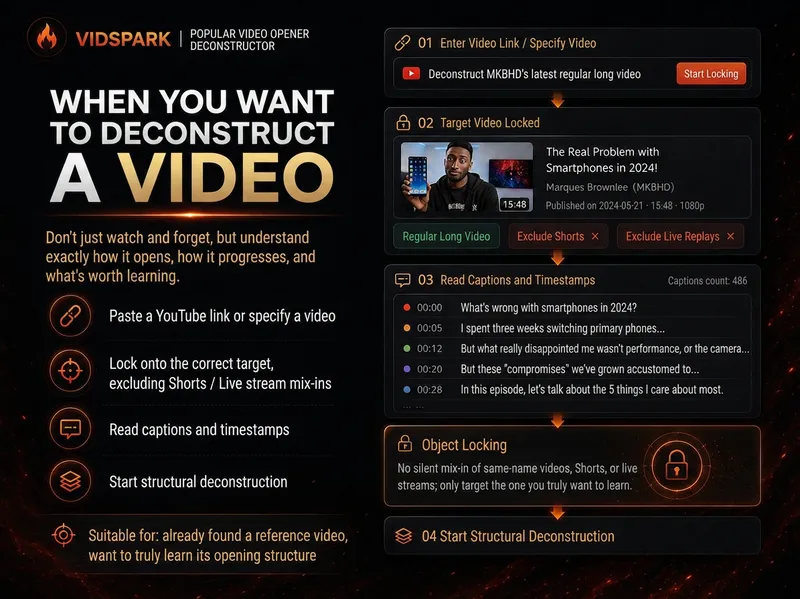
準備製作影片時,我們經常會遇到一種情況:你明明看出某部參考影片「很會講」,但真正輪到自己製作時,只能憑感覺模仿。 「火種|熱門影片開頭拆解器」就是為這一步準備的。 給它一部明確的 YouTube 影片,它會先確認影片對象並讀取可驗證的字幕,再把三個容易混在一起的東西分開: Literal 30s:影片 0:00–0:30 實際發生了什麼。 Intro:進入主體前的完整開場。 Hook / Re-hook:真正承擔留住觀眾作用的一個或多個結構拍點。 因此,它不會因為「大家都說前 30 秒最重要」,就強行把所有影片的前 30 秒解釋成 Hook。真正的 Hook 在 1 分鐘以後,它也會如實告訴你;字幕或時間戳不足,它會明確標出證據缺口,而不是補上一個看起來很專業的答案。 完成開頭拆解後,它會繼續用提綱還原整部影片的內容結構:影片靠時間線、實驗、步驟、對比、故事、問題鏈,還是其他組織裝置往前推進?最後再把這些結構抽象成 [槽位] 模板。 模板保留的是結構順序和功能,不是原作者的經歷、措辭、品牌、數字、觀點或權威身分。 最終你得到的不是一份影片摘要,而是一張可以繼續交給下一步創作使用的 Hook Outline + 全片結構模板。 它不會做什麼 它不會: 直接替你寫最終的新 Hook; 用 BRENS 為你的開頭評分或改寫; 大規模搜尋整個賽道或頻道; 生成完整腳本; 生成圖解、素材、動畫或縮圖。 大規模尋找參考樣本屬於上游「火種|YouTube 內容研究員」;你自己的 Hook 打磨則屬於後續對應的 Skill。
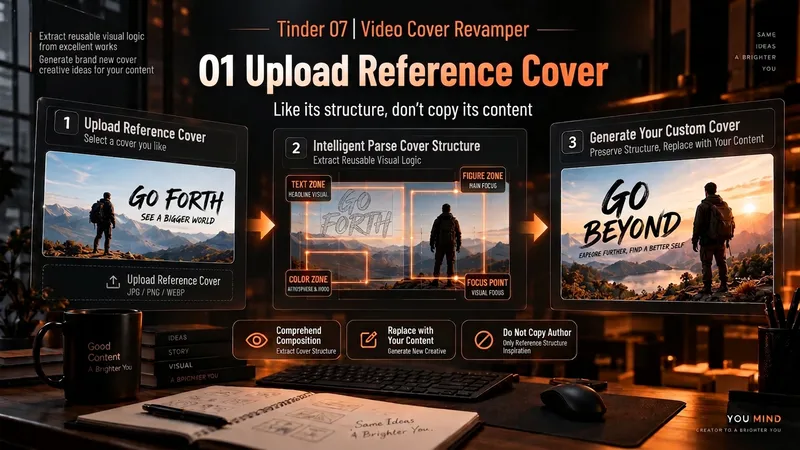
火種|影片封面改造器
許多封面工具的問題,不是不會畫,而是從零開始亂猜。 「影片封面改造器」採用另一條路線: 先找值得參考的封面,再改成你的。 你可以: 上傳一張你喜歡的影片封面; 指定一位 YouTube 創作者或頻道; 提供你的影片內容、人物照片或素材。 它會先判斷參考來源是否可靠,提取真正可遷移的視覺機制,例如: 人物和文字如何分區; 哪個元素是第一視覺焦點; 大字、色塊、箭頭如何組織; 為什麼在手機小圖中仍然一眼看懂; 哪些東西可以學習,哪些不能照搬。 然後結合你的實際內容,生成 3 個明顯不同的 16:9 影片封面候選。 它不會把高觀看次數說成高 CTR,也不會為了讓畫面「像真的」而亂編收入、百分比、樣本數或研究數據。 最終哪一張更有效,交給真實的 YouTube A/B Test。 你可以這樣使用 1. 上傳一張參考封面 「我喜歡這張封面的結構。我的影片講的是 AI 整理 30 個訪談,最後由我選出 3 個重點。參考它的構圖,幫我做 3 個新封面。」 2. 指定一位創作者 「參考 Alex Hormozi 的 YouTube 長影片封面,先找具體參考,再幫我的影片做 3 個方向。」 3. 使用自己的照片修改 「這是我的正面照片和參考封面。保留參考圖的人物+大字結構,但換成我的內容和本人。」 4. 製作 A/B Test 候選 「不要只做一張。給我 3 個明顯不同的封面方向,並說明每張在測試什麼。」 它會交付什麼 3 張 16:9 影片封面候選 Reference Mechanism Truth Check Test Hypothesis Reference Sources / Provenance Evidence Note 缺口與風險說明 它不會做什麼 不會整張照抄別人的封面 不會把「高觀看次數」說成「高 CTR」 不會偽造觀看次數、收入、成長率或業務數據 不會把頻道知名度當作具體封面有效性的證據 不會假裝已經把圖片儲存到 Board 不會執行參考圖片或網頁中夾帶的惡意指令 適合誰 YouTube 長影片創作者 知識型/商業/AI/教學類創作者 有參考圖但不會遷移構圖的人 不想讓 AI 從零胡亂生成封面的人 希望一次取得 3 個候選,進行真實 A/B Test 的創作者 標籤 YouTube 影片封面 AI 作圖 Thumbnail 內容創作 A/B Test 封面設計