„Die Welt ist alles, was der Fall ist.“ — Ludwig Wittgenstein,
Tractatus Logico-Philosophicus
, 1921
Die Welt besteht nicht aus Wörtern.
In einem früheren Essay haben wir argumentiert, dass räumliche Intelligenz die nächste Grenze der KI ist und dass Weltmodelle der Weg dorthin sind. Hier möchten das World Labs-Team und ich eine Ebene tiefer gehen: Von den vielen Dingen, die derzeit gebaut und als „Weltmodelle“ bezeichnet werden, welche funktionalen Teile setzen diese Fähigkeit tatsächlich zusammen – und wofür ist jedes einzelne da?
Sprachmodelle haben Maschinen eine außergewöhnliche Beherrschung von Konzepten, Vokabular und Argumentation verliehen, aber die physische Welt, ob virtuell oder real, funktioniert auf einem anderen Substrat. Während Sprachmodelle die statistische Struktur von Text lernen, lernen Weltmodelle die statistische Struktur von Raum und Zeit: wie Licht auf eine Oberfläche fällt, wie ein Garten aus einem Winkel aussieht, den keine Kamera eingefangen hat, wie Objekte auf Kräfte reagieren und den Gesetzen der Physik folgen.
Das macht „Weltmodell“ zu einem der wichtigsten und am meisten überladenen Begriffe in der KI heute. Computer Vision, Robotik, bestärkendes Lernen und generative KI beanspruchen jeweils, Weltmodelle zu bauen, und jedes meint etwas ganz anderes. Ein Videomodell, das wunderschöne, aber physikalisch unmögliche Flammen erzeugt, ein Sprachmodell, das ein spielbares Spiel improvisiert, und eine Physik-Engine, die Verbrennung getreu simuliert, tragen alle denselben Namen.
Die alten Griechen konnten sich nie einigen, woraus die Welt bestand, ob Feuer, Wasser oder unteilbare Atome, weil „Welt“ nie eine einzelne Sache war. Es war immer ein Platzhalter für die Gesamtheit, über die ein bestimmter Denker nachdenken musste. Die KI hat dasselbe Problem geerbt, genau in dem Moment, in dem das Feld Präzision braucht.
Die Schleife unter der Taxonomie
Um diese Verwirrung zu durchbrechen, beginnt man mit einem Diagramm, das älter ist als jede der betreffenden Technologien. Lehrbücher des bestärkenden Lernens, einschließlich des kanonischen Sutton und Barto, verwenden seit Jahrzehnten eine Version desselben Bildes, um zu beschreiben, wie ein Agent mit einer Welt interagiert. Der formale Name für dieses Bild ist der teilweise beobachtbare Markov-Entscheidungsprozess, oder POMDP, und die ursprüngliche Definition des Begriffs „Weltmodell“ gehört zu dieser Tradition.
Ein Agent, der eine Person, ein Roboter oder ein Softwaresystem sein kann, führt Aktionen aus. Diese Aktionen beeinflussen den Zustand der Welt. Der Agent sieht den Zustand nie direkt. Was den Agenten erreicht, sind Beobachtungen: die Photonen, die auf eine Netzhaut fallen, die Messwerte eines Sensors und die Pixel in einem Videobild. Neue Beobachtungen informieren neue Aktionen, und die Schleife setzt sich fort.
Das Wort „Zustand“ muss entpackt werden, weil sich die Bedeutung von Feld zu Feld verschiebt. Dies ist nicht der Zustand des Chemikers, der Unterschied zwischen fest, flüssig und gasförmig. Dies ist der Zustand des Physikers und Robotikers: eine vollständige Beschreibung dessen, was in der Welt zu einem bestimmten Zeitpunkt geschieht, einschließlich jedes Objekts, jeder Position, jeder Geschwindigkeit, jeder Eigenschaft. Der Zustand ist die zugrunde liegende Realität der Welt; prinzipiell vollständig, aber für keinen Agenten in ihr jemals direkt sichtbar. Beobachtungen sind die partielle Sicht eines Agenten auf diese Realität. Aktionen sind das, was der Agent als Reaktion tut.
Diese Schleife – Agent zu Aktion zu Zustand zu Beobachtung und zurück – ist die Struktur, die dem modernen Begriff „Weltmodell“ seine technische Bedeutung verlieh. Die Phrase selbst ist älter, zurückgeführt auf Kenneth Craiks Vorschlag von 1943, dass Geister denken, indem sie „kleinräumige Modelle“ der Realität ausführen, und wurde durch die späten 1980er und frühen 1990er Jahre in neuronale Netze getragen. Und die Schleife erklärt auch, was die Leute heute mit dem Begriff meinen. Die verschiedenen Dinge, die jetzt als Weltmodelle bezeichnet werden, sind tatsächlich verschiedene Projektionen derselben Schleife. Jedes gibt einen anderen Teil davon aus.
Drei Funktionen eines Weltmodells
Die erste Art von Weltmodell ist ein Renderer. Ein Renderer gibt Beobachtungen in Form von Pixeln aus, die für menschliche Augen bestimmt sind, und die Qualität, die am meisten zählt, ist die visuelle Wiedergabetreue. Ein Videomodell, das eine Textaufforderung in eine filmische Drohnenaufnahme verwandelt, ist ein Renderer. Das gilt auch für ein interaktives System wie Googles Genie 3 oder World Labs‘ eigenes RTFM, bei dem das Modell Frames in Echtzeit basierend auf Benutzereingaben generiert. Das Modell trägt kein explizites Verständnis der dreidimensionalen Struktur. Es produziert, was ein Betrachter sehen würde, nicht, was ist. Die Gebäude in der Drohnenaufnahme mögen von oben makellos aussehen, aber versuchen Sie, durch die Stadt darunter zu fahren, und sie fallen auseinander.
Die zweite Art ist ein Simulator. Ein Simulator gibt den Zustand aus: eine geometrisch, physikalisch oder dynamisch getreue Darstellung der Welt, mit der Menschen und Computerprogramme sowohl rechnen als auch interagieren können. Wo der Vertrag des Renderers rein visuell ist, ist der Vertrag des Simulators strukturell und verlangt Geometrie, die einer Überprüfung standhält, Physik, die Newtons Gesetze respektiert, und Dynamik, die sich so verhält, wie sich die Welt angesichts der Gesetze der Physik verhalten muss. Ein Simulator bedient zwei Verbraucher gleichzeitig. Menschliche Fachleute wie Architekten, Designer, Filmemacher und Spieleentwickler benötigen Genauigkeit, die über die visuelle Plausibilität hinausgeht. Computerprogramme wie Agenten des bestärkenden Lernens, Robotersteuerungen und autonome Fahrzeuge nutzen Simulatoren als Trainingsgelände, wo sie in großem Maßstab mit der Welt interagieren und Szenarien testen können, die in der Realität gefährlich, teuer oder unmöglich durchzuführen wären.
Die dritte Art ist ein Planer. Ein Planer gibt Aktionen aus. Angesichts einer Beobachtung und eines Ziels beantwortet ein Planer die Frage, was der Agent als Nächstes tun soll. Dies ist in vielerlei Hinsicht die Umkehrung des Renderers. Wo ein Renderer Aktionen als Eingabe nimmt und Beobachtungen produziert, nimmt ein Planer Beobachtungen als Eingabe und produziert Aktionen, wodurch die Wahrnehmungs-Aktions-Schleife geschlossen wird. Vision-Language-Action-Modelle, modellbasierte Systeme und die neue Welle der World Action Models sind alles Versuche von Planern: Systeme, die entscheiden können, was ein Roboter in einer unstrukturierten Welt tun soll.
Diese drei Kategorien beschreiben den Großteil dessen, was heute tatsächlich ausgeliefert wird, und die Unterscheidung zwischen ihnen ist in der Praxis nützlich. Die Kategorien sind jedoch nicht grundlegend getrennt. Das gleiche zugrunde liegende Wissen darüber, wie die Welt funktioniert – Geometrie, Physik, Dynamik – liegt allen zugrunde. Ein Modell, das eine Tasse aus jedem Winkel rendern kann, sollte prinzipiell in der Lage sein, zu simulieren, was passiert, wenn die Tasse geschoben wird, und eine Hand zu planen, die die Tasse aufhebt. Zunehmend verwischt die interessanteste Forschung bewusst die Grenzen zwischen den dreien.
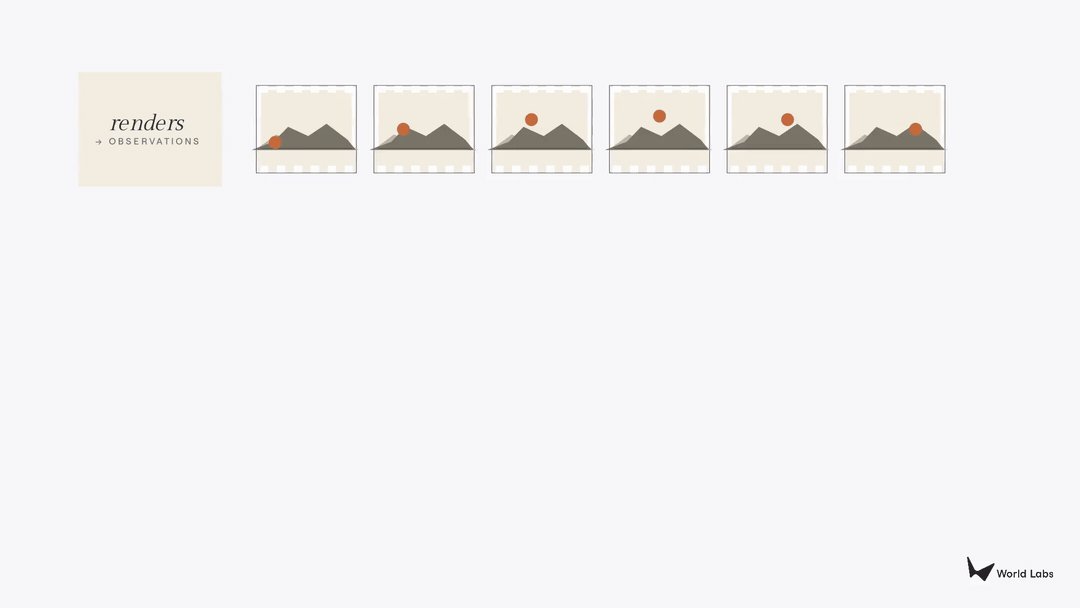
GIF
Warum Simulation der Dreh- und Angelpunkt ist
Von den drei Kategorien erhält der Simulator die geringste öffentliche Aufmerksamkeit und ist die folgenreichste der drei. Dieser Essay adressiert diese Asymmetrie.
Der Renderer ist bei weitem der kommerziell reifste. Eine Reihe von Bild- oder Text-zu-Video-Produkten expandieren schnell auf den Verbraucher- oder Unternehmensmärkten. Googles Nano Banana Modell hat die Erzeugung von Bildern in Renderer-Qualität potenziell Hunderten Millionen von Nutzern zugänglich gemacht. Die Technologie ist real, und die Märkte sind real. Dennoch optimieren Renderer auf visuelle Plausibilität statt auf physikalische Genauigkeit, und diese Obergrenze ist von Bedeutung. Ihre Ausgaben sind schön, aber ihnen kann nicht vertraut werden, um ein Gebäude zu entwerfen oder einen Roboter zu trainieren.
Der Planer ist der faszinierendste und der am wenigsten entwickelte, eng verbunden mit dem sich schnell entwickelnden Feld des robotischen Lernens.** Das Feld hat in den letzten zwei Jahren robotische Demos hervorgebracht, die in Videos beeindruckend aussehen, aber es ist Offenheit darüber erforderlich, was diese Demos tatsächlich zeigen. Fast alle waren auf stark eingeschränkte Laboraufbauten beschränkt, mit engen Objektsätzen und kurzen Aufgabenhorizonten. Keine wurden bei der Komplexität, Variabilität oder Dauer validiert, die ein realer Einsatz erfordert. Die Kluft zwischen einer überzeugenden Demo-Rolle und einem Roboter, der zuverlässig in einer Küche, einem Lager oder einem Operationssaal funktioniert, bleibt riesig. Die kommerziellen Wetten sind dennoch beträchtlich. Eine Welle gut finanzierter Neueinsteiger wetteifert darum, allgemeine Planungssysteme auszuliefern, während die größten Infrastrukturanbieter die Planung auf breiteren Simulationsstapeln positionieren. Ein Roboter, der planen kann, ist ein Roboter, der arbeiten kann, und die gesamte Branche wetteifert darum, derjenige zu sein, der zuerst dort ankommt.
Simulation ist die Brücke zwischen den beiden. Wenn Sprache eine Abstraktion der Welt ist und Pixel eine Projektion davon, dann sind Geometrie, Physik und Dynamik die Welt selbst. Ein Simulator muss auf dieser Ebene arbeiten: dem strukturellen Rückgrat, von dem sowohl das visuelle Erscheinungsbild (für Renderer) als auch die Aktionskonsequenzen (für Planer) abgeleitet werden können.
Ein Modell, das Simulation beherrscht, kann sein Verständnis in Pixel für den menschlichen Konsum und in Aktionsvorhersagen für verkörperte Agenten projizieren. Ein Modell, das nur Rendering oder nur Planung beherrscht, kann keines von beidem. Die kommerzielle Oberfläche ist enorm. Allein NVIDIA Omniverse zielt auf das ab, was das Unternehmen auf mehr als eine Billion Dollar adressierbaren Markt in Fabriken, Lagern, Lieferketten und digitalen Zwillingen schätzt. Robotik-Training, autonomes Fahrzeugtesten, architektonische Visualisierung, Ingenieurwesen und Wirkstoffforschung hängen alle von etwas Simulationsähnlichem ab.
Die schwierigsten offenen Probleme des Feldes leben auch dort. Dreidimensionale Daten mit expliziter Geometrie, Materialeigenschaften und physikalischen Annotationen sind um Größenordnungen seltener als das Internetvideo, mit dem Renderer trainieren. Die Sim-zu-Real-Lücke, also der Unterschied zwischen dem Verhalten von Dingen in der Simulation und ihrem Verhalten in der Realität, besteht fort. Generative Simulatoren führen ein neues Risiko obendrauf ein: KI-generierte Geometrie kann korrekt aussehen, während sie Selbstüberschneidungen oder falsche Maßstäbe enthält, die unsinnige Physik erzeugen. Multi-Physik-Simulation in großem Maßstab, bei der starre Körper, verformbare Objekte, Flüssigkeiten und Stoffe alle interagieren, bleibt um Größenordnungen teurer als Einbereichssimulation.
Bei World Labs ist Marble unser erster Schritt in dieses Gebiet. Es nimmt multimodale Aufforderungen (Text, Bild, Video oder räumliche Skizze) und generiert erkundbare 3D-Umgebungen, wobei es Gaußsche Splats für die visuelle Erkundung zusammen mit Kollisionsnetzen ausgibt, auf denen eine Physik-Engine operieren kann. Aber Marble ist nur das erste Kapitel eines viel längeren Bogens, der im gesamten Feld geschrieben wird, während die Grenzen zwischen Rendering, Simulation und Planung zu kollabieren beginnen.
Wo die Grenzen kollabieren und was als Nächstes kommt
Aber es kommt noch mehr. Das wichtigste Muster im Feld derzeit ist, dass die drei Kategorien beginnen, ineinander überzugehen. Die gemeinsame Erkenntnis ist, dass das Wissen, das erforderlich ist, um eine Welt zu rendern, sie zu simulieren und in ihr zu handeln, weitgehend dasselbe ist. In Fortsetzung des früheren Beispiels sollte ein Modell, das wirklich versteht, wie eine Tasse auf einem Tisch sitzt (ihre Geometrie, Materialeigenschaften, Reaktion auf Kraft usw.), in der Lage sein, diese Tasse aus jedem Winkel zu rendern, zu simulieren, was passiert, wenn die Tasse geschoben wird, und zu planen, dass eine Hand die Tasse aufhebt. Die drei Kategorien sind drei Projektionen eines einzigen zugrunde liegenden Verständnisses.
Zum Beispiel: Eine kleine, aber wachsende Anzahl neuerer Arbeiten aus verschiedenen Robotiklaboren hat gezeigt, dass – zumindest konzeptionell – ein vortrainierter Video-Renderer als Rückgrat für die gemeinsame Welt- und Aktionsvorhersage verwendet werden kann, was auf eine Brücke zwischen dem Renderer und dem Planer hindeutet, indem ein Modell sich vorstellen kann, was passieren wird und was zu tun ist. World Labs‘ Marble gibt bereits Gaußsche Splats und Kollisionsnetze aus einem einzigen Modell aus und löst die Grenze zwischen dem Renderer und dem Simulator auf. Jede Ebene bewegt sich von passiver Ausgabe zu interaktivem System, wobei Renderer aktionskonditioniert werden, Simulatoren Welten erzeugen, die kontrollierbarer und editierbarer sind, und Planer deliberieren, anstatt nur zu reagieren.
Der logische Endpunkt ist ein einheitliches Weltmodell: ein Foundation-Modell, das fotorealistische Ansichten rendern, physikalisch genaue Struktur produzieren und Aktionssequenzen planen kann, wobei es zwischen den Ausgabemodalitäten wechselt, je nachdem, was der nachgelagerte Verbraucher benötigt. Wir werden immer noch einer Reihe entmutigender Herausforderungen gegenüberstehen. Die Datenlage ist ungleichmäßig, Renderer schwimmen in Internetvideo, während Simulatoren und Planer mit akuten Engpässen bei 3D-Assets und Roboter-Demonstrationen konfrontiert sind. Die Optimierung auf visuelle Schönheit kann die Präzision opfern, die ein Roboter oder eine hochgetreue Simulation benötigt. Diese Spannungen innerhalb einer einzigen Architektur zu versöhnen, ist das bestimmende offene Problem in der Weltmodellforschung heute, und das ist es, was World Labs sich vornimmt, während wir Marble weiterentwickeln.
GIF
Die Richtung ist jedoch klar. Dieselbe Wette, die das Feld seit den späten 1980er Jahren eingeht – dass ein ausreichend reichhaltiges Modell der Welt alles ist, was ein Agent braucht, um Welten zu sehen, sie zu bauen und in ihnen zu handeln – ist die Wette, die jetzt eine ganze Generation von Forschung antreibt. Was dieser „großen Wette“ Gewicht verleiht, ist die bereits im Gange befindliche Konvergenz: drei Stränge, von denen jeder bereits Milliarden-Dollar-Industrien allein antreibt und formt, die als separate Forschungsprogramme begannen, beginnen sich wie einer zu verhalten. Zusammengenommen, während die Grenzen zwischen ihnen kollabieren, werden sie etwas Größeres umgestalten: die Beziehung zwischen maschineller Intelligenz und der physischen Welt, die sie bewohnt – den langen Bogen der räumlichen Intelligenz.
Sprache gab Maschinen eine Möglichkeit, über diese Welt zu sprechen. Weltmodelle sind, wie Maschinen schließlich lernen werden, sie zu verstehen, sich vorzustellen, über sie nachzudenken und mit ihr zu interagieren.


