Transcripción de Vídeo
Transcripción de Vídeo
Vista previa
Descripción
Transcribe vídeo o audio local en subtítulos SRT con marcas de tiempo y texto plano, priorizando el procesamiento local y admitiendo servicios de reconocimiento automático de voz (ASR) remotos configurados con consentimiento.
Habilidades relacionadas
Ver todo Escribir
Audio a borrador
Convierte un archivo de audio, una nota de voz, un vídeo hablado o una transcripción en un borrador editable y coherente. El texto hablado que falte se transcribe automáticamente, con continuación en segundo plano cuando es necesario, para que no tengas que volver para reanudar el proceso.
 Investigación
Audio a tareas y decisiones
Convierte un archivo de audio o una transcripción en un registro conciso y editable de decisiones, tareas, responsables, fechas, bloqueos y preguntas abiertas. El texto hablado que falte se transcribe automáticamente, con continuación en segundo plano cuando es necesario, antes de proponer cualquier acción opcional del Agente.
 Investigación
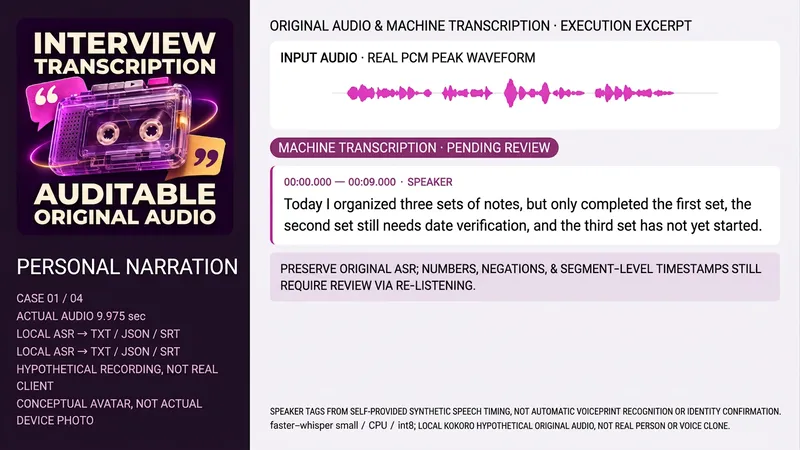
Transcripción de Entrevistas
Adecuado para quienes necesitan organizar grabaciones autorizadas de entrevistas, reuniones o clases. Proporciona el archivo original, el idioma, el propósito, la transcripción existente o un mapeo temporal de hablantes confiables; no se puede confirmar la identidad solo por la voz ni los guiones se tratarán como lo que realmente se escucha. Conserva el audio original y el hash -> lee duración y pistas -> ASR real -> organiza por cronología real -> etiqueta hablantes de forma anónima con respaldo -> revisa números, negaciones, nombres y dudas escuchando el original -> entrega TXT, JSON, SRT y notas de cobertura. Borradores, revisión y resúmenes van por separado; lo que no se entienda queda pendiente de revisión sin rellenar palabras a la fuerza. Sin herramientas de audio/ASR, se indica claramente que no se transcribió. Instrucciones y asistente local integrado: Python3, FFmpeg/FFprobe, faster-whisper y caché small configurada, CPU/int8, local_files_only, sin descarga automática de pesos. Si el speaker-map proporciona inicios, fines y etiquetas anónimas, se transcribe según el segmento y se mapea el tiempo; sin mapeo, la marca de tiempo es desconocida. El asistente no realiza diarización automática de voz ni identificación de identidad; el paquete no incluye pesos, cuentas ni claves. Cuatro casos de prueba de oratoria personal en chino, entrevistas bilingües, explicación de clases en inglés y reuniones bilingües en chino, con un audio original de unos 40,875 segundos. El audio final utiliza la versión fija local de Kokoro-82M etiquetada con Apache-2.0 (zf_xiaobei, zm_yunjian, af_heart), sin ser personas reales ni clonación de voz; no se distribuyen modelos, voces ni audios de ejemplo con la instalación. Los cuatro casos generan TXT/JSON/SRT con ASR real; los hablantes provienen del tiempo de voz sintético proporcionado, no de diarización automática. Sigue siendo un borrador automático; la divergencia entre la "salida" del ASR y el "borrador" del guion en el segundo caso queda pendiente de escucha para confirmación, sin modificar lo dicho originalmente. Las formas de onda se basan en picos PCM reales, no son ondas decorativas. Se recomienda GPT para organizar el texto y el ASR depende de las herramientas reales; no se llama localmente a la API de transcripción de OpenAI ni se ejecutan CLI externas. El avatar independiente es un concepto visual de ImageGen, la herramienta no devuelve modelos ni se afirma que sea Image2. Las herramientas de YouMind, la caché, las descargas y la vinculación de modelos no consumen créditos de prueba; se debe confirmar según el entorno real. No se garantiza la ejecución sin dependencias de la transcripción y organización de hablantes. Los 299 créditos corresponden al precio de instalación e incluyen modelos, API o servicios de terceros, sin compras automáticas ni subidas de pistas de audio desconocidas a servicios externos. No se promete cero errores, reconocimiento perfecto de acentos, ruido o solapamientos, identificación judicial o de identidad, eficacia temporal ni resultados comerciales. Queda pendiente la revisión de audio independiente, sin publicitar transcripciones verificadas.
Información
- Versión
- v2
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático
