Transcription et temps d'origine
Garder les brouillons, temps et doutes, TXT/JSON/SRT
Transcription et temps d'origine
Garder les brouillons, temps et doutes, TXT/JSON/SRT
Aperçu
Description
Idéal pour ceux qui doivent structurer des entretiens autorisés, des réunions ou des enregistrements de cours. Fournissez le fichier source, la langue, l'usage, une transcription existante ou une correspondance temporelle fiable des locuteurs ; l'outil ne peut pas confirmer l'identité uniquement par la voix et n'assimile pas les scripts à ce qui a réellement été entendu. Conservation du son original et du hachage → lecture de la durée/piste → ASR réel → organisation selon le minutage réel → étiquetage anonyme des locuteurs avec repères si disponibles → vérification des chiffres, négations, noms et points douteux par écoute du son original → livraison en TXT, JSON, SRT et notes de couverture. Premier jet machine, révision d'écoute et résumé séparés ; le contenu ambigu reste à vérifier, aucun mot n'est ajouté par fluidité. En l'absence d'outils audio/ASR, la non-transcription est explicitement indiquée. Les instructions et le package incluent un assistant local d'origine complet : Python3, FFmpeg/FFprobe, faster-whisper et le cache small préconfiguré, CPU/int8, local_files_only, pas de téléchargement automatique de poids. Une correspondance de locuteur fiable fournit début/fin et étiquettes anonymes pour la transcription et le minutage par fenêtre ; sans correspondance, les repères sont marqués comme inconnus. L'assistant n'effectue pas de diarisation automatique ni d'identification d'identité, et le package n'inclut ni poids, ni compte, ni clé. Quatre exemples de test incluent un monologue personnel en chinois, un entretien en duo en chinois, une présentation de cours en anglais et une réunion en duo en chinois, pour un total d'environ 40,875 secondes d'audio original. L'audio final utilise une synthèse locale en version fixe de Kokoro-82M étiquetée selon la carte de modèle Apache-2.0, avec zf_xiaobei, zm_yunjian et af_heart (aucun humain ni clonage vocal) ; le modèle, les voix ou les audios d'exemple ne sont pas distribués avec le package d'installation. Les quatre exemples réels d'ASR génèrent des fichiers TXT/JSON/SRT, les locuteurs provenant des minutages de prise de parole synthétiques fournis et non d'une diarisation automatique. Il s'agit toujours d'un premier jet machine ; la divergence entre la "sortie" ASR et le "brouillon" du script dans le deuxième exemple reste à confirmer par écoute, sans modification arbitraire pour correspondre au texte initial. Les formes d'onde proviennent des pics PCM d'entrée réels, et non d'ondes décoratives. GPT est recommandé pour la mise en forme du texte, l'ASR s'appuyant sur l'outil réel ; aucune API de transcription OpenAI n'a été appelée localement ni de CLI amont exécuté. L'avatar indépendant est un visuel conceptuel généré par ImageGen, l'outil n'a renvoyé aucun modèle et ne revendique pas Image2. Les outils, le cache, le téléchargement de fichiers et la liaison de modèle côté YouMind n'ont pas consommé de crédits de test ; une vérification selon l'environnement réel est requise. La transcription et l'organisation des locuteurs ne garantissent pas un fonctionnement sans dépendance après installation. Les 299 crédits correspondent au tarif d'installation, hors modèles, API ou services tiers, sans achat automatique ni envoi dissimulé de pistes audio inconnues vers des services tiers. Aucune promesse de zéro faute, de reconnaissance parfaite des accents, bruits ou chevauchements multiples, d'expertise judiciaire ou d'identité, de rapidité ou de résultat commercial. La révision d'écoute indépendante reste à compléter, sans promesse de vérification exhaustive des verbatim.
Recommandé par
Dancang
Pourquoi nous recommandons cette compétence
Cette compétence est mise en avant car elle ne fait pas passer une transcription automatique pour une version finale : elle conserve les preuves d'origine, les plages temporelles et les bases de révision, distingue prudemment l'origine des locuteurs et signale clairement les passages inaudibles, chevauchants ou non vérifiés, pour livrer des fichiers TXT, JSON et SRT traçables.
Idéal pour
Idéal pour structurer des enregistrements autorisés en conservant les bases de transcription et les repères d'incertitude.
Comment utiliser ce Skill
Fournir les éléments
Fournissez l'audio ou la vidéo d'entretiens, de réunions, de cours ou de récits dont vous avez les droits, ainsi que la langue, l'usage, le périmètre et une cartographie des locuteurs si disponible.
Lancer le Skill
Transcrit l'audio et structure les horodatages réels, applique les étiquettes de locuteurs anonymes selon la cartographie, conserve le premier jet brut et signale les passages ambigus.
Vérifier le résultat
Obtenez des fichiers de transcription TXT, JSON et SRT horodatés avec notes de source, rapport de périmètre, éléments non vérifiés et explications des révisions.
Compétences associées
Tout voir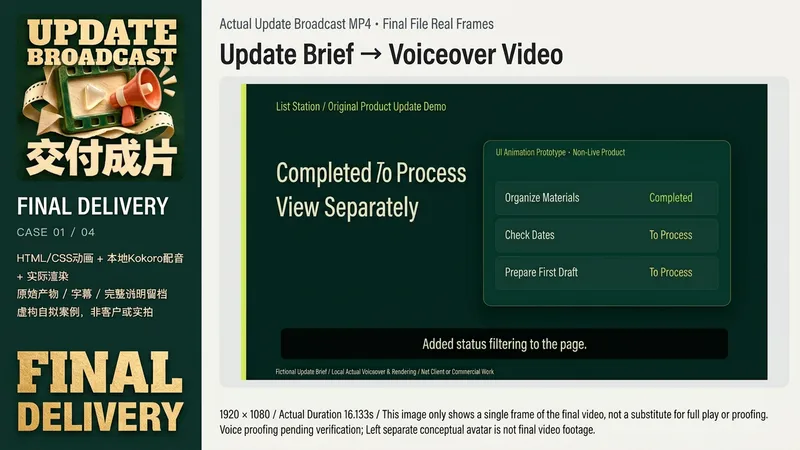 Vidéo
Mises à jour de produits
Convient aux créateurs, aux petites équipes et aux formateurs qui ont besoin d'expliquer les évolutions de leurs produits. Fournissez une liste de mises à jour réelles, des statuts terminés ou prévus, des captures d'écran ou prototypes autorisés, un public cible, un format d'image et une voix originale ; les dates, effets et données clients manquants ne seront pas inventés. En l'absence d'idée précise, une démonstration de produit fictive clairement signalée peut être réalisée. Saisie du briefing → Vérification des faits et des autorisations → Script concis et plans → Synthèse vocale ou réception de la voix originale → Synchronisation des sous-titres et visuels selon l'audio réel → Rendu réel → Contrôle visuel et audio → Livraison du MP4, du fichier SRT, du script et du projet source généré. Les interfaces réelles sont simplement mises en page à partir des originaux, sans régénération par IA. En l'absence d'outil de rendu, l'absence de film finalisé est explicitement signalée. Quatre exemples locaux servent de produits fictifs originaux : filtrage de listes, aperçu du calendrier, vérification avant exportation, progression des cours. Synthèse locale fixe avec Kokoro-82M et la voix zf_xiaobei, sortie réelle de deux vidéos 1920×1080, une en 1080×1080 et une en 1080×1920 via HyperFrames 0.8.174 et Chrome/FFmpeg, d'une durée d'environ 16,1 à 18,5 secondes ; les sous-titres sont disposés selon la durée réelle des échantillons audio par phrase, sans alignement forcé mot à mot. Il ne s'agit ni de logiciels, ni de clients, ni de résultats d'apprentissage réels en ligne. GPT est recommandé pour la planification textuelle. Nécessite des fichiers réels, un rendu d'animation/vidéo, FFmpeg/FFprobe ainsi qu'une voix originale ou un TTS légal et disponible. L'instruction inclut un assistant de rendu local d'origine complet, qui vérifie et rend uniquement les projets HyperFrames existants, sans générer automatiquement d'interface ou de voix ; vous devez configurer vous-même les chemins d'accès réels pour Node, la CLI HyperFrames et le navigateur. Les outils d'image servent uniquement d'aide optionnelle ; les avatars indépendants sont générés par ImageGen (modèle non renvoyé, il ne s'agit pas de trames d'exemple). Le modèle GPT-6.1 Sol de la plateforme est un simple paramètre optionnel qui ne garantit pas la compatibilité avec les outils ou modèles locaux. Les tests sans frais sur YouMind ne garantissent pas l'accès direct à ces outils après l'installation. Le tarif de 299 crédits correspond uniquement au prix d'installation et n'inclut ni les modèles, ni les TTS, ni les polices, ni les ressources, ni les services tiers ou l'hébergement. Ne clone pas automatiquement les voix, n'achète pas de services et ne publie pas sur d'autres canaux ; aucune garantie de saisie universelle, d'absence d'erreurs, de diffusion, de modération ou de succès commercial. Les exemples locaux actuels ont fait l'objet d'un rendu et d'une lecture réels, mais la vérification audio indépendante reste à compléter ; cela ne constitue pas une recette de qualité globale.
 Écrire
Notes en Article et Vérification
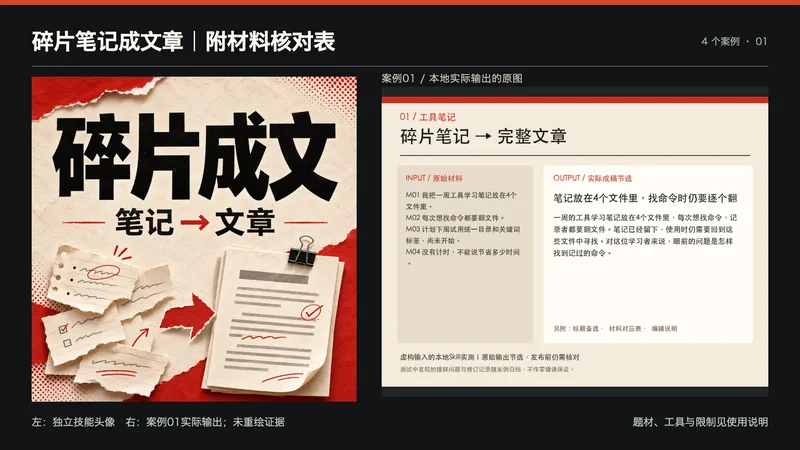
Public cible : créateurs disposant de notes éparses, de textes d'interviews ou de retranscriptions orales, souhaitant les structurer en un article. Vous devez fournir : les documents originaux, le public cible, l'usage, la longueur et les expressions à conserver. Fonctionnement : numérotation des documents, distinction entre faits, opinions et projets ; rédaction autour d'un fil conducteur, puis vérification des chiffres, des locuteurs et des manques de preuves. Livrable final : 3 propositions de titres, corps de texte complet en chinois, tableau de correspondance des matériaux, éléments à confirmer et notes d'édition. Par défaut, le texte copiable est affiché directement ; l'enregistrement des fichiers dépend de l'environnement d'exécution. Étapes d'utilisation : collez vos documents en précisant le public et le nombre de mots ; lisez l'article après exécution, vérifiez les sources avec le tableau de correspondance, puis utilisez-le après révision. Les fonctions principales nécessitent uniquement un modèle textuel (GPT recommandé) ; sur YouMind, GPT-6.1 Sol a été testé, le résultat réel dépend de la configuration d'exécution. Les quatre images de présentation sont des extraits de tests réels de Skill locale à partir d'entrées fictives, mises en page, et ne constituent pas de vrais cas clients. Les problèmes de formulation détectés lors des tests ont été archivés, et l'article nécessite toujours une relecture humaine. Un test textuel a été réalisé sur la plateforme, ce qui ne garantit pas un succès stable dans tous les scénarios. Non adapté : générer de fausses interviews de toutes pièces, inventer des expériences personnelles non fournies, remplacer la vérification des faits ou publier automatiquement. Un matériel insuffisant raccourcira le contenu tout en listant les lacunes, sans inventer de faits pour l'étoffer. Notes de présentation : la première image montre l'avatar du Skill et une mise en page côte à côte de la sortie réelle du cas 01 pour un affichage miniature horizontal ; il ne s'agit pas d'un nouveau cas, et aucun modèle de génération d'images n'a redessiné les preuves. Les trois autres correspondent aux cas 02 à 04.
 Page web
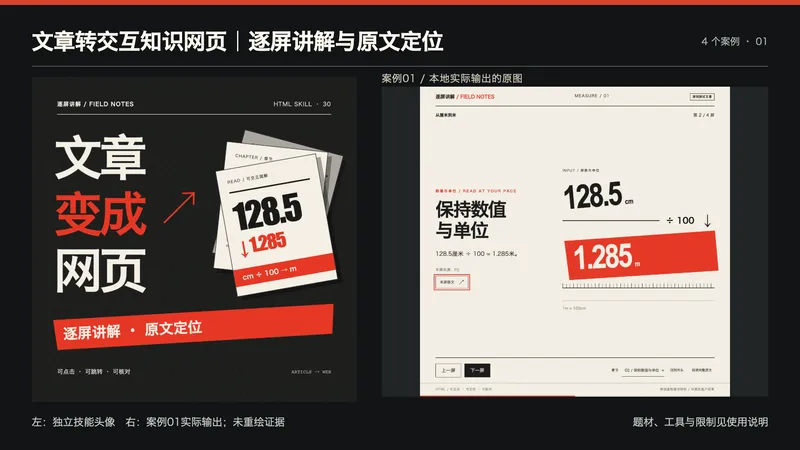
文章转交互知识网页|逐屏讲解与原文定位
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
Informations
- Version
- v2
- Dernière mise à jour
- Crédits par exécution
- Selon l’utilisation
- Modèles
- Automatique
- Cas d’usage
- Rédaction et contenu
- Ce que vous obtenez
- DocumentDonnées
