Optimiseur de tokens
Optimiseur de tokens
Aperçu
Description
Diagnostique la consommation de tokens de la session en cours, fournit des suggestions d'optimisation immédiatement exécutables, et aide l'utilisateur à améliorer l'efficacité des dialogues et la vitesse de réponse.
Recommandé par
nene@YouMind
Pourquoi nous recommandons cette compétence
Frustré par une IA lente et une consommation de Token excessive ? Cet assistant diagnostique et propose 3 à 5 recommandations prioritaires, du nettoyage immédiat aux habitudes durables, pour une IA efficace et économique.
Compétences associées
Tout voir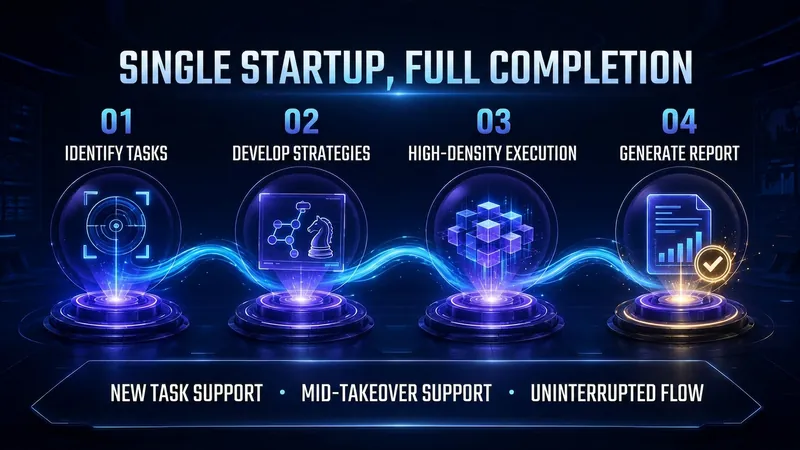
Expert en économie de tokens
Avez-vous déjà calculé combien vous payez pour les « bavardages » de l'IA ? « Bon, je vais vous aider… » « Tout d'abord, revenons sur votre question… » « Pour résumer, voici… » Vous ne lisez même pas ces phrases, mais chaque mot vous coûte des tokens. 💸 J'ai créé un Skill appelé « Expert en économie de tokens » qui résout ce problème : ✅ Identifie automatiquement le type de tâche et applique une stratégie d'économie de tokens ✅ Supprime le superflu sans sacrifier la profondeur, qualité inchangée ✅ Génère automatiquement un rapport : économies de 40 %+, clair et net Pour les utilisateurs réguliers d'IA, installez-le et récupérez le prix de quelques thés au lait. Un fait que la plupart ignorent : une partie importante de ce que vous payez pour l'IA ne sert pas à obtenir des réponses, mais à payer le langage de processus — salutations, reformulations, transitions, résumés. Ces éléments n'ont aucune valeur, mais chaque token compte. J'ai encapsulé toute une méthodologie d'optimisation de la densité d'information dans un Skill : l'Expert en économie de tokens. Son fonctionnement est simple : il identifie le type de tâche, applique une stratégie d'économie de tokens, exécute avec une densité d'information maximale, supprime toute redondance tout en maintenant une qualité irréprochable grâce à des contraintes strictes, puis génère un rapport détaillé des consommations, des économies par rapport au mode standard et des pistes d'optimisation futures. Il prend en charge le lancement initial et la reprise en cours de route, sans aucune configuration. Si vous êtes un utilisateur intensif d'IA — rédacteur, chercheur, créateur de contenu en volume, utilisateur d'API payant à l'usage — ce Skill est une machine à économiser : installez-le une fois, et chaque conversation réduit vos coûts. Disponible sur le marketplace YouMind, recherchez « Expert en économie de tokens » pour l'installer.
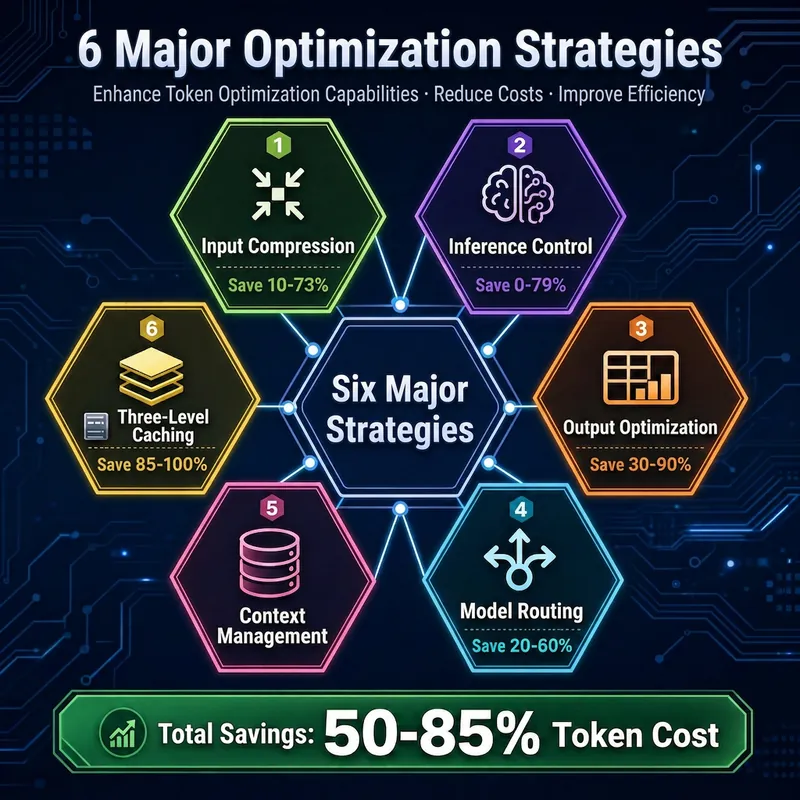
Token Optimiseur Intelligent
Détection intelligente · Optimisation silencieuse · Couverture complète YouMind. Détecte automatiquement les opportunités d'optimisation, applique les stratégies en silence, prend en charge les trois types d'entités : Board, Chaos et Elfe. Basé sur les coûts réels des modèles YouMind, il route intelligemment vers le modèle optimal, réalisant des économies de coûts de Token de 50 à 85 %. Après installation, intégration via Board Memory pour un effet d'optimisation quasi automatique ; premier lancement avec configuration guidée automatique.
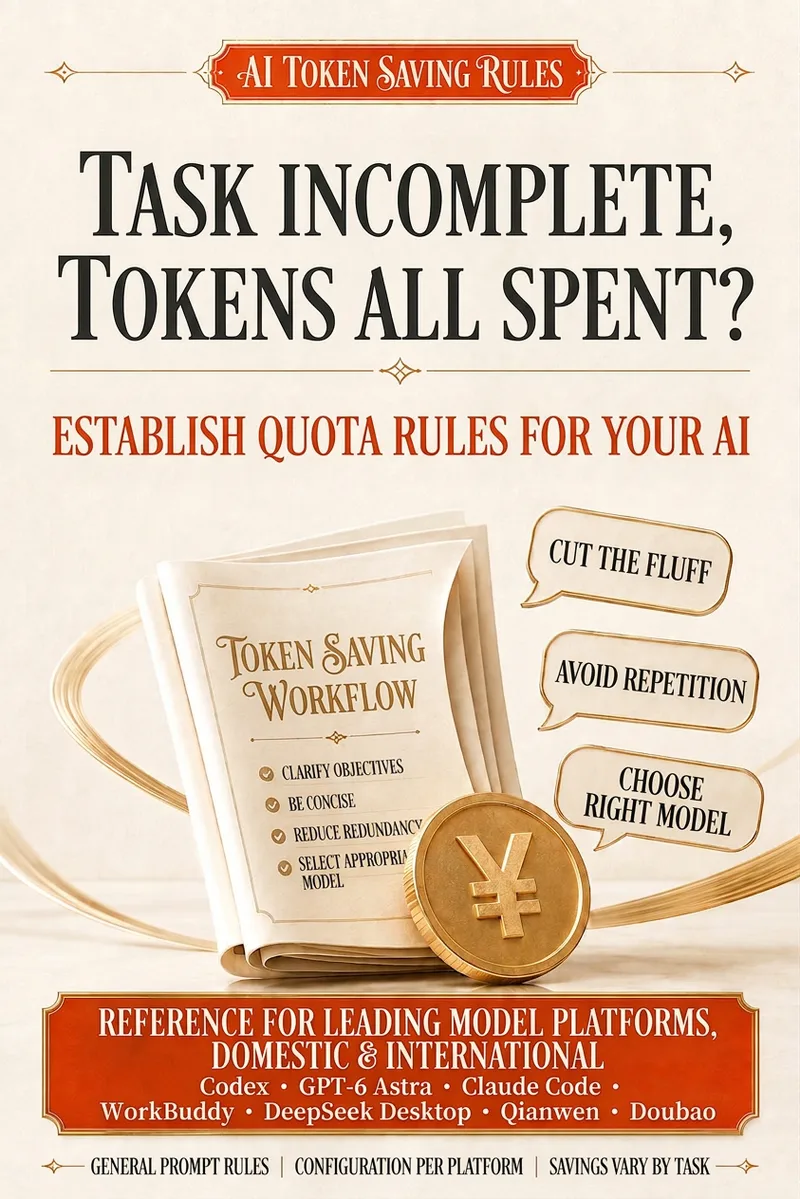
Assistant de modèles économe
Selon la difficulté de la tâche, le type de contenu et l’étape du projet, il vous aide à choisir le modèle d’IA le plus adapté, avec une stratégie de gestion des quotas pour réduire la consommation de tokens. Vous pouvez ainsi réaliser vos tâches de programmation, de création, de planification, de conception et d’analyse de l’information tout en maîtrisant vos quotas. Qu’il s’agisse de composants d’interface, d’intégration d’API, de corrections simples de bugs, de conception d’architecture, de logique complexe, de revue de code ou de refactorisation, il fournit des recommandations claires de modèles et donne directement le résultat attendu. Il convient également aux textes du quotidien, aux titres et accroches, aux contenus narratifs, aux stratégies de marque, aux plans marketing, aux structures de présentations PPT, aux idées visuelles, aux tendances du marché, aux analyses concurrentielles et à l’interprétation de données. Les tâches simples, répétitives ou mises en forme privilégient une approche plus économe en quotas. Pour les décisions importantes, les raisonnements complexes ou la version finale, il vous rappelle d’utiliser un modèle mieux adapté à vos exigences de qualité. Au fil de son utilisation, il ajuste ses recommandations en tenant compte de vos préférences de modèles, de vos habitudes de production, de la stack technique du projet, des décisions clés, des tâches à accomplir et des problèmes connus, afin de réduire les échanges répétitifs. Pour les tâches de programmation, il se concentre par défaut sur les changements essentiels et en résume les modifications. Pour les textes et les propositions, il commence par structurer l’ensemble avant d’approfondir selon vos besoins, afin que chaque conversation corresponde mieux à votre projet et à votre rythme de travail.
Informations
- Version
- v1
- Dernière mise à jour
- Crédits par exécution
- Selon l’utilisation
- Modèles
- Automatique
