हमने बड़े पैमाने पर बेहद तेज़ टोकन डिलीवर करने के लिए GPUs के साथ Cerebras Wafer Scale Engines को तैनात किया है
दुनिया को अल्ट्राफास्ट (बेहद तेज़) टोकन की भूख लगी हुई है। 2026 में, Cerebras ने अपने inference cloud और अपने पार्टनर्स दोनों के ज़रिए फास्ट inference की असीम माँग देखी। इस माँग को पूरा करने के लिए, हमने disaggregated inference विकसित करना शुरू किया: GPUs प्रॉम्प्ट प्रोसेसिंग (prefill) संभालते हैं और Cerebras सिस्टम आउटपुट जनरेशन (decode) संभालते हैं।
यह समाधान अब प्रोडक्शन में है और उन्हीं अल्ट्राफास्ट Cerebras स्पीड्स पर प्रति मेगावॉट पाँच गुना ज़्यादा टोकन डिलीवर करता है।
अब हम बाज़ार की माँग को पूरा करने के लिए Cerebras Inference Cloud के ज़रिए ज़्यादा अल्ट्राफास्ट टोकन सर्व कर सकते हैं। इन्फ्रास्ट्रक्चर पार्टनर्स भी अपने खुद के डेटासेंटर्स में ज़्यादा अल्ट्राफास्ट टोकन हासिल करने के लिए Cerebras disaggregated समाधान का फायदा उठा सकते हैं।
हाल ही में घोषित किए गए हमारे CS-4, हमारी तेज़ी से बढ़ी हुई मैन्युफैक्चरिंग क्षमता और 700MW की नियोजित डेटा सेंटर कैपेसिटी के साथ, disaggregated inference Cerebras और उसके पार्टनर्स को 2027 और उसके बाद कई गुना ज़्यादा अल्ट्राफास्ट टोकन सर्व करने में मदद करेगा। इस ब्लॉग में हम इन विषयों पर बात करेंगे:
- ज़्यादा अल्ट्राफास्ट inference कैपेसिटी की ज़रूरत
- decode के लिए Cerebras क्यों बेहतर है
- Cerebras disaggregated inference के प्रोडक्शन नतीजे
- इन्फ्रास्ट्रक्चर पार्टनर्स के लिए Cerebras disaggregated inference
ज़्यादा फास्ट inference कैपेसिटी की ज़रूरत
Muse, Copilot और Codex जैसी एजेंटिक ऐप्स तेज़ी से बढ़ रही हैं और यूज़र्स को जोड़े रखने के लिए उन्हें हाईली इंटरैक्टिव inference की ज़रूरत होती है। बिजली की सीमित उपलब्धता वाले माहौल में इन ऐप्स की बढ़ती माँग को पूरा करने के लिए, हमारी इंडस्ट्री को प्रति मेगावॉट काफी ज़्यादा inference कैपेसिटी देनी होगी, और वो भी ऐसी रिस्पॉन्स स्पीड पर जो इन ऐप्स को असल में काम का बनाए।

स्रोत: Goldman Sachs Research, “AI Agents Forecast to Boost Tech Cash Flow as Usage Soars,” 20 मई, 2026; Investing.com द्वारा रिपोर्ट किए गए अनुसार Goldman Sachs के डेटा सेंटर कैपेसिटी अनुमान
यही वजह है कि Cerebras ने disaggregation में निवेश किया। प्रॉम्प्ट प्रोसेसिंग के लिए prefill accelerator को रिस्पॉन्स जनरेशन के लिए Cerebras System के साथ जोड़ने से प्रति मेगावॉट टोकन थ्रूपुट बढ़ जाता है, जबकि Cerebras की अल्ट्राफास्ट जनरेशन स्पीड बरकरार रहती है। inference प्रोवाइडर्स के लिए, इसका मतलब है कि उसी पावर बजट में कस्टमर्स को सर्व करने की ज़्यादा कैपेसिटी और रेवेन्यू की अधिक संभावना।
Decode के लिए Cerebras क्यों बेहतर है
किसी inference रिक्वेस्ट के दो मुख्य चरण होते हैं। प्रॉम्प्ट प्रोसेसिंग, जिसे prefill कहते हैं, इनपुट को प्रोसेस करती है और इंटरमीडिएट मॉडल स्टेट तैयार करती है। रिस्पॉन्स जनरेशन, जिसे decode कहते हैं, उस स्टेट का इस्तेमाल करके आउटपुट टोकन बनाता है। inference वर्कलोड को बाँटने के कई तरीके हैं, जिनमें draft–target और attention–FFN शामिल हैं, लेकिन जब लक्ष्य हाईली इंटरैक्टिव inference हो, तो prefill को decode से अलग करना खास तौर पर फायदेमंद होता है।

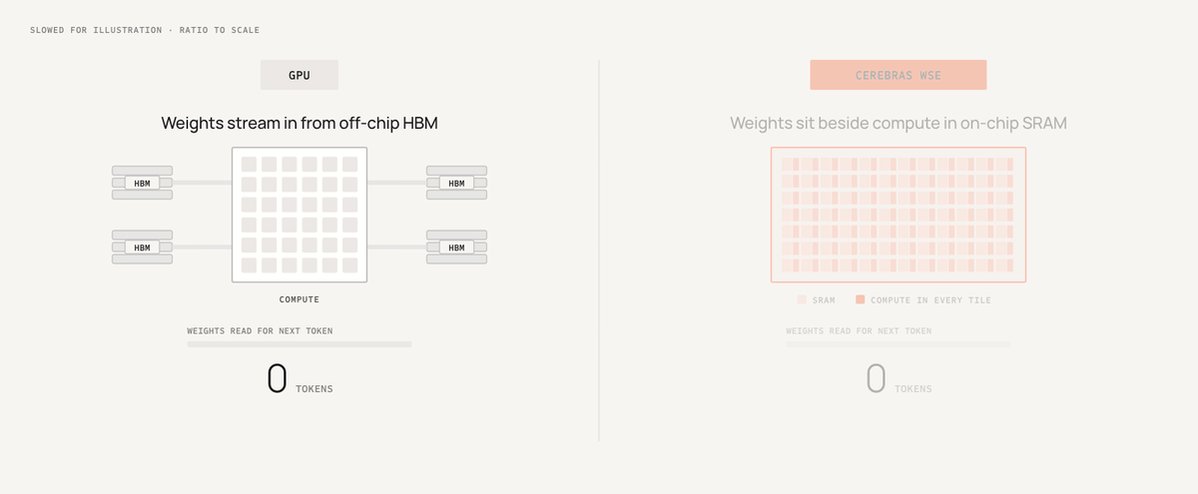
Decode ऑटोरिग्रेसिव होता है। इसका मतलब है कि मॉडल एक बार में एक टोकन बनाता है, और हर बनाए गए टोकन को अगला टोकन बनाने के लिए इनपुट के रूप में इस्तेमाल करता है। हर स्टेप का मतलब है मेमोरी से मॉडल डेटा को फिर से पढ़ना, इसलिए मेमोरी बैंडविड्थ बहुत मायने रखती है। अल्ट्राफास्ट inference के क्षेत्र में, SRAM-केंद्रित चिप्स को फायदा होता है क्योंकि वे उस डेटा को चिप पर ही रख सकते हैं और उसे बहुत तेज़ी से पढ़ सकते हैं। Cerebras इसे वेफर स्केल तक ले जाता है — एक ही चिप पर दसियों गीगाबाइट SRAM और प्रति सेकंड दसियों पेटाबाइट मेमोरी बैंडविड्थ के साथ — जो एक आम GB300 GPU की तुलना में 350× ज़्यादा SRAM कैपेसिटी और 5,400× ज़्यादा मेमोरी बैंडविड्थ है। इससे Cerebras सिस्टम ज़्यादा कंकरेंट रिक्वेस्ट्स और मॉडल लेयर्स को सीधे चिप पर फिट कर सकता है, जिससे CS-3, CS-4 और CS-5 शानदार थ्रूपुट के साथ अल्ट्राफास्ट स्पीड हासिल कर पाते हैं।
GIF
Cerebras disaggregated inference के प्रोडक्शन नतीजे
अल्ट्राफास्ट decode के लिए ऑप्टिमाइज़ किए गए Cerebras सिस्टम्स को prefill की कंप्यूट ज़रूरतों के लिहाज़ से उपयुक्त accelerators, जैसे AMD Instinct GPUs के साथ जोड़ने से बड़े पैमाने पर भारी मात्रा में अल्ट्राफास्ट inference डिलीवर करना संभव हो जाता है। Cerebras Inference Cloud पर एक प्रोडक्शन डिप्लॉयमेंट में, AMD Instinct GPUs प्रॉम्प्ट्स को प्रोसेस करते हैं और Cerebras CS-3 सिस्टम रिस्पॉन्स बनाते हैं। प्रॉम्प्ट प्रोसेसिंग को GPUs पर शिफ्ट करने से Cerebras सिस्टम अपनी सर्विंग कैपेसिटी पूरी तरह रिस्पॉन्स जनरेशन में लगा सकते हैं। हमारे मापे गए प्रोडक्शन डिप्लॉयमेंट में, इस कॉम्बिनेशन ने केवल CS-3 वाले कॉन्फ़िगरेशन की तुलना में प्रति मेगावॉट 5X थ्रूपुट दिया, और टोकन जनरेशन स्पीड में कोई कमी नहीं आई।

स्रोत: 14 नवंबर को Cerebras Inference Cloud के ज़रिए शेयर किया गया GPT-OSS-120B endpoint — disaggregated inference चालू करने से पहले और बाद का प्रति मेगावॉट थ्रूपुट, जिसे aggregated inference बेसलाइन (1×) के हिसाब से नॉर्मलाइज़ किया गया है।
हम 2027 के अंत तक Cerebras Inference Cloud और पार्टनर डिप्लॉयमेंट्स में सैकड़ों मेगावॉट में बड़े पैमाने पर disaggregated inference को तैनात करने की योजना बना रहे हैं। हमारा लक्ष्य अपने कस्टमर्स के लिए उपलब्ध अल्ट्राफास्ट inference कैपेसिटी को बढ़ाना है।
इन्फ्रास्ट्रक्चर पार्टनर्स के लिए Cerebras disaggregated inference
Cerebras disaggregated inference समाधान को हमारे पार्टनर्स के इस्तेमाल को ध्यान में रखकर भी बनाया गया है। इन्फ्रास्ट्रक्चर पार्टनर्स Cerebras द्वारा दिए गए रेफरेंस आर्किटेक्चर के आधार पर disaggregated inference क्लस्टर्स तैनात कर सकते हैं, और अपने चुने हुए prefill accelerators तथा Cerebras सिस्टम्स को एक यूनिफाइड नेटवर्क में एक साथ रख सकते हैं। सॉफ्टवेयर इंटीग्रेशन के लिए, पार्टनर्स या तो Cerebras के end-to-end disaggregated सॉफ्टवेयर स्टैक के साथ इंटीग्रेट कर सकते हैं या decode-only SDK के साथ।
- End-to-end disaggregated सॉफ्टवेयर स्टैक उन पार्टनर्स के लिए सबसे अच्छा है जो मार्केट में जल्दी पहुँचना चाहते हैं। इसमें शामिल हैं:
- एक disaggregated inference फ्रेमवर्क, जो prefill और decode पूल के बीच रिक्वेस्ट्स को रूट करता है और रेप्लिका कैपेसिटी व हेल्थ को मैनेज करता है।
- vLLM या SGLang जैसे ओपन-सोर्स inference engines का इस्तेमाल करके प्रॉम्प्ट्स को प्रोसेस करने वाला एक prefill engine।
- Cerebras सिस्टम्स पर रिस्पॉन्स जनरेशन के लिए एक Cerebras decode engine।
- KV Portal सॉफ्टवेयर, जो RDMA के ज़रिए prefill और decode engines के बीच key-value caches सहित इंटरमीडिएट मॉडल स्टेट ट्रांसफर करने का इंटरफ़ेस है।
Decode-only SDK उन पार्टनर्स के लिए सबसे अच्छा है जो ज़्यादा कंट्रोल चाहते हैं। Decode-only SDK के साथ, पार्टनर्स अपना खुद का inference framework और prefill engine लेकर Cerebras decode engine और KV Portal सॉफ्टवेयर के साथ इस्तेमाल कर सकते हैं। इसके अलावा, decode-only SDK डेवलपमेंट में मददगार चीज़ें भी देता है, जैसे एक mock Cerebras decode replica और ओपन-सोर्स disaggregated inference framework व prefill engine के साथ रेफरेंस इंटीग्रेशन।

Amazon Web Services, Fireworks AI, Gimlet Labs और General Compute सहित अर्ली-एक्सेस पार्टनर्स को उनके डिप्लॉयमेंट्स के लिए Cerebras disaggregation समाधान का एक्सेस पहले से मिल चुका है। अब हम उन अन्य पार्टनर्स को भी एक्सेस दे रहे हैं जो बड़े पैमाने पर अपने कस्टमर्स तक अल्ट्राफास्ट inference पहुँचाना चाहते हैं।
नतीजों, समाधानों या डिप्लॉयमेंट के मौकों पर विस्तार से बात करने के लिए, यहाँ हमसे संपर्क करें।


