AI स्वाद हटाने का सबसे प्रभावी Skill
52.5 लाख शब्दों और 5 लाख परीक्षणों पर आधारित
सामग्री की झलक
विवरण
यह दो दौर के वास्तविक परीक्षण कॉर्पस (कुल 1,169 लेख, लगभग 5.2 मिलियन चीनी वर्ण, 100+ मेट्रिक्स, और लगभग 500,000 मॉडल अर्थ संबंधी निर्णय) पर आधारित एक lieflat-less-ai-tone Skill है, जिसके GitHub पर 7.3K+ Star हैं। यह Skill "AI जैसी टोन क्या है" को मात्रात्मक रूप से मापने के लिए दो दौर के डेटा प्रयोगों पर आधारित है। पहले दौर में 629 लेख (2.83 मिलियन वर्ण) शामिल थे, और दूसरे दौर में 540 नए युग्मित लेख (2.56 मिलियन वर्ण) शामिल किए गए। कुल मिलाकर इसमें 1,169 लेख और 5.2 मिलियन चीनी वर्ण शामिल हैं। इस Skill ने बाज़ार में मौजूद सभी संभावित "AI टोन" को 100 से अधिक मेट्रिक्स में विभाजित किया है, और स्क्रिप्ट डिटेक्शन, बड़े मॉडल अर्थपूर्ण डिटेक्शन, और मैन्युअल ब्लाइंड रिव्यू के तीन तरीकों से इसकी जाँच की है। इसमें वाक्य-दर-वाक्य और अनुच्छेद-दर-अनुच्छेद 507,000 मशीन अर्थपूर्ण निर्णय चलाए गए, और अंत में बड़ी संख्या में मैन्युअल ब्लाइंड रीडिंग मूल्यांकन किए गए। अंत में, इसे उपयोग में आसान बनाने के लिए Skill के रूप में प्रस्तुत करने का विकल्प चुना गया, जिससे lieflat-less-ai-tone प्रोजेक्ट की शुरुआत हुई। यह Skill पहले मेट्रिक्स, शोध संदर्भ, मूल वाक्य के उदाहरणों और सुधार के तरीकों के साथ एक डिटेक्शन रिपोर्ट प्रदान करता है। उपयोगकर्ता के उत्तर देने के बाद, यह दोबारा लिखता है और फिर से परीक्षण करता है।
द्वारा अनुशंसित
Dancang
हमें यह कौशल क्यों पसंद है
यह बड़े पैमाने के对照语料 और बहु-चरणीय语义 परीक्षणों पर आधारित है। यह पहले पहचान करती है, फिर न्यूनतम रीराइटिंग करती है और तथ्यों तथा मूल संरचना को सुरक्षित रखती है।
किनके लिए उपयोगी
उन लेखकों के लिए उपयुक्त जो मूल अर्थ, तथ्यों और लेख की संरचना को बनाए रखते हुए पाठ में AI लेखन کے निशानों को कम करना चाहते हैं।
इस Skill का उपयोग कैसे करें
अपना इनपुट दें
जाँच के लिए लेख या पाठ प्रदान करें, और चाहें तो ध्यान केंद्रित करने के क्षेत्र का उल्लेख करें।
Skill चलाएँ
पहले पाठ में संदिग्ध AI लेखन के निशानों का विश्लेषण करें, उदाहरण वाक्यों और सुधार के तरीकों के साथ एक जाँच रिपोर्ट दें; पुष्टि मिलने पर, चुने गए सुझावों के अनुसार न्यूनतम दोबारा लिखें और फिर से जाँच करें।
परिणाम देखें
सुधार से पहले की जाँच रिपोर्ट, दोबारा लिखा गया पाठ, और सुधार से पहले व बाद के परिणामों की तुलना प्राप्त करें।
संबंधित कौशल
सभी देखें लिखें
चीनी AI-मुक्त लेखन पुनरावृत्ति
चीनी लेखों को किसी विशिष्ट दृश्य में किसी वास्तविक व्यक्ति द्वारा लिखे गए जैसा अधिक प्राकृतिक बनाएं, साथ ही मूल तथ्यों, रुख और टोन की तीव्रता को बनाए रखें। चाहे WeChat संदेश हो, ईमेल, Xiaohongshu, कार्य रिपोर्ट या शोध पत्र, यह पहले शैली और अभिव्यक्ति की समस्याओं की पहचान कर सकता है, और फिर लक्षित तरीके से रूढ़ियों, अस्पष्ट अभिव्यक्तियों, यांत्रिक संरचनाओं, नाममात्र के वाक्य रूपों और अनुचित टोन को साफ़ कर सकता है, जिससे पाठ अधिक विशिष्ट, स्वाभाविक और प्रवाहित हो जाता है, बिना अत्यधिक बोलचाल के। संशोधन के दौरान तथ्यों की सीमाओं का कड़ाई से पालन किया जाएगा: बिना अनुमति के कोई नई संख्या, तिथि, व्यक्ति का नाम, संस्था, मामला, वादा या प्रभाव नहीं जोड़ा जाएगा, 'संभव' को 'निश्चित' में नहीं बदला जाएगा, और न ही महत्वपूर्ण योग्यताओं और निष्कर्षों को हटाया जाएगा। जहां मूल पाठ में आवश्यक जानकारी का अभाव है, वहां जोड़े जाने वाले内容的 को स्पष्ट रूप से चिह्नित किया जाएगा, ताकि लेख को पूरा करने के लिए विवरण गढ़ने से बचा जा सके; शोध पत्रों और कार्य रिपोर्टों में औपचारिक अभिव्यक्तियों को 'AI निशान' के रूप में गलत नहीं समझा जाएगा और जबरन हल्का नहीं किया जाएगा। आपको तथ्यों की दोबारा जांच और द्वितीयक निरीक्षण से गुजरा हुआ चीनी संशोधन परिणाम मिलेगा, जो सीधे संचार, प्रकाशन, रिपोर्टिंग या अकादमिक लेखन के लिए उपयुक्त है। आवश्यकता पड़ने पर, आप विशिष्ट निशान मूल्यांकन, परिवर्तन आधार और जोड़ी जाने वाली जानकारी को भी देख सकते हैं, यह स्पष्ट रूप से समझ सकते हैं कि किन स्थानों को समायोजित किया गया है, और यह कैसे सुनिश्चित किया जाए कि संशोधन से पहले और बाद में जानकारी पूरी और सुसंगत है।
AI पाठ्य सामग्री गुणवत्ता परीक्षक
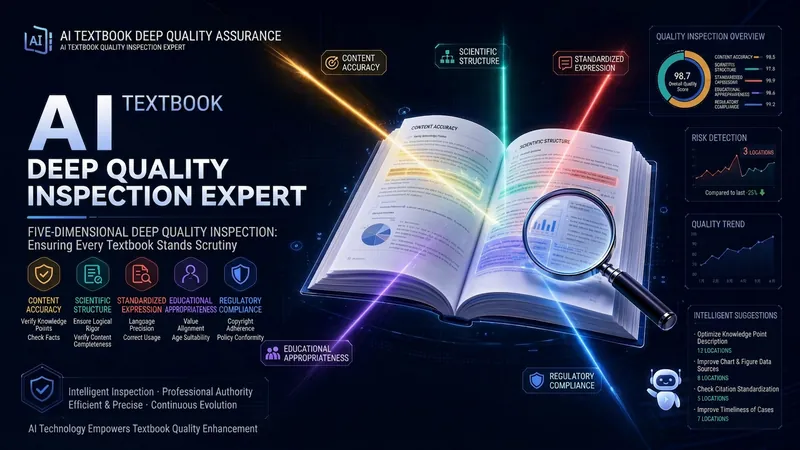
📚 AI पाठ्य सामग्री गुणवत्ता परीक्षक — पाँच आयामों में गहन जाँच, AI द्वारा लिखित पाठ्य सामग्री को समीक्षा के योग्य बनाएं AI सहायता से लिखी गई पाठ्यपुस्तकों में पाँच सामान्य दोष होते हैं: ज्ञान संबंधी त्रुटियाँ जिनकी स्वयं जाँच कठिन है, शिक्षण डिज़ाइन में कक्षा की अनुभूति का अभाव, बड़ी मात्रा में "सही लेकिन बेकार" बातें, मशीन द्वारा लिखे जाने का टेम्पलेट प्रभाव, और कठिन भाषा के कारण छात्रों द्वारा पढ़ने से बचना। यह प्रणाली प्रत्येक अध्याय का पाँच आयामों में गहन गुणवत्ता निरीक्षण करती है, विषय विशेषज्ञ, शिक्षण डिज़ाइनर, तथ्य जाँचकर्ता, और शैली विश्लेषक की भूमिका से हर अध्याय की जाँच करके मात्रात्मक स्कोर और सीधे बदले जा सकने वाले सुझाव प्रस्तुत करती है। पाँच आयाम: 📐 ज्ञान सटीकता — अवधारणाओं, मॉडलों, डेटा का स्रोत सहित सुधार, प्रत्येक त्रुटि का स्रोत चिह्नित 🎯 शिक्षण डिज़ाइन — कठिनाई स्तर, पूर्व ज्ञान की तैयारी, अध्यायों के बीच संयोजन, वरिष्ठ शिक्षक की तरह मूल्यांकन 💡 सामग्री सार्थकता — "सही लेकिन बेकार" बातों को पकड़ें, प्रत्येक अनुभाग की वास्तविक जानकारी में वृद्धि की गणना करें 🤖 AIपन की पहचान — पाठ्यपुस्तक-विशिष्ट मानक, सामान्य लेखन और AI टेम्पलेट में अंतर करें 📖 पढ़ने योग्यता — पैराग्राफ की लय, शब्दावली का घनत्व, मूल्यांकन करें कि छात्र आसानी से पढ़ सकते हैं या नहीं प्रमुख विशेषताएँ: 🔗 अध्यायों में एकरूपता — स्वचालित रूप से ज्ञान फ़ाइल बनाएँ, अवधारणाओं में विरोधाभास, शब्दावली में असंगति, बार-बार परिभाषा का पता लगाएँ 🔄 बंद लूप में सुधार — संशोधन के बाद पुनः सबमिट करें, स्वचालित रूप से सुधार, शेष, और नई समस्याओं पर नज़र रखें 📊 स्तरीय रिपोर्ट — पहले समग्र स्कोर + शीर्ष 3 समस्याएँ देखें, फिर आवश्यकतानुसार प्रति अनुच्छेद विश्लेषण देखें 🎤 स्पष्ट भाषा — बिना सुधारे न कहें, "यह परिभाषा गलत है" जैसी बात सीधे कहें, प्रत्येक आलोचना के साथ बदलाव का संदर्भ दें उपयोग: AI सहायता से लिखी गई स्नातक एवं स्नातकोत्तर पाठ्यपुस्तकें, शैक्षणिक पुस्तकें, पाठ्यक्रम नोट्स। वर्तमान संस्करण स्नातक पाठ्यपुस्तकों के लिए अनुकूलित है, स्नातकोत्तर के लिए भी उपयुक्त। अध्याय चिपकाएँ → स्कोर प्राप्त करें → लक्षित सुधार करें → पुनः जाँच करें, जब तक गुणवत्ता मानक पर न आ जाए।
AI प्रॉम्प्ट आर्किटेक्ट MAX
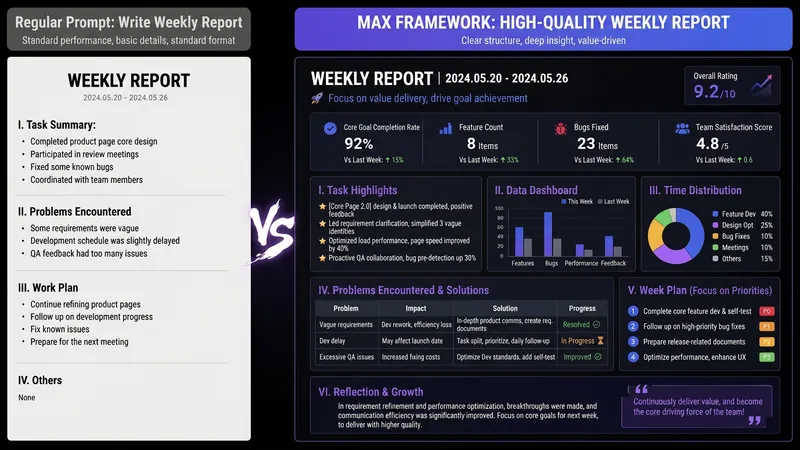
क्या आपके साथ कभी ऐसा हुआ है— AI से साप्ताहिक रिपोर्ट लिखने को कहा, तो उसने प्राथमिक कक्षा के बच्चे जैसी घटनाओं की सूची बना दी; AI से रिज़्यूमे सुधारने को कहा, तो उसने “टीमवर्क, मेहनत और ज़िम्मेदारी” जैसे घिसे-पिटे शब्द भर दिए; AI से डेटा का विश्लेषण करने को कहा, तो उसने शुरुआत की, “एक AI के रूप में, मुझे आपकी मदद करके खुशी होगी…” समस्या AI में नहीं है, बल्कि आपके निर्देश बहुत शुरुआती स्तर के हैं। बाज़ार में Prompt सिखाने वाले टेम्पलेट पहले से ही बहुत हैं, लेकिन टेम्पलेट इस्तेमाल करने के बाद भी आप लिख नहीं पाते—क्योंकि आपको टेम्पलेट की नहीं, ज़रूरतों को compile करने की क्षमता की कमी है। यह SKILL एक AI OPC (AI को वास्तविक काम में लागू करने वाला विशेषज्ञ) के रूप में टीम के लिए Prompt आर्किटेक्चर तैयार करने की मेरी रोज़मर्रा की कार्यप्रणाली को एक “Prompt compiler” में संक्षिप्त करता है। आप सामान्य भाषा में बताएँ, यह आपको बेहतरीन आर्किटेक्चर देगा। इनपुट: “मेरे लिए मासिक रिपोर्ट लिखो” आउटपुट: 8 मॉड्यूल वाला पूरा Prompt आर्किटेक्चर—भूमिका, कार्य, लक्षित पाठक, प्रक्रिया, सीमाएँ, फ़ॉर्मैट, स्व-जाँच और उदाहरण, सब स्पष्ट रूप से तय। इसे ChatGPT / Claude / DeepSeek / Kimi में से किसी में भी कॉपी-पेस्ट करें और पहली बार का आउटपुट ही इस्तेमाल करने लायक होगा। और भी उपयोगी बात यह है कि यह आपको बताएगा: ✓ इस Prompt के लिए कौन-सा मॉडल सबसे अच्छा परिणाम देगा ✓ अगली बार किन वेरिएबल को सीधे बदला जा सकता है (एक बार सीखें, बार-बार इस्तेमाल करें) ✓ आउटपुट को अगले स्तर तक ले जाने के लिए अभी कौन-सी 1 जानकारी कम है यह सामान्य Prompt template SKILL से कैसे अलग है? दूसरे SKILL आपको मछली देते हैं (एक तैयार Prompt); यह SKILL आपको compiler देता है (किसी भी ज़रूरत को Prompt में बदलने की क्षमता)। इसे एक बार इंस्टॉल करें और AI इस्तेमाल करने वाले आपके सभी काम बेहतर हो जाएँगे—लेखन, रिपोर्टिंग, विश्लेषण, अनुवाद, ग्राहक सेवा और रचनात्मक काम, सबके लिए। इसे किसे इंस्टॉल करना चाहिए: जो लोग हर दिन AI इस्तेमाल करते हैं, लेकिन हर बार उसके आउटपुट से असंतुष्ट रहते हैं जो Prompt engineering सीखना चाहते हैं, लेकिन महंगे कोर्स पर हज़ारों रुपये खर्च नहीं करना चाहते टीम में AI को लागू करना चाहते हैं, लेकिन उसे मानकीकृत करने का तरीका नहीं जानते कंटेंट क्रिएटर, शोधकर्ता, विद्यार्थी, नौकरी तलाशने वाले और साइड-हसल करने वाले AI का इस्तेमाल अच्छा है या नहीं, यह इस पर निर्भर नहीं करता कि आप कौन-सा मॉडल इस्तेमाल करते हैं; यह इस पर निर्भर करता है कि आप अपनी ज़रूरत को compile करना जानते हैं या नहीं। इसे इंस्टॉल करें और आज से AI के साथ आपकी बातचीत की गुणवत्ता में बड़ा बदलाव देखें।
जानकारी
- संस्करण
- v4
- आखिरी अपडेट
- रन क्रेडिट
- उपयोग के अनुसार
- मॉडल
- स्वचालित
- उपयोग के मामले
- लेखन और सामग्री
- आपको क्या मिलेगा
- रिपोर्टदस्तावेज़
