स्केल डेटा गुणवत्ता ऑडिट
EFA/CFA-पूर्व सर्वे डेटा गुणवत्ता जाँच
स्केल डेटा गुणवत्ता ऑडिट
EFA/CFA-पूर्व सर्वे डेटा गुणवत्ता जाँच
सामग्री की झलक
विवरण
यह कौशल, स्केल विकास अध्ययन के अंतर्गत एकत्र किए गए कच्चे सर्वे डेटा की व्यवस्थित जाँच करता है। इसमें गुम डेटा, असामान्य अवलोकन, careless responding (straightlining, longstring, random responding), आइटम-स्तरीय वितरण संबंधी समस्याओं, विश्वसनीयता और factorability की पूर्व-शर्तों का मूल्यांकन किया जाता है। यह अंतिम EFA/CFA परिणाम तैयार नहीं करता; इसके बजाय यह प्रमाण-आधारित "go/no-go" निर्णय और स्तरीकृत नमूना विभाजन (EFA/CFA split) का सुझाव देता है, ताकि यह तय किया जा सके कि डेटा अगले विश्लेषण चरणों के लिए तैयार है या नहीं। सभी गणनाएँ वास्तविक कोड निष्पादन (Python: pandas, scipy, factor_analyzer, pingouin) के माध्यम से की जाती हैं; काल्पनिक संख्याएँ उत्पन्न नहीं की जातीं।
संबंधित कौशल
सभी देखें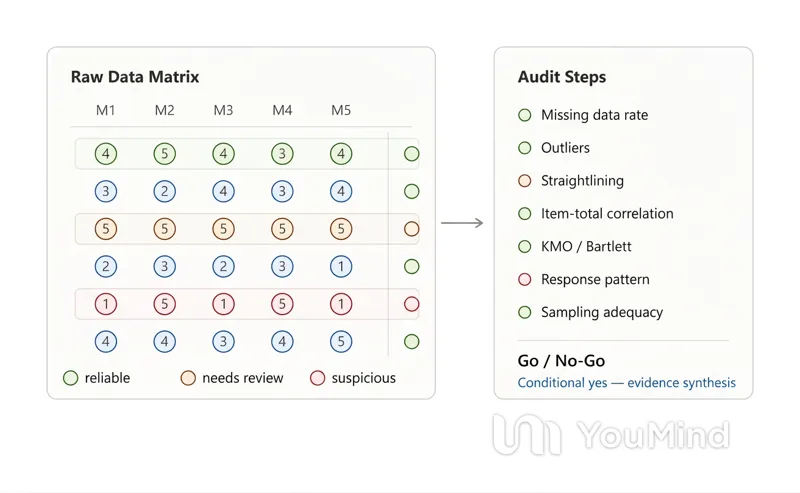
स्केल विकास डेटा प्री-ऑडिट
"पेशेवर सर्वेक्षण कंपनी द्वारा एकत्र किए गए कच्चे स्केल-विकास डेटा (Excel/CSV) के EFA/CFA या अंतिम विश्वसनीयता विश्लेषणों पर जाने से पहले मनोमितीय डेटा गुणवत्ता के दृष्टिकोण से निरीक्षण की आवश्यकता होने पर सक्रिय होता है। यह अनुपलब्ध डेटा, असामान्य मान, असावधान उत्तर, प्रतिक्रिया पूर्वाग्रह, आइटम गुणवत्ता और नमूना पर्याप्तता का व्यापक मूल्यांकन करके Go/No-Go निर्णय तैयार करता है; डेटा में बदलाव नहीं करता, केवल निदान/ऑडिट रिपोर्ट प्रस्तुत करता है।"
 अनुसंधान
वैधता-विश्वसनीयता रिपोर्ट
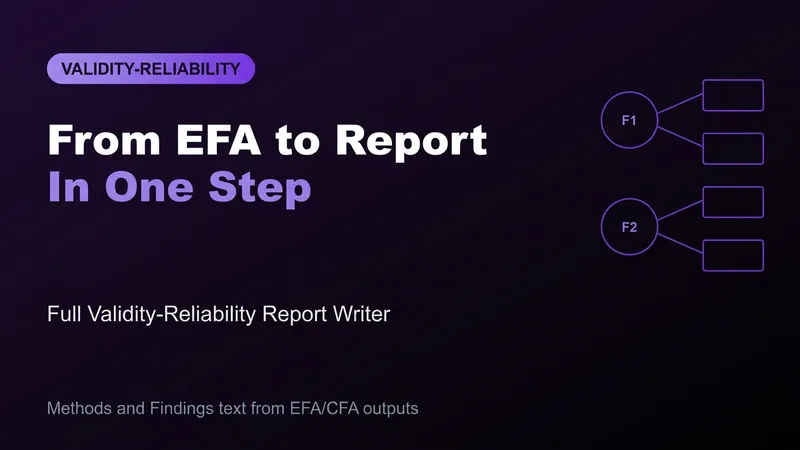
आपके EFA या CFA विश्लेषण आउटपुट (KMO, Bartlett परीक्षण, factor loadings, fit indices, Cronbach alpha/CR/AVE) से लेख के लिए तैयार पूरा विधि + परिणाम पाठ तैयार करता है। यह fit index thresholds (CFI/TLI≥.90, RMSEA≤.08 आदि) को सही ढंग से वर्गीकृत करता है और AVE<0.50 जैसी वैधता समस्याओं को छिपाए बिना रिपोर्ट करता है। इसके लिए उपयुक्त: स्केल विकास या अनुकूलन अध्ययन करने वाले अकादमिक और स्नातकोत्तर छात्र।
जानकारी
- संस्करण
- v2
- आखिरी अपडेट
- रन क्रेडिट
- उपयोग के अनुसार
- मॉडल
- स्वचालित
