Texture della pelle realistica
Prompt per pelle naturale nei ritratti
Texture della pelle realistica
Prompt per pelle naturale nei ritratti
Anteprima
Descrizione
Genera prompt per immagini da testo di persone in selfie, primi piani, mezzi busti e ritratti fotografici, migliorando soprattutto l’effetto plastificato della pelle, la patina oleosa e i volti artificiali dell’IA, per ottenere luminosità, texture e variazioni sottili più naturali. Che si tratti di un ritratto quotidiano, di un ritratto dall’aspetto editoriale, di un’istantanea con flash diretto o di un ritratto realistico con meno effetto IA, puoi personalizzare il risultato in base al soggetto, all’inquadratura, alla luce, allo stile e alle preferenze sulle imperfezioni. I prompt vengono organizzati attorno all’aspetto generale della pelle, alla posizione delle alte luci, alle differenze tra le varie aree del viso, a texture come pori e peluria e alle variazioni naturali del tono cutaneo, evitando di accumulare soltanto termini vaghi come “pelle realistica” o “iperrealistico”. Puoi specificare proporzioni come 9:16, 3:4 e 1:1 e ricevere suggerimenti di composizione e parametri in base al modello di generazione utilizzato; quando necessario, puoi anche ottenere versioni in cinese, inglese o bilingui adatte a GPT-Image, 即梦, 豆包, Midjourney, SDXL o Flux. Oltre ai prompt positivi pronti da copiare, vengono spiegati gli effetti dei principali elementi descrittivi sulla resa della pelle e vengono forniti suggerimenti mirati per individuare e correggere problemi come levigatura eccessiva, lucentezza oleosa su tutto il viso, effetto statua di cera o texture deformate. I prompt generati possono anche essere salvati per tema, così da ritrovarli, modificarli e mantenere una resa coerente nelle serie di ritratti.
Consigliato da
淡苍
Perché consigliamo questa abilità
Scompone la texture della pelle in cinque leve di controllo per ridurre effetto plastico, patina oleosa e volti da IA, con template e prompt bilingui pronti da copiare e ritrovare.
Ideale per
Ideale per creator, appassionati di fotografia e utenti che creano prompt per ritratti naturali e realistici.
Come usare questo Skill
Fornisci i dati
Fornisci soggetto, inquadratura, luce, stile, preferenze sulle imperfezioni e proporzioni dell’immagine; puoi anche indicare il modello di generazione o la lingua desiderata.
Esegui lo Skill
Organizza texture, distribuzione della luce, differenze tra le aree, dettagli della pelle e variazioni naturali, adattando il prompt alla scena.
Controlla il risultato
Ricevi prompt per immagini da testo pronti da copiare, oltre a vincoli negativi opzionali, analisi delle descrizioni e suggerimenti per risolvere problemi di resa.
Abilità correlate
Vedi tutto Immagine
Prompt per ritratti asiatici
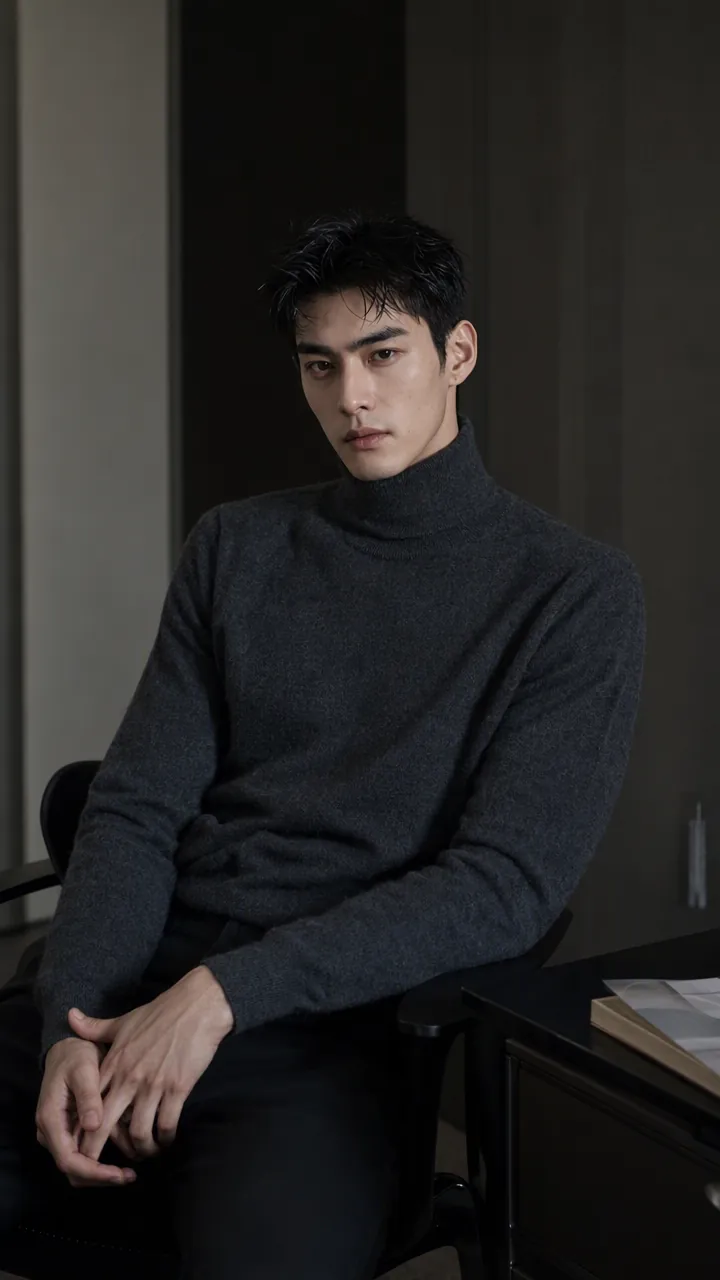
Questa Skill è pensata per chi deve creare prompt di alta qualità per piattaforme di generazione di immagini AI, in particolare per creator e designer che ricercano un’estetica asiatica e rappresentazioni femminili mature e naturali. Trasforma le tue idee creative in prompt concreti e utilizzabili, garantendo immagini armoniose e compatibili con la piattaforma. Le funzioni principali includono la generazione, a partire dalle tue descrizioni, di prompt adatti a diversi modelli di immagini AI molto diffusi, tra cui Midjourney, SDXL, Flux, GPT Image, 豆包, 即梦 e ComfyUI. La Skill riconosce e riscrive in modo intelligente i termini ad alto rischio, così che i prompt rispettino le linee guida di sicurezza delle piattaforme ed evitino espressioni infantilizzanti, volgari o che enfatizzino eccessivamente singole parti del corpo. Puoi inoltre usare comandi rapidi per passare tra diversi stili visivi, come selfie realistici, servizi fotografici da rivista, cosplay di alto livello, cyberpunk o stile classico cinese, e correggere i prompt in base al feedback ottenuto quando la generazione non riesce. Che tu voglia creare una copertina di rivista di moda, un ritratto dall’atmosfera cinematografica o il design di un personaggio 3D in CG, questo strumento offre descrizioni linguistiche precise e suggerimenti sui parametri. I prompt finali vengono ottimizzati in base alla piattaforma selezionata: ad esempio, per Midjourney genera frasi lunghe e naturali in inglese, per SDXL/Flux fornisce gruppi chiari di parole chiave positive e negative, mentre per ComfyUI propone slot dettagliati per parametri modulari, aiutandoti a creare in modo efficiente ritratti AI in linea con le tue aspettative.
 Immagine
Immagini AI di personaggi
Trasforma l’immagine di un personaggio che hai in mente in prompt pronti all’uso e immagini finali. Parti da una breve descrizione iniziale o da un’idea tematica e definisci gradualmente dettagli chiave come acconciatura, accessori per capelli, abbigliamento, espressione, posa, inquadratura, luci, ombre e ambientazione. Che si tratti di una dama in stile antico cinese, una ragazza cyberpunk, un personaggio in stile giapponese, un ritratto realistico o una creazione personalizzata, puoi ottenere una soluzione visiva armoniosa e coerente con l’atmosfera desiderata. Puoi scegliere la generazione rapida, lasciando che l’AI completi automaticamente le caratteristiche del personaggio, oppure usare il controllo dettagliato per modificare ogni elemento selezionandolo o personalizzandolo. Il risultato include prompt strutturati bilingui, in cinese e inglese, e un Negative Prompt adatto allo stile visivo, facili da comprendere e riutilizzare e compatibili con modelli diffusi come FLUX, Midjourney e SDXL. Inoltre, puoi ottenere l’immagine del personaggio tramite la generazione di immagini AI. Dopo la generazione puoi continuare a perfezionare il risultato per categorie, ad esempio cambiando acconciatura, espressione, posa, angolazione della fotocamera, luci, ombre, ambientazione o stile visivo. Gli elementi modificati vengono indicati chiaramente e il personaggio viene rigenerato mantenendo inalterate le altre impostazioni. Ideale per la progettazione di personaggi, concept art, creazione di avatar, ideazione di illustrazioni ed esplorazione di concept visivi.
 Immagine
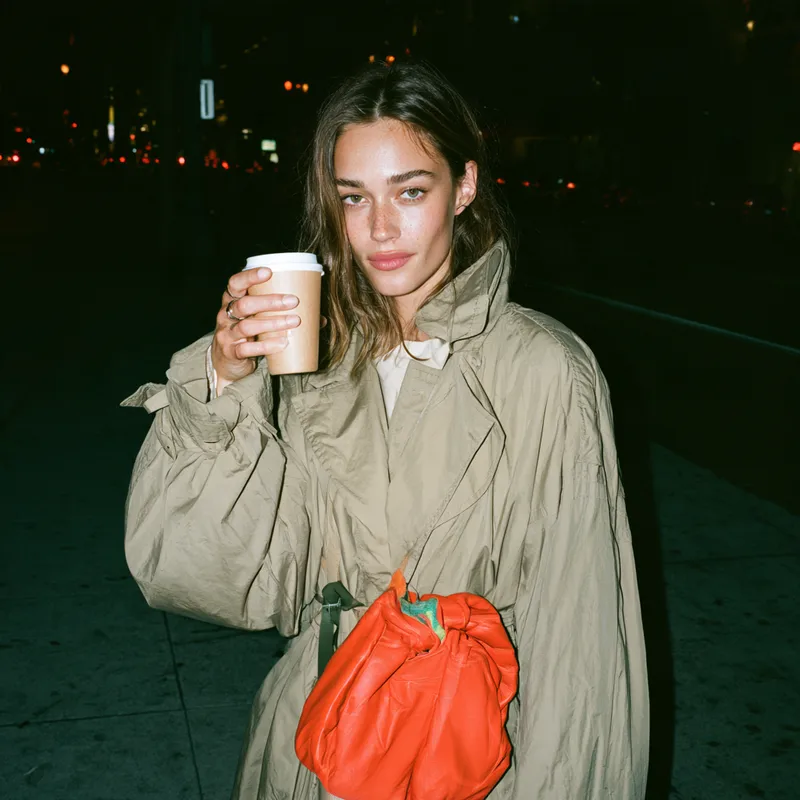
Moda street: prompt con flash
Genera prompt per immagini di moda street, borse, calzature e altri accessori con un autentico effetto da scatto ravvicinato con flash diretto. I prodotti restano nitidi e in evidenza, mantenendo al tempo stesso pose spontanee e l’atmosfera di un’istantanea in un vero ambiente urbano. Ideale per la fase iniziale di concept visivi per brand, contenuti social e moda e accessori, senza trasformare la scena in uno shooting da studio rigido e impostato o in una campagna pubblicitaria eccessivamente ritoccata. Puoi fornire un singolo prodotto, un outfit indossato o una situazione d’uso specifica, indicando colori, materiali, quantità, modalità di trasporto e formato dell’immagine. La skill organizzerà la scena attorno a un flash frontale ravvicinato, ombre brevi e nette, un’esposizione ambientale piuttosto scura ma leggibile e sfondi street in grigio naturale, bianco o blu scuro. Adatterà inoltre la composizione a diverse modalità, come portato a mano, a tracolla o appoggiato su un tavolo, per rendere più visibili la struttura della borsa, i manici, le suole e i dettagli degli abiti. L’output predefinito include idee visive indipendenti in formato 16:9 e prompt utilizzabili direttamente con Midjourney e ImageGen in cinese; se ti serve un solo formato, puoi richiederlo. Per le serie composte da più immagini, può mantenere coerenti le caratteristiche del prodotto e lo stile visivo, cambiando al contempo scena e posa: è ideale per creare una serie coordinata di immagini di moda street.
Informazioni
- Versione
- v6
- Ultimo aggiornamento
- Crediti per esecuzione
- In base all’utilizzo
- Modelli
- Automatico
- Casi d’uso
- Immagini e design
- Cosa otterrai
- Prompt