รวมภาพซับไตเติลวิดีโอ
สร้างภาพยาวซับไตเติลจากวิดีโอ
รวมภาพซับไตเติลวิดีโอ
สร้างภาพยาวซับไตเติลจากวิดีโอ
พรีวิวเนื้อหา
คำอธิบาย
แปลงวิดีโอในเครื่องหรือวิดีโอออนไลน์ที่คุณมีสิทธิ์จัดการ ผ่านกระบวนการดึงแหล่งที่มา ระบุข้อความ เลือกหัวข้อและประโยค ดึงเฟรมแม่นยำ ครบกระชับ ต่อภาพ และตรวจสอบคุณภาพทีละภาพ เพื่อสร้างภาพยาวซับไตเติลวิดีโอในสัดส่วน 3:4 หรือคงสัดส่วนเดิมของภาพ รองรับผลลัพธ์สองรูปแบบที่ชัดเจน ได้แก่ โหมดซับไตเติลต้นฉบับสำหรับรักษาซับไตเติลที่ฝังอยู่ในภาพ และโหมดซับไตเติลสคริปต์สำหรับการวาดเวลาและบทพูดที่ตรวจสอบแล้วลงบนเฟรมวิดีโอจริง ใช้เมื่อผู้ใช้ต้องการภาพหน้าจอซับไตเติลเดิม การต่อภาพซับไตเติล ภาพยาวคำคมจาก YouTube ภาพหน้าจอช็อตบทพูด ไม่วาดซับไตเติลใหม่ บทพูดภาษาจีนกำหนดเอง หรือปรับสัดส่วนภาพหลัก พื้นที่ซับไตเติล ระยะห่างบทพูด และความสวยงาม
แนะนำโดย
Dancang
เหตุผลที่เราแนะนำทักษะนี้
คัดสรรทักษะนี้เนื่องจากมีความโดดเด่นในการแยกแยะระหว่างการรักษาคำบรรยายดั้งเดิมของภาพกับการวาดคำบรรยายสคริปต์ภายหลังอย่างเคร่งครัด ซึ่งช่วยป้องกันการแก้ไขเนื้อหาต้นฉบับผิดพลาด พร้อมทั้งจัดระเบียบ ์บทพูดที่ตรวจสอบแล้วให้อยู่ในรูปแบบภาพยาวที่เหมาะกับการแชร์ นอกจากนี้ยังครอบคลุมการตรวจสอบผู้พูด การคัดกรองเฟรมที่เสถียร และการตรวจสอบคุณภาพภาพทีละภาพ ทำให้ผลลัพธ์มีความน่าเชื่อถือสูงขึ้น
เหมาะสำหรับ
เหมาะสำหรับครีเอเตอร์และผู้ตัดต่อที่ต้องการจัดระเบียบซับไตเติลเดิมหรือบทพูดที่ตรวจสอบแล้วจากวิดีโอให้เป็นภาพยาวที่แชร์ได้
วิธีใช้ Skill นี้
ระบุข้อมูลนำเข้า
ระบุวิดีโอในเครื่องหรือวิดีโอออนไลน์ที่คุณมีสิทธิ์จัดการ พร้อมกำหนดโหมดซับไตเติลต้นฉบับหรือซับไตเติลสคริปต์ ช่วงเวลาหรือบทพูด รวมถึงสัดส่วนภาพและข้อกำหนดอื่นๆ
เรียกใช้ Skill
เลือกและตรวจสอบเฟรมวิดีโอพร้อมเนื้อหาซับไตเติล รักษาซับไตเติลเดิมหรือวาดบทพูดที่ยืนยันแล้วลงบนเฟรมจริงตามโหมดที่เลือก จากนั้นนำมาต่อกันเป็นภาพยาวและตรวจสอบทีละภาพ
ตรวจสอบผลลัพธ์
รับภาพยาวซับไตเติลวิดีโอหนึ่งภาพหรือหลายภาพ พร้อมข้อมูลช่วงเวลาหรือบทพูดและภาพรวมตัวอย่าง
ทักษะที่เกี่ยวข้อง
ดูทั้งหมด
MiniMax H3 ถอดพรอมต์วิดีโอ
ส่งวิดีโออ้างอิงฉบับเต็มให้ AI แบบมัลติโมดัล เพื่อแยกวิเคราะห์ช็อตจริง ไทม์ไลน์ การเปลี่ยนแปลงของภาพ และเสียงที่ได้ยินโดยอัตโนมัติ พร้อมสร้างพรอมต์ระดับใช้งานจริงสำหรับการสร้างวิดีโอโดยตรง ไม่จำกัดเฉพาะบุคคล โฆษณา หรือฟุตเทจภาพยนตร์ แต่ยังเหมาะกับการนำเสนอสินค้า สถาปัตยกรรมและทิวทัศน์ สัตว์ อาหาร การเคลื่อนไหวด้านกีฬา การเต้น แอนิเมชัน 2D/3D การสาธิต UI การบันทึกหน้าจอ อินโฟกราฟิก วิชวลเอฟเฟกต์ และภาพนามธรรมหลากหลายประเภท ตามโครงสร้างข้อมูลของวิดีโอ ผู้ช่วยสามารถสร้างพรอมต์วิดีโอจากข้อความฉบับเต็ม หรือสร้างพรอมต์ภาพอ้างอิง/เฟรมแรกสำหรับวิดีโอจากภาพตามแต่ละ Shot พร้อมคำอธิบายการเคลื่อนไหวต่อเนื่อง พรอมต์เฟรมท้ายที่จำเป็น และข้อกำหนดความคงที่ในระดับช็อต เมื่อทั้งภาพนิ่งและการเปลี่ยนแปลงตามเวลามีความสำคัญ ก็สามารถจัดทำทั้งสองเวอร์ชันได้ เนื้อหาที่สร้างจะคงข้อมูลที่ยืนยันได้จริง เช่น ตัวแบบ องค์ประกอบภาพ การเคลื่อนกล้อง เหตุและผลของการเคลื่อนไหว การเปลี่ยนแปลงของโครงสร้าง ข้อความ บทสนทนา เสียงแวดล้อม และดนตรี พร้อมติดตามแต่ละช็อตจนถึงสภาวะสิ้นสุดจริง สำหรับข้อความ เสียง ตัวตน สถานที่ หรือวิธีถ่ายทำที่ไม่สามารถยืนยันได้อย่างชัดเจน ผู้ช่วยจะหลีกเลี่ยงการเติมข้อมูลขึ้นเอง นอกจากนี้ยังแยกภาพเป้าหมายออกจากองค์ประกอบภายนอก เช่น ลายน้ำของเครื่องเล่นและชั้นควบคุม เพื่อลดการคลาดเคลื่อนของเนื้อหาระหว่างการสร้าง เหมาะสำหรับครีเอเตอร์และทีมผลิตที่ต้องการถอดพรอมต์วิดีโอจากข้อความจากวิดีโออ้างอิง พรอมต์ช็อตวิดีโอ I2V หรือจัดเตรียมเนื้อหาสำหรับการสร้างวิดีโอขึ้นใหม่ การจำลองสไตล์ และการผลิตโฆษณาแบบเจเนอเรทีฟ
 วิดีโอ
เครื่องสร้างวิดีโอจากนิทานคติ
เปลี่ยนสำนวนจีน เรื่องเล่าคลาสสิก หรือ寓言หนึ่งเรื่อง ให้กลายเป็นสคริปต์สตอรีบอร์ดแบบเล่าเรื่องต่อเนื่องที่พร้อมใช้สร้างวิดีโอได้อย่างรวดเร็ว ไม่ว่าจะเป็น 《守株待兔》 《掩耳盗铃》 《司马光砸缸》 หรือสำนวนที่ผู้ใช้ป้อนเข้ามาโดยตรง ก็สามารถถ่ายทอดฉากหลังของเรื่อง ความสัมพันธ์ระหว่างตัวละคร การกระทำสำคัญ และคติสอนใจ พร้อมเรียบเรียงเป็นเนื้อเรื่องวิดีโอสั้นที่ชัดเจนและกระชับ โดยค่าเริ่มต้นจะมี 2 เวอร์ชัน ได้แก่ 15 วินาทีและ 30 วินาที: เวอร์ชัน 15 วินาทีเหมาะสำหรับนำเสนอเหตุการณ์สำคัญอย่างรวดเร็ว ส่วนเวอร์ชัน 30 วินาทีจะเพิ่มการปูบรรยากาศ ปฏิกิริยาของตัวละคร และฉากการกระทำช่วงไคลแมกซ์ ทำให้เรื่องราวสมบูรณ์และมีความดราม่ามากขึ้น ทุกช็อตจะระบุอารมณ์ ขนาดภาพ การเคลื่อนกล้อง และคำบรรยายที่จำเป็นอย่างชัดเจน พร้อมกำหนดลักษณะภายนอกของตัวละครให้คงที่ เพื่อช่วยให้ตัวละครมีความสอดคล้องกันตลอดช็อตต่อเนื่อง และรองรับโมเดลสร้างวิดีโอทั่วไป คำบรรยายทั้งหมดจะเขียนในรูปแบบเสียงพากย์ (เสียงบรรยายนอกจอ/ตัวละครพูดออกเสียง) เพื่อให้โมเดลวิดีโออ่านบทพูดออกมาจริง แทนที่จะแสดงเป็นข้อความบนหน้าจอ สไตล์เริ่มต้นคือแอนิเมชันการ์ตูน นอกจากนี้ยังสามารถระบุสไตล์ภาพ เช่น ภาพหมึกจีน กระดาษตัด หนังตะลุง หรือภาพสมจริง หรือเลือกเฉพาะระยะเวลาที่ต้องการได้ สคริปต์สุดท้ายจะแสดงเป็นภาษาจีนล้วน ประกอบด้วยบรรยากาศของฉาก รูปลักษณ์ตัวละคร ภาพในแต่ละช็อต และข้อกำหนดด้านความสอดคล้อง เหมาะสำหรับสร้างแอนิเมชันสำนวนจีน เรื่อง寓言 หนังสั้นสไตล์จีน และวิดีโอวัฒนธรรมดั้งเดิมสำหรับเด็กหรือผู้ชมทั่วไป
 วิดีโอ
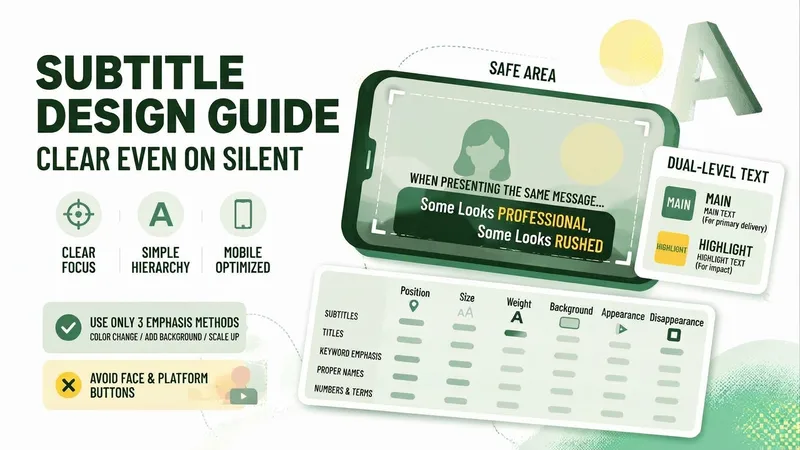
เช็กลิสต์จัดวางซับ
เกณฑ์เดียวในการตัดสินว่าซับไตเติลดีหรือไม่คือ เมื่อดูบนมือถือ ในขนาดเท่านิ้วโป้ง และเปิดแบบปิดเสียงแล้ว ยังอ่านเข้าใจได้ในพริบตาหรือไม่【เช็กลิสต์จัดวางซับ】เริ่มจากกฎเหล็กสามข้อ—พื้นที่ปลอดภัย (ต้องเว้นด้านบน ล่าง ซ้าย และขวาเท่าไร พร้อมอธิบายแยกสำหรับแนวตั้งและแนวนอน) ขีดจำกัดจำนวนตัวอักษรต่อบรรทัด (พร้อมอธิบายเหตุผลว่าในหนึ่งวินาทีคนเราอ่านได้ไม่เกินจำนวนหนึ่ง) และลำดับชั้นต้องมีได้เพียงสองระดับ (ตัวหลักกับตัวเน้น หากมีสามระดับจะดูยุ่งเกินไป) จากนั้นให้ตารางพารามิเตอร์การจัดวางที่กรอกตามได้ทันที ครอบคลุมซับไตเติล ชื่อเรื่อง การเน้นคีย์เวิร์ด ชื่อบุคคลและสถานที่ ตัวเลข และคำเฉพาะ โดยระบุตำแหน่ง ขนาดสัมพัทธ์ น้ำหนักตัวอักษร มีพื้นหลังหรือไม่ จังหวะปรากฏและหายไปทีละรายการ พร้อมระบุพื้นที่ที่ควรหลีกเลี่ยงใบหน้าและปุ่มของแพลตฟอร์ม การเน้นคีย์เวิร์ดมีให้เลือกเพียงสามวิธี (เปลี่ยนสี/เพิ่มพื้นหลัง/ขยายขนาด) และต้องเลือกใช้เพียงวิธีเดียวเท่านั้น นอกจากนี้ยังมีหกวิธีที่ดูเป็นมือสมัครเล่นมากที่สุดพร้อมแนวทางแก้ และวิธีตรวจสอบแบบง่าย ๆ บนมือถือขณะปิดเสียง กฎที่ต้องยึดถือ: ไม่เขียนบทพูดหรือสคริปต์ ไม่แนะนำไฟล์ฟอนต์เฉพาะ ไม่สอนวิธีใช้การบิดเบือนเพื่อบังข้อความและหลบเลี่ยงการตรวจสอบของแพลตฟอร์ม ไม่วิจารณ์หน้าตาหรือสำเนียงของผู้ใช้ และไม่รับประกันอัตราการดูจนจบ
ข้อมูล
- เวอร์ชัน
- v4
- อัปเดตล่าสุด
- เครดิตในการใช้งาน
- ตามการใช้งานจริง
- โมเดล
- อัตโนมัติ
- กรณีใช้งาน
- ภาพและการออกแบบ
- สิ่งที่คุณจะได้รับ
- รูปภาพข้อมูล