Murat Sakal
 Дослідження
Силабус і план на 14 тижнів
Створює повний силабус і детальний 14-тижневий план курсу на основі інформації про нього; містить зіставлення результатів навчання з тижнями та ваги оцінювання. Для кого: академічні працівники, які запускають новий курс або перебудовують наявний.
 Дослідження
Пошук тем і прогалин
Пропонує оригінальні, реалістичні теми досліджень і наукові прогалини у вашій галузі інтересів на основі відомої літератури; для кожної пропозиції надає чернетку дослідницького запитання та оцінку здійсненності. Для кого: аспіранти й дослідники, які шукають тему для дисертації або статті.
 Дослідження
Пошук журналу й оцінка
Рекомендує відповідні національні або міжнародні наукові журнали на основі теми рукопису та ваших побажань (квартиль, термін розгляду, плата); для кожного пояснює відповідність тематиці, квартиль і потенційні ризики; окремо вказує на будь-які підозри щодо хижацького журналу. Для кого: науковці й аспіранти, які готують рукопис до подання.
 Дослідження
Силабус і план на 14 тижнів
Створює повний силабус і детальний 14-тижневий план змісту на основі даних про ваш курс; також містить відповідність між результатами навчання та тижнями й вагові коефіцієнти оцінювання. Для кого: академічні працівники, які запускають новий курс або структурують наявний.
 Дослідження
Виявлення тем і прогалин
Пропонує оригінальні, здійсненні теми й прогалини для дослідження відповідно до ваших інтересів і знань про наявну літературу; для кожної подає чернетку дослідницького питання та примітку щодо здійсненності. Для кого: аспіранти й дослідники, які шукають тему для дисертації або статті.
 Дослідження
Пошук журналів і відповідності
Рекомендує відповідні академічні журнали на основі теми вашої статті та ваших побажань (національне/міжнародне охоплення, квартиль Q, терміни рецензування, вартість); для кожного пояснює відповідність тематиці, квартиль і можливі ризики; чітко попереджає про підозру щодо хижацького журналу. Для кого: науковці й аспіранти, які готують статтю до публікації.
 Дослідження
Аудит ретельності й COREQ
Пише розділ «Методи» на основі критеріїв достовірності Lincoln & Guba та вашого дизайну якісного дослідження; потім без приховування показує, які пункти чекліста COREQ пропущено або описано недостатньо. Для кого: дослідники, які прагнуть підвищити якість звітності перед поданням статті до журналу, та аспіранти, які пишуть дисертацію.
 Дослідження
Тематичний аналіз і кодбук
Створює систематичний кодбук і карту тем на основі уривків необроблених даних або початкових відкритих кодів; пропонує ієрархічну структуру «батьківських» і дочірніх кодів для використання в MAXQDA/NVivo. Підтримує індуктивний, дедуктивний або гібридний підхід до аналізу. Для кого: для дослідників, які проводять тематичний аналіз або контент-аналіз.
 Дослідження
Гайд інтерв’ю та фокус-груп
Готує повний напівструктурований гайд для інтерв’ю або протокол фокус-групи — від вступних запитань до завершення — на основі вашого дослідницького запитання та профілю учасників. Створює нейтральні відкриті запитання й пропонує апріорний список кодів для MAXQDA/NVivo. Для кого: дослідники та аспіранти, які проводять якісні або змішані дослідження.
 Дослідження
Якісна надійність і COREQ
На основі дизайну вашого якісного дослідження напише розділ «Методи» відповідно до критеріїв надійності Lincoln & Guba, а потім відкрито покаже, які пункти за чеклістом COREQ відсутні або недостатньо описані. Для кого: дослідники, які прагнуть забезпечити надійність звітування перед поданням статті до журналу, та аспіранти, які пишуть дисертацію.
 Дослідження
Генератор тематичного аналізу
Створює систематичну кодову книгу та карту тем на основі уривків сирих даних або початкових відкритих кодів; пропонує коди в батьківсько-дочірній структурі для використання в MAXQDA/NVivo. Підтримує індуктивний, дедуктивний або змішаний підходи до аналізу. Для кого: дослідники, які проводять тематичний аналіз або аналіз змісту.
 Дослідження
Протокол інтерв’ю/фокус-групи
Створює повну напівструктуровану форму інтерв’ю або протокол фокус-групи — від вступних запитань до завершення — відповідно до вашого дослідницького питання та профілю учасників. Генерує ненавідні відкриті запитання та пропонує попередній список кодів для використання в MAXQDA/NVivo. Для кого: академічні дослідники та аспіранти, які проводять якісні або змішані дослідження.
 Дослідження
Автор за STROBE/CONSORT
Створює повні розділи «Методи» й «Результати» відповідно до стандарту, що відповідає дизайну вашого дослідження (STROBE для обсерваційних досліджень, CONSORT для рандомізованих контрольованих випробувань); потім перевіряє, які пункти контрольного списку відсутні або описані недостатньо, і пропонує, як їх доповнити. Для кого: для дослідників, які прагнуть підвищити повноту звітування перед поданням статті до журналу, і студентів магістратури та аспірантури, які пишуть дипломну чи дисертаційну роботу.
 Дослідження
Звіт Каплана—Мейєра
Створює повний текст розділів «Методи» та «Результати» на основі кривої виживання Kaplan–Meier, тесту log-rank і результатів регресії Кокса. Правильно інтерпретує відношення ризиків, окремо вказує на високу частку цензурованих спостережень і нагадує перевірити припущення про пропорційність ризиків для моделей Кокса. Для кого: дослідники, які працюють із клінічними або епідеміологічними даними про виживання.
 Дослідження
Автор логістичної регресії та ROC-AUC
Перетворює результати аналізу логістичної регресії (відношення шансів, довірчий інтервал, ROC-AUC) на академічний розділ «Результати», готовий для безпосереднього включення до рукопису. Правильно класифікує значення ROC-AUC за стандартними орієнтирами й ніколи не перебільшує значущість статистично незначущих змінних. Для кого: дослідники, які створюють клінічні прогностичні моделі, і студенти магістратури та аспірантури.
 Дослідження
STROBE/CONSORT: методи й рез.
Створює повні розділи «Методи» та «Результати» відповідно до стандарту звітності, що відповідає дизайну вашого дослідження (STROBE для спостережних досліджень, CONSORT для рандомізованих контрольованих досліджень); потім відкрито перевіряє, які пункти чекліста пропущено або описано недостатньо, і пропонує, як їх доповнити. Для кого підходить: дослідникам, які прагнуть забезпечити якість звітності перед поданням статті до журналу, і здобувачам наукового ступеня, які пишуть дисертацію.
 Дослідження
Автор звіту Каплана—Мейєра
Створює повний текст розділів «Методи» + «Результати» на основі ваших даних про криву виживання Каплана—Мейєра, тесту log-rank і регресії Кокса. Правильно інтерпретує відношення ризиків, чітко зазначає високий рівень цензурування та нагадує перевірити припущення про пропорційність ризиків для моделі Кокса. Для кого: дослідники, які працюють із клінічними або епідеміологічними даними про виживання.
 Дослідження
Логістична регресія й ROC-AUC
Перетворює результати вашого логістичного регресійного аналізу (відношення шансів, довірчі інтервали, ROC-AUC) на академічний розділ «Результати», який можна безпосередньо додати до статті. Правильно класифікує значення ROC-AUC за стандартними критеріями й не перебільшує значущість змінних, які не мають статистичної значущості. Для кого підходить: дослідники, які будують клінічні прогностичні моделі, і студенти магістратури та аспірантури.
 Дослідження
Повний генератор пакетів .mbz
Створює необхідну XML-структуру та зіставлення розділів із видами активностей для резервної копії курсу Moodle у форматі .mbz, яку можна відновити, на основі повного тижневого змісту курсу (тема, ресурс, завдання, тест); також надає контрольний список перевірки після встановлення. Для кого: викладачі, які хочуть пакетувати багатотижневі курси масово.
 Дослідження
Адаптивна логіка тестів
Створює письмову специфікацію умовного доступу та адаптивної логіки тесту (розблокування модулів за діапазоном балів, розгалуження), яку можна налаштувати в Moodle на основі мети вашого тесту й пулу запитань, а також містить кроки реалізації в інтерфейсі Moodle. Для кого: освітні технологи, які створюють персоналізовані навчальні траєкторії.
 Дослідження
Планувальник курсу Moodle
Створює структурований каркас розділів і тем курсу на основі стислого опису силабуса на кілька тижнів, який можна вручну побудувати в Moodle; для кожного тижня перелічує рекомендовані модулі активностей (Завдання, Тест, Форум, Ресурс) і розподіл ваги оцінювання. Для кого: викладачі, які створюють новий курс у Moodle, і координатори освітніх програм.
 Дослідження
Структура SCORM-контенту
Проєктує структуру контенту (екрани, точки взаємодії, завдання для оцінювання) SCORM-сумісного електронного навчального пакета на основі теми модуля та результатів навчання; потім перевіряє, який екран відповідає кожному результату навчання та як його вимірюють, чітко повідомляючи про будь-який неузгоджений результат і пропонуючи контент для усунення прогалини. Для кого: розробники контенту для електронного навчання та координатори дистанційної освіти.
 Дослідження
Аналітична рубрика
Створює повну аналітичну рубрику з опису вашого завдання або проєкту, структуровану як матриця «рівні виконання × критерії оцінювання» з конкретними, спостережуваними описами. Автоматично узгоджує ваги балів із загальною кількістю балів. Для кого: викладачі та асистенти викладачів, які оцінюють завдання або проєкти.
 Дослідження
Мапер результатів за Блумом
Класифікує ваші навчальні результати за рівнями таксономії Блума, виправляє невимірювані дієслова (наприклад, «знати» або «розуміти») і пропонує відповідний метод оцінювання для кожного результату. Класифікація ґрунтується на фактичній когнітивній складності результату, а не на поверхневому значенні дієслова. Для кого: викладачі, які розробляють навчальні програми й курси, а також комітети з розроблення освітніх програм.
 Дослідження
Банк GIFT і аудит Блума
Створює повний банк питань у форматі GIFT на основі вашої теми та результатів навчання, зокрема питання з множинним вибором, на істинність/хибність, на встановлення відповідності, з короткою відповіддю та із заповненням пропусків. Для кожного питання визначає рівень таксономії Блума, а якщо питання значною мірою зосереджені на нижчих рівнях (Запам’ятовування/Розуміння), явно повідомляє про це й пропонує додаткові питання для перевірки навичок мислення вищого порядку. Для кого: координатори оцінювання та керівники кафедр, які прагнуть перевірити якість банку екзаменаційних питань.
 Дослідження
Автор тижневих планів
Створює структурований тижневий план уроку на основі теми й тривалості заняття. План містить вимірювані навчальні цілі, сформульовані за допомогою дієслів таксономії Блума, погодинний план перебігу уроку та запропонований елемент оцінювання. Завжди узгоджує цілі з активностями. Для кого: викладачі університетів і педагоги, які готують курси або навчальні програми.
 Дослідження
Автор банку питань GIFT
Створює банк тестових запитань із кількома варіантами відповідей у форматі GIFT на основі вашої теми й матеріалів — готовий до прямого завантаження в Moodle через «Банк запитань > Імпорт». Позначає правильний варіант, генерує правдоподібні дистрактори, пов’язані з темою, і не залишає місця для синтаксичних помилок у GIFT. Для кого: викладачі, які працюють у Moodle, і координатори освітніх програм, що готують банки екзаменаційних запитань.
 Дослідження
Генератор .mbz-пакета курсу
Із повного тижневого вмісту курсу (теми, ресурси, завдання, тести) генерує необхідну XML-структуру та відповідність «розділ—активність» для резервної копії курсу у форматі .mbz, яку можна безпосередньо відновити в Moodle; також надає контрольний список для перевірки після встановлення. Для кого: викладачі, які хочуть пакетно зібрати багатотижневі курси (див. модель власного проєкту користувача BSM Güncel Konular).
 Дослідження
Адаптивна логіка іспитів
Із мети іспиту та вашого банку запитань створює письмову специфікацію умовного доступу й адаптивної логіки іспиту (відкриття модулів за діапазоном балів, розгалуження), яку можна реалізувати в Moodle, а також покрокові інструкції з налаштування в інтерфейсі Moodle. Для кого: фахівці з освітніх технологій, які проєктують персоналізовані траєкторії навчання.
 Дослідження
Планер структури курсу Moodle
На основі вашого багатотижневого опису навчальної програми створює структурований скелет розділів і тем курсу, який можна вручну налаштувати в Moodle; для кожного тижня перелічує рекомендовані модулі активностей (Завдання, Тест, Форум, Ресурс) і розподіл ваги оцінювання. Підходить для викладачів і координаторів навчання, які створюють нові курси в Moodle.
 Дослідження
Структура й узгодження SCORM
За темою модуля та результатами навчання створює структуру вмісту SCORM-сумісного пакета електронного навчання (екрани, точки взаємодії, елементи оцінювання). Потім перевіряє, на якому екрані опрацьовується кожен результат навчання та як його вимірюють, чітко звітує про неузгоджені результати й пропонує вміст для усунення прогалин. Для кого підходить: розробники контенту для електронного навчання та координатори дистанційної освіти.
 Дослідження
Дизайнер аналітичних рубрик
На основі опису вашого завдання або проєкту створює повну аналітичну рубрику у вигляді матриці «рівні виконання × критерії оцінювання» з конкретними спостережуваними описами. Автоматично збалансовує ваги балів відповідно до загальної кількості балів. Підходить для викладачів і асистентів, які оцінюють завдання або проєкти.
 Дослідження
Класифікатор за Блумом
Класифікує результати навчання за рівнями таксономії Блума, виправляє дієслова, які неможливо виміряти (наприклад, «знає», «розуміє»), і пропонує відповідний метод оцінювання для кожного результату. Класифікація ґрунтується не на поверхневому значенні дієслова, а на реальній когнітивній вимозі результату. Для кого підходить: викладачі, які розробляють навчальні програми й курси, та комісії з розроблення освітніх програм.
 Дослідження
Банк GIFT + аудит Bloom
Створює з ваших тем і навчальних результатів повний банк запитань у форматі GIFT, що містить запитання з вибором відповіді, запитання «правда/неправда», на встановлення відповідності, із короткою відповіддю та на заповнення пропусків. Позначає рівень таксономії Bloom для кожного запитання та чітко повідомляє, якщо запитання переважно зосереджені на нижчих рівнях (Запам’ятовування/Розуміння), а також пропонує додаткові запитання для оцінювання навичок мислення вищого рівня. Кому підходить: фахівцям з оцінювання та координаторам кафедр, які хочуть перевіряти якість банку завдань для іспитів.
 Дослідження
Укладач щотижневих планів
На основі теми та тривалості заняття, які ви надаєте, створює структурований щотижневий план із вимірюваними цілями навчання, сформульованими за допомогою дієслів таксономії Блума, погодинним перебігом заняття та пропозицією щодо елемента оцінювання. Завжди узгоджує цілі навчання з активностями. Підходить для: викладачів університетів та інструкторів, які розробляють курси або навчальні програми.
 Дослідження
Генератор банку питань GIFT
Створює з наданої теми та вмісту банк запитань із кількома варіантами відповідей у форматі GIFT, який можна безпосередньо завантажити на сторінці Moodle «Банк питань > Імпорт». Позначає правильні варіанти, створює доречні дистрактори за темою та не допускає синтаксичних помилок у GIFT. Для кого: викладачів, які проводять заняття в Moodle, і координаторів навчання, що створюють банки тестових запитань.
 Дослідження
Статзвіт і заперечення
Створює повний розділ «Результати» на основі ваших описових та інференційних статистичних даних, зокрема перевірок припущень. Якщо виявлено порушення нормальності або однорідності дисперсій, рекомендує непараметричний альтернативний тест, а не приховує проблему. Також заздалегідь визначає щонайменше 4 зауваження, які рецензенти журналів часто висловлюють (наприклад, «результати перевірки припущень не наведено», «розмір ефекту не зазначено», «корекцію на множинні порівняння не застосовано»), і надає захисне формулювання для кожного. Для кого: дослідників, які працюють із кількісними методами та прагнуть забезпечити строгість статистичного звіту перед поданням рукопису до журналу.
 Дослідження
Автор тексту тестів груп
Створює готовий до рукопису текст розділу «Результати» відповідно до APA 7 на основі результатів t-тесту, ANOVA або хі-квадрату. Використовує правильний формат статистичного звіту (t(df)=..., p=..., d=...) та інтерпретує розмір ефекту за пороговими значеннями Коена. Нагадує зазначити метод корекції множинних порівнянь, якщо порівнюються три або більше груп. Для кого: дослідники й аспіранти, які проводять експериментальні або порівняльні дослідження.
 Дослідження
Автор описової статистики
Перетворює результати описової статистики користувача (середнє±SD або медіана(IQR), n(%)) на академічний абзац «Характеристики учасників», готовий для вставлення в рукопис, а також на форматовану таблицю Table 1. Обирає правильний описовий показник (середнє±SD або медіана(IQR)) залежно від статусу нормальності й ніколи не змішує їх. Для кого: аспірантів і науковців, які проводять кількісні дослідження та хочуть швидко й коректно написати розділ рукопису «Учасники».
 Дослідження
Статзвіт і зауваження
Створює повний розділ «Результати» на основі ваших описових та інференційних статистичних даних, зокрема перевірок припущень. Якщо виявляє порушення нормальності або однорідності дисперсій, пропонує непараметричний альтернативний тест і не приховує цього. Також заздалегідь визначає щонайменше 4 типові зауваження рецензентів журналів (наприклад, «перевірки припущень не наведено», «розмір ефекту не зазначено», «поправку на множинні порівняння не застосовано») і надає для кожного формулювання відповіді. Для кого: дослідників, які працюють із кількісними методами та прагнуть забезпечити надійність статистичного звітування перед поданням статті до журналу.
 Дослідження
Автор тестів порівняння груп
Створює готовий до вставлення в статтю текст розділу «Результати», що відповідає APA 7, на основі результатів t-тесту, ANOVA або тесту хі-квадрат. Використовує правильний формат статистичного звітування (t(df)=..., p=..., d=...) і інтерпретує розмір ефекту за критеріями Коена. Якщо порівнюються три або більше груп, нагадує зазначити поправку на множинні порівняння. Підходить для дослідників і аспірантів, які проводять експериментальні або порівняльні дослідження.
 Дослідження
Описова статистика
Перетворює результати описової статистики користувача (середнє±СВ або медіана (IQR), n(%)) на академічний абзац «Характеристики учасників», який можна безпосередньо додати до статті, і таблицю у форматі Таблиці 1. Вибирає правильну описову статистику залежно від нормальності розподілу (середнє±СВ або медіана (IQR)) і ніколи їх не плутає. Для кого: аспіранти та науковці, які проводять кількісні дослідження й хочуть швидко та точно написати розділ «Учасники» своєї статті.
 Дослідження
Ентропія-TOPSIS-ML + рецензент
Створює повний звіт у розділах «Методи» та «Результати» на основі результатів зважування за ентропією, ранжування TOPSIS і роботи класифікатора машинного навчання (XGBoost, Random Forest, Logistic Regression тощо). Коректно класифікує інтерпретацію AUC за критеріями Hosmer & Lemeshow і, якщо розрив між показниками на навчальній та тестовій вибірках значний, чітко зазначає ризик перенавчання. Також заздалегідь визначає щонайменше 4 заперечення, які рецензенти журналів часто висувають (наприклад, «як опрацьовано дисбаланс класів», «не використано зовнішню валідаційну вибірку»), і пропонує захисне формулювання для кожного. Підходить для дослідників у галузях медичної інформатики, прогнозування клінічних ризиків або гібридної методології MCDM-ML, які прагнуть забезпечити методологічну надійність перед поданням статті до журналу.
 Дослідження
Автор звіту TOPSIS
Створює повний текст розділів «Методи» та «Результати», готовий для рукопису, на основі результатів вашого аналізу TOPSIS (нормалізована матриця рішень, відстані до позитивного й негативного ідеальних розв’язків, коефіцієнти близькості). Надає таблицю ранжування та пояснює, за якими критеріями найкращі й найгірші альтернативи продемонстрували сильні або слабкі результати. Підходить для дослідників, які працюють із багатокритеріальними задачами ранжування, зокрема вибором постачальників, порівнянням продуктів чи послуг або підтримкою клінічних рішень.
 Дослідження
Автор ваг критеріїв AHP
Перетворює результати попарних порівнянь користувача в AHP (аналітичному ієрархічному процесі), зокрема ваги критеріїв і коефіцієнт узгодженості, на академічний розділ «Зважування критеріїв», готовий для безпосереднього додавання до рукопису. Якщо коефіцієнт узгодженості (CR) перевищує 0,10, це відкрито зазначається, а не приховується. Підходить для дослідників, які використовують методи MCDM, як-от TOPSIS/VIKOR, і визначають ваги критеріїв за допомогою AHP, а також для аспірантів.
 Дослідження
Ентропія-TOPSIS-ML + Захист
Створює повний звіт із розділами «Методи» та «Результати» на основі ентропійного зважування, ранжування TOPSIS і класифікатора ML (XGBoost, Random Forest, логістична регресія тощо). Правильно інтерпретує AUC за критеріями Hosmer & Lemeshow і чітко зазначає ризик перенавчання, якщо різниця між результатами на навчальній і тестовій вибірках є великою. Також заздалегідь виявляє щонайменше 4 заперечення, які часто висувають рецензенти журналів (наприклад, «як враховано дисбаланс класів», «не використано зовнішній набір для валідації»), і пропонує речення для захисту щодо кожного з них. Підходить для дослідників у галузі медичної інформатики, прогнозування клінічних ризиків або гібридної методології багатокритеріального прийняття рішень (БКПР)-ML, а також для тих, хто прагне перевірити надійність методів перед поданням статті до журналу.
 Дослідження
Звіт TOPSIS для аналізу рішень
Готує повний готовий до публікації текст розділів «Методи» та «Результати» на основі результатів аналізу TOPSIS (нормалізована матриця рішень, відстані до позитивного й негативного ідеальних розв’язків, коефіцієнти близькості). Додає таблицю ранжування та пояснює, за якими критеріями найкраща й найгірша альтернативи мають переваги. Для кого підходить: дослідників, які працюють із багатокритеріальними задачами ранжування, зокрема вибором постачальників, порівнянням товарів і послуг та клінічною підтримкою ухвалення рішень.
 Дослідження
Автор звіту про ваги AHP
Перетворює результати матриці парних порівнянь AHP (методу аналізу ієрархій) — ваги критеріїв і коефіцієнт узгодженості — на академічний розділ «Зважування критеріїв», який можна безпосередньо додати до статті. Якщо коефіцієнт узгодженості (CR) перевищує 0,10, це чітко зазначається без приховування. Для кого підходить: дослідникам і аспірантам, які працюють із методами багатокритеріального прийняття рішень, як-от TOPSIS/VIKOR, і визначають ваги критеріїв за допомогою AHP.
 Дослідження
Звіт PLS-SEM + зауваження
Створює повний звіт про вимірювальну та структурну моделі на основі результатів вашого аналізу PLS-SEM (зовнішні навантаження, CR/AVE, дискримінантна валідність HTMT, коефіцієнти шляхів, R²/f²/Q², SRMR). Коректно застосовує поріг HTMT і правила інтерпретації R² (критерії Коена/Чіна), а також уникає причинно-наслідкових формулювань. Крім того, заздалегідь визначає щонайменше 4 зауваження, які рецензенти журналів часто висувають (наприклад, «чому PLS, а не CB-SEM» або «не подано контролю CMB»), і пропонує для кожного коротке речення-відповідь. Підходить для дослідників у сфері бізнесу та соціальних наук, які використовують PLS-SEM для моделювання структурними рівняннями й прагнуть забезпечити методологічну надійність перед поданням статті до журналу.
 Дослідження
Звіт про надійність і валідність
Створює повний текст розділів Methods + Results, готовий для рукопису, на основі результатів аналізу EFA або CFA (KMO, тест Бартлетта, факторні навантаження, індекси відповідності, альфа Кронбаха/CR/AVE). Коректно класифікує порогові значення індексів відповідності (CFI/TLI≥.90, RMSEA≤.08 тощо) і повідомляє про проблеми з валідністю, як-от AVE<0.50, не приховуючи їх. Підходить для: науковців і аспірантів, які розробляють або адаптують шкали.
 Дослідження
Автор тексту про альфа Кронбаха
Перетворює введені вами статистичні дані про надійність (альфа Кронбаха, кількість пунктів, підшкали) на академічний абзац «Аналіз надійності», який можна одразу вставити у ваш рукопис. Формує таблицю прийнятності для кожної підшкали та, якщо виявляє низьке значення альфа (<.60), відкрито зазначає це, а не приховує. Підходить для магістрантів, аспірантів і дослідників, які використовують шкали та хочуть швидко й коректно написати розділ про методи.
 Дослідження
PLS-SEM: звіт і відповіді
Створює повний звіт про вимірювальну та структурну моделі на основі результатів PLS-SEM (зовнішні навантаження, CR/AVE, дискримінантна валідність HTMT, коефіцієнти шляхів, R²/f²/Q², SRMR). Правильно застосовує поріг HTMT і тлумачення R² за критеріями Cohen/Chin та уникає причинно-наслідкових формулювань. Також заздалегідь виявляє щонайменше 4 типові заперечення рецензентів журналів (наприклад, «чому обрано PLS, а не CB-SEM» або «контроль CMB не проведено») і пропонує захисне формулювання для кожного. Підходить дослідникам у сфері бізнесу та соціальних наук, які застосовують структурне моделювання, а також тим, хто прагне посилити методологічну обґрунтованість роботи перед поданням до журналу.
 Дослідження
Валідність і надійність
На основі результатів аналізу EFA або CFA (KMO, тест Бартлетта, факторні навантаження, індекси відповідності, Cronbach alpha/CR/AVE) створює повний готовий до використання в статті текст розділів «Методи» та «Результати». Правильно класифікує порогові значення індексів відповідності (CFI/TLI≥.90, RMSEA≤.08 тощо) і відкрито повідомляє про проблеми валідності, як-от AVE<0.50. Для кого: академічні дослідники й аспіранти, які проводять розроблення або адаптацію шкал.
 Дослідження
Автор аналізу α Кронбаха
Перетворює введені користувачем статистичні дані про надійність (альфа Кронбаха, кількість пунктів, субшкали) на академічний абзац «Аналіз надійності», який можна безпосередньо додати до статті. Надає таблицю прийнятності для кожної субшкали та чітко зазначає низьке значення альфа (<.60), якщо його виявлено, не приховуючи цього. Для кого підходить: для аспірантів і дослідників, які використовують шкали та хочуть швидко й точно написати методологічний розділ дисертації або статті.
 Дослідження
Автор звіту CONSORT 2010
На основі даних вашого рандомізованого контрольованого дослідження (РКД) — методу рандомізації, статусу засліплення, аналізу потужності, чисел CONSORT-потоку (обстежено/рандомізовано/розподілено/проаналізовано), підходу до аналізу ITT/PP — він створює повний проєкт Резюме + Методи + Результати, що відповідає всім 25 пунктам CONSORT 2010. Він не плутає ITT/PP і перевіряє узгодженість чисел блок-схеми (рандомізовані ≥ розподілені ≥ ті, за ким спостерігали ≥ проаналізовані). Також він заздалегідь визначає щонайменше 4 заперечення, які часто висувають рецензенти журналів (наприклад: «чому не було наведено аналіз ITT», «чи перевіряли успішність засліплення», «чи не змінювали кінцеві точки») і пропонує захисне формулювання для кожного. Розроблено для клінічних дослідників у медицині, сестринській справі та фармації, які проводять РКД і прагнуть забезпечити методологічну надійність перед поданням до журналу. Чого цей інструмент не робить: він не виконує статистичний аналіз і не генерує дані — лише перетворює вже наявні результати на звіт за стандартом CONSORT.
 Дослідження
Автор методів STROBE
На основі дизайну вашого поперечного, когортного дослідження або дослідження випадок–контроль, а також після введення методу відбору учасників, змінних, обґрунтування обсягу вибірки та статистичних методів, створює повну чернетку розділів «Методи» та «Результати» з неявним посиланням на всі 22 пункти контрольного списку STROBE (Strengthening the Reporting of Observational Studies in Epidemiology). Наприкінці також надає таблицю відповідності, яка показує, який абзац відповідає кожному пункту STROBE — готову відповідь на запит журналу «будь ласка, заповніть контрольний список STROBE». Уникає причинно-наслідкових формулювань, використовуючи «пов’язано з» замість «спричиняє» в описах спостережних досліджень, і чітко обговорює джерела похибок та змішування ефектів. Підходить для науковців, які працюють в епідеміології, громадському здоров’ї та клінічних дослідженнях.
 Дослідження
Звіт про пропущені дані
Введіть обсяг вибірки, частку або структуру пропущених даних (MCAR/MAR/MNAR), метод роботи з пропущеними даними (видалення випадків, множинне імпутування тощо) і метод виявлення викидів (Z-оцінка, IQR, відстань Махаланобіса), і інструмент створить академічний абзац, який можна безпосередньо вставити до розділу «Попередня обробка даних» вашого рукопису. Якщо між обраним методом і структурою пропущених даних є методологічна суперечність (наприклад, використання видалення випадків за структури MNAR), інструмент чітко на це вкаже. Підходить для аспірантів і дослідників, які проводять аналіз соціологічних або клінічних даних і хочуть швидко та коректно написати розділ про попередню обробку даних.
Аудит якості даних шкали
Ця навичка системно перевіряє необроблені дані анкети, зібрані в межах розроблення шкали, за такими аспектами: пропущені дані, аномальні спостереження, неуважне заповнення (straightlining, longstring, random responding), порушення розподілу на рівні пунктів, а також передумови надійності й факторної придатності. Вона не створює підсумкових результатів EFA/CFA, а надає обґрунтоване доказами рішення «go/no-go» щодо готовності даних до наступних етапів аналізу та рекомендацію зі стратифікованого поділу вибірки для EFA/CFA (EFA/CFA split). Усі обчислення виконуються із запуском реального коду (Python: pandas, scipy, factor_analyzer, pingouin); припущені числа не генеруються.
 Дослідження
Автор повного звіту метааналізу
Створює повний текст розділів «Методи», «Результати» та «Обмеження», що відповідає PRISMA 2020 і Кокранівському довіднику, на основі статистики метааналізу (об’єднаний розмір ефекту, I², Q, τ², показники упередженості публікацій). Не інтерпретує значення I² неправильно, зокрема в контексті «відсотка дисперсії», і уникає надмірно категоричних причинно-наслідкових формулювань, використовуючи обережні вислови на кшталт «результати узгоджуються з…» замість «докази демонструють, що…». Наприкінці також пропонує щонайменше 3 запитання, які може поставити рецензент, разом із реченнями для захисту. Підходить дослідникам, які пишуть статтю за результатами метааналізу й хочуть посилити розділ методів перед поданням до журналу. Чого цей інструмент не робить: не виконує статистичних обчислень на основі необроблених даних — ви вже маєте отримати результати з R, RevMan або CMA. Він лише перетворює ваші результати на академічний текст і допомагає їх інтерпретувати.
 Дослідження
Автор бібліометричних висновків
Перетворює необроблені дані, отримані з VOSviewer або Biblioshiny (Bibliometrix/R), — частотність ключових слів, кластери мережі цитувань, щорічну динаміку публікацій, розподіл за країнами, установами та журналами — на готовий до публікації академічний текст із тлумаченням. Використовує академічний стиль, який описує напрям розвитку наукової літератури, а не просто повторює необроблені числа, і уникає спекулятивних причинно-наслідкових тверджень. Підходить для: дослідників, які пишуть дисертацію або наукову статтю, потребують розділу з бібліометричним аналізом, але мають труднощі з перетворенням необроблених даних на академічний виклад. Використання: вставте безпосередньо список кластерів і ключових слів із VOSviewer або зведену таблицю Biblioshiny; навичка тематично називає й інтерпретує кластери ключових слів, а також оцінює мережу цитувань і структуру співпраці між країнами.
 Дослідження
Автор діаграм PRISMA 2020
Створює текст діаграми потоку, що відповідає PRISMA 2020, і абзац протоколу для дослідників, які проводять систематичні огляди. Коли ви вводите кількість записів на етапах пошуку в базах даних (ідентифікація → скринінг → оцінювання відповідності → включення), Skill перевіряє узгодженість чисел і створює текст, який допоможе обґрунтовано відповісти на запит рецензента: «Чому на вашій діаграмі потоку зникає так багато записів?» Також він перетворює ваші критерії включення й виключення на таблицю у форматі PICO/PECO. Підходить для аспірантів, науковців і попередньої перевірки редакторами статей із систематичних оглядів або метааналізів. Якщо виявлено числову невідповідність (наприклад, включених записів більше, ніж записів, що пройшли оцінювання відповідності), Skill явно повідомляє про це, а не виправляє дані непомітно.
 Дослідження
Повний звіт CONSORT 2010
Створює з даних рандомізованого контрольованого дослідження (РКД) повний чернетковий текст Резюме + Методи + Результати відповідно до 25 пунктів CONSORT 2010, охоплюючи метод рандомізації, стан засліплення, аналіз потужності, кількість учасників у схемі CONSORT (screened/randomized/allocated/analyzed) і підхід до аналізу ITT/PP. Ніколи не плутає підходи ITT і PP та перевіряє узгодженість чисел у блок-схемі (randomized ≥ allocated ≥ followed-up ≥ analyzed). Також заздалегідь виявляє щонайменше 4 заперечення, які часто висувають рецензенти медичних журналів (наприклад, «чому не подано аналіз ITT», «чи перевіряли успішність засліплення», «чи було перемикання результатів»), і пропонує для кожного формулювання відповіді. Розроблено для клінічних дослідників і науковців, які проводять РКД у галузях медицини, медсестринства та фармації й прагнуть забезпечити методологічну надійність перед поданням рукопису до журналу.
 Дослідження
Автор методів за STROBE
Для дизайну поперечного, когортного дослідження або дослідження «випадок — контроль» введіть метод відбору учасників, змінні, обґрунтування розміру вибірки та статистичні методи — і він створить повну чернетку розділів «Методи» та «Результати» з неявним посиланням на 22 пункти чекліста STROBE (Strengthening the Reporting of Observational Studies in Epidemiology). Наприкінці також надається таблиця відповідності, яка показує, який пункт STROBE охоплює кожен абзац. Це допомагає підготуватися до вимоги журналу «заповніть чекліст STROBE». Інструмент уникає причинно-наслідкових формулювань, адже йдеться про спостережне дослідження: замість «спричиняє» використовується «пов’язане з», а джерела систематичної похибки та конфундингу обговорюються явно. Підходить академічним дослідникам у галузях епідеміології, громадського здоров’я та клінічних досліджень.
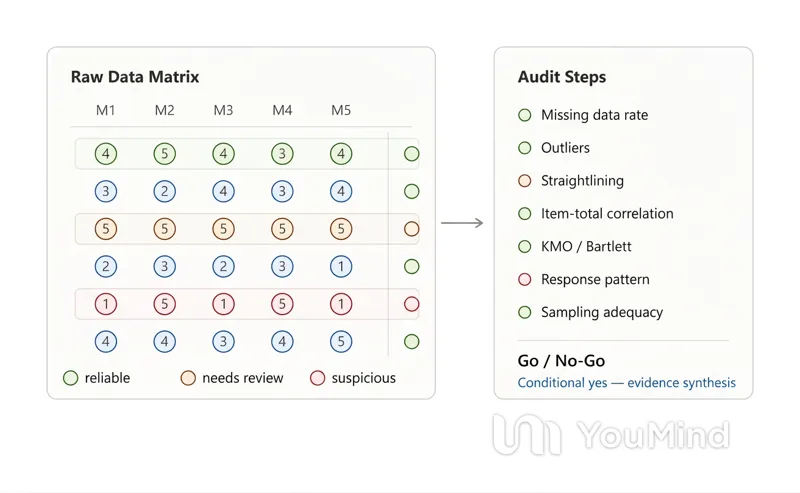
Перевірка даних шкали
Тригериться, коли сирі дані розроблення шкали (Excel/CSV), зібрані професійною дослідницькою компанією, потрібно перевірити на психометричну якість перед переходом до EFA/CFA або фінального аналізу надійності. Комплексно оцінює пропущені дані, викиди, неуважне заповнення, систематичні похибки відповідей, якість пунктів і достатність вибірки та формує рішення Go/No-Go; не змінює дані, а лише надає діагностичний/аудиторський звіт.
 Дослідження
Асистент із пропусків і викидів
Коли ви вказуєте розмір вибірки, частку й тип пропущених даних (MCAR/MAR/MNAR), використаний метод роботи з пропущеними даними (видалення за списком, множинна імпутація тощо) та метод виявлення викидів (Z-оцінка, IQR, Махаланобіс), асистент створює академічний абзац, який можна безпосередньо додати до розділу статті «Попередня обробка даних». Якщо між обраним методом і типом пропущених даних є методологічна неузгодженість (наприклад, використання видалення за списком за типу MNAR), він чітко на це вказує. Підходить для студентів і дослідників, які аналізують дані опитувань або клінічні дані та хочуть швидко й коректно написати розділ про попередню обробку даних.
 Дослідження
Метааналіз і системний огляд
Створює повний текст розділів «Методи», «Результати» та «Обмеження» на основі статистики метааналізу (об’єднаний розмір ефекту, I², Q, tau², показники упередженості публікацій) відповідно до PRISMA 2020 і Кокранівського посібника. Ніколи не тлумачить значення I² неправильно, зокрема частку варіації у відсотках, і уникає перебільшених причинно-наслідкових формулювань, використовуючи обережні вислови на кшталт «результати узгоджуються з...», а не «докази свідчать, що...». Наприкінці також подає щонайменше 3 можливі запитання рецензента та формулювання відповідей для захисту. Підходить для дослідників, які пишуть статтю з метааналізу та хочуть посилити розділ методів перед поданням до журналу. Чого не робить: не обчислює статистику з необроблених даних (ви вже маєте розрахувати результати в R/RevMan/CMA), а лише перетворює їх на академічний текст і тлумачить.
Інтерпретатор бібліометрії
Перетворює необроблені числа з VOSviewer або Biblioshiny (Bibliometrix/R) — частоти ключових слів, кластери мережі цитувань, щорічні тенденції публікацій, розподіл за країнами, установами та журналами — на інтерпретований текст, готовий для академічної публікації. Замість простого повторення чисел використовує академічний тон, щоб пояснити, як розвивається література, і уникає спекулятивних причинно-наслідкових тверджень. Підходить дослідникам, які пишуть дисертацію або статтю та мають підготувати розділ бібліометричного аналізу, але відчувають труднощі з перетворенням необроблених даних на академічну мову. Використання: вставте список кластерів і ключових слів із VOSviewer або зведену таблицю Biblioshiny; skill тематично назве й інтерпретує кластери ключових слів, а також оцінить мережу цитувань і моделі співпраці між країнами.
 Дослідження
Генератор схеми PRISMA 2020
Створює текст схеми та абзац протоколу відповідно до чекліста PRISMA 2020 для дослідників, які проводять систематичні огляди. Коли ви вводите кількість записів із пошуку в базах даних (identification → screening → eligibility → included), перевіряє узгодженість чисел і створює обґрунтований текст у відповідь на запитання рецензента: «Чому у вашій схемі так багато втрат?». Також перетворює критерії включення й виключення на таблицю у форматі PICO/PECO. Цей skill підходить для аспірантів і дослідників, які пишуть систематичні огляди та метааналізи, а також для редакторів журналів, які проводять попередню перевірку. Якщо виявлено числову неузгодженість (наприклад, included > eligibility), її буде чітко зазначено, а не виправлено непомітно.