无露脸频道脚本工作台
拆解频道结构,写出你的原创脚本
无露脸频道脚本工作台
拆解频道结构,写出你的原创脚本
展示内容
描述
为不出镜的 YouTube 频道提供脚本工作台。发送一个用于参考的频道链接和 2–3 份文字稿,它会将频道的主线、句子节奏、语气和留存技巧逆向拆解为包含 12 个维度的风格指纹,然后围绕你的主题撰写完全原创的脚本——切分为每段 3–5 秒的旁白,并将目标字数控制在样本文稿的 ±5% 以内。确认脚本前,视觉内容会保持锁定;确认后,它会分析画面样例,为每个节拍撰写图像提示词、可选的视频片段提示词,最后提供 5 个缩略图概念,每个概念都有独立的点击触发点和生成提示词。每个工作台一次请求;只借鉴结构和感觉,绝不复用原文措辞。
推荐自
Dancang
为什么我们推荐这个技能
以分站式流程拆解频道结构而不复制内容,并将风格分析转化为原创、可直接录制的脚本,再延伸为统一的视觉提示词和缩略图构想。
相关技能
查看全部
YouTube 内容创作
将一个主题转化为一整天的 YouTube 内容,适合无真人出镜的历史、悬疑和教育类频道。你将获得一份引人入胜的长篇视频脚本,采用易于理解的罗马乌尔都语与英语混合表达,包含电影感叙事、事实背景、吸引观众的开场、要点和可直接用于制作的画面建议。 内容包还包括 3 份围绕不同角度创作的短视频脚本、一则罗马乌尔都语社区帖子,以及一个用于促进互动的观众投票。无需从头开始,你就能将一个研究主题延展到主视频、YouTube Shorts 和社区页。 为支持发布,你还会获得 5 条可直接复制使用的 AI 图像提示词,用于制作缩略图和符合历史准确性的影片画面,以及一套完整的 SEO 和缩略图内容包。你可以使用建议的缩略图文字、视频标题、优化后的描述、标签和主题标签,围绕维京人、长城、埃及艳后等教育类主题,规划一套连贯的内容发布。输入一个主题,即可获得支持频道一整天运营的可复用内容素材。
 视频
创作 Hinglish 故事与场景
将主题、一句话创意或现有热门脚本,转化为全新原创的 Hinglish“故事”,面向 YouTube,并为 Google Flow 端到端打造。 你将获得按章节编排、采用大画幅时间层叠电影风格的脚本;专为遵守 Flow 内容政策设计的 8 秒场景提示词(通过暗示处理失去与悲伤,绝不直接呈现);一套 Google Flow 制作工具包,包括锁定的角色标识、统一的电影风格标记、镜头清单和安全预检;完整音频工具包,涵盖逐场旁白、角色声音、环境音、音乐,以及保持音频与视频同步的具体方法;30 秒 Hook Short;缩略图提示词;以及真实可靠的标题、标签和描述。 为什么这个 Skill 与众不同——你很难在其他地方一次获得这些内容 • 让 YouTube 发布更安心。每个故事都基于对 YouTube 当前 AI 内容和获利规则的深入研究:完全原创(绝非重复模板)、不靠制造痛苦博眼球、画面中不出现任何禁用内容,并包含符合频道规范的包装步骤。你无需再为政策警告、“非真实内容”标记和取消获利而反复担心,繁重工作已经完成。 • 受 Christopher Nolan 启发的导演手法。每个故事都采用类似 Nolan 电影的方式进行设计:醒目的闪回式开场、过去与现在的交叉剪辑、逐步逼近高潮的倒计时结构、一个反复出现的母题,以及大画幅、低饱和冷调的电影质感——这些内容纯粹作为风格描述,不会在生成提示词中使用真实人物姓名。 • 一套完整系统。Flow 安全提示词、锁定的角色一致性、固定的 8 秒剪辑网格、完整的音频同步工具包,以及防止故事重复的注册表,都整合在一个 Hinglish 故事工作流中。 Skill 会先检查故事注册表,因此不会重复你已经创作过的故事,并会在整个流程中帮助你的频道保持符合平台规范。
 写作
一份内容,五种形式
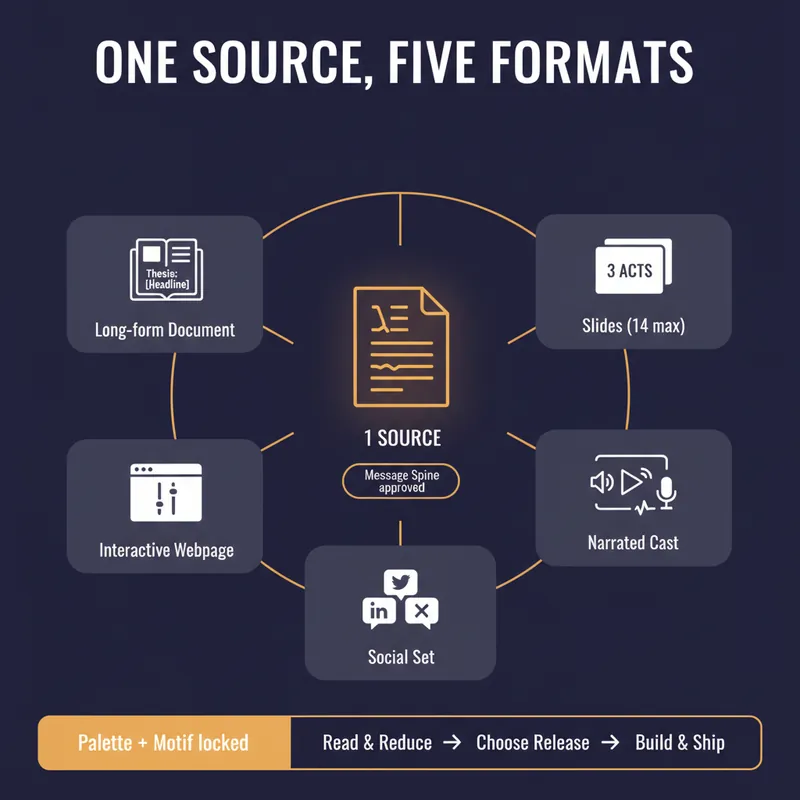
YouMind 可以将一份内容制作成文档、Slides、配音视频、互动网页和一组社交媒体帖子。大多数人只会制作其中一种,因为手工完成全部五种形式,就意味着要把同一个观点写五遍,而且每次都会稍微偏离原意。 这项技能会先建立一条主线,避免内容逐步偏离。 在生成任何内容之前,它会先写出一份“信息主线”:一条不超过 25 个词的核心论点、三个支撑论点、最有力的一条证据、读者明天仍应记得的那一个画面、你希望他们产生的变化,以及明确不适合的受众。由你批准后,每种形式都会直接基于这条主线构建,而不是以前一种形式为基础,因此不会层层放大早先的妥协。 接着,它会告诉你哪些形式真正值得制作。简短的思考性文章不适合做成好的 Slides,密集的数据拆解也不适合做成好的音频。它会推荐两种形式,并解释为什么另外三种会削弱内容——这与内容倍增工具通常会给出的建议恰恰相反。 每种形式都会按照自身规则逐一制作,并在每一步征得你的确认。Slides 遵循每页一个观点的原则,并用演讲者备注承载论证。配音脚本会按照听觉体验来写:数字会适当取整并配上比较,在最有力的证据前安排刻意的停顿。网页只加入一个纯文本无法实现的互动动作。社交媒体内容会让每条帖子从不同的观点切入,避免读起来像同一篇内容的三份复制品;每条帖子都会提供真正有价值的内容,而不是一味乞求点击。 在生成第一张图片之前,就会以文字确定一套配色、字体处理方式和贯穿始终的视觉母题。 最后,你会得到一份发布计划表:每种内容发布到哪里、以什么顺序、间隔多少天、配合什么行动号召,以及需要关注的那一个信号。此外还有一项一致性检查:引用每种形式中的核心论点句,并确认它们仍然一致。 它会在消耗积分前估算所需数量;未经你明确同意,绝不会渲染完整的配音视频或整套图片。
信息
- 版本
- v2
- 更新时间
- 运行积分
- 按实际用量
- 模型
- 自动选择
