搜索引擎
适用于查资料、核实消息与排查报错的多源检索核验
搜索引擎
适用于查资料、核实消息与排查报错的多源检索核验
展示内容
描述
将自然语言问题转化为可追溯的公开网络检索结果,适合查资料、核实消息、寻找公众号文章、排查程序报错,以及搜索论文、技术文档和开源项目。面对需要当前信息或多方证据的主题,它会结合中文与国际搜索结果,覆盖不同类型的公开来源,帮助你减少单一搜索引擎带来的遗漏与偏差。 除了汇总相关页面,还会整理标题、来源、链接和可用的发布时间,对重复结果进行合并,并区分不同机构或网站提供的独立证据。对于关键说法,结果会呈现支持与反对信息、来源之间的分歧,以及基于证据数量和来源质量的可信度判断,让你清楚知道哪些内容得到交叉印证,哪些仍只是孤证或无法确认。 你可以直接输入查询词、待核验的说法,也可以补充领域、时间范围、地区、语言偏好或指定网站。最终获得结构化的检索摘要、来源清单、交叉验证结果和待核实事项;无法访问、需要登录或存在抓取限制的内容会如实标注,不会用推测替代真实来源。
适合人群
适合需要查找公开资料、核实消息、排查技术问题或寻找论文与开源项目的用户。
如何使用此 Skill
提供输入
输入自然语言查询或待核验的说法,可补充领域、时间范围、地区、语言偏好及指定或排除的网站。
运行 Skill
跨多个公开搜索来源检索,整理并去重结果,比较独立证据,标注来源、分歧、可访问性与核验可信度。
查看结果
获得结构化检索摘要、来源清单、交叉验证结果及待核实事项;无法访问或缺少证据的内容会明确标注。
相关技能
查看全部
事实核查 (Fact Check)
把任意观点、结论、数据或方案,交给 AI 事实核查员:联网溯源 + 五级可信度标注 + 推理链漏洞检测,最后给你一份能直接转发的核查报告。 【它做什么】粘贴任意说法,技能自动完成三步核查: 🔍 拆解——把说法拆成「可验证的事实 / 推出的结论 / 价值判断」,严格区分,不把立场当事实 🌐 联网溯源——逐条核实来源、样本、统计口径、时间、完整上下文,多渠道交叉验证 🧩 推理链检查——找出隐藏假设、相关性与因果混淆、遗漏的替代解释,以及结论成立或失效的条件 【为什么值得选】 ✅ 五级可信度标注:已证实 / 基本成立但需收窄 / 存在争议 / 证据不足 / 明显错误,每条附来源链接 ✅ 四段式报告:可信事实与修正 / 推理链最关键的漏洞 / 补强后的最合理版本 / 可以相信到什么程度 ✅ 拒绝臆造:查不到就如实标注「证据不足」,绝不用「可能属实」糊弄你 ✅ 报告即成品:可直接转发给读者、客户或社群 【适合谁】自媒体与内容创作者、投资者与分析师、学生与研究者,以及一切需要快速判断「这句话能不能信」的人。 【怎么用】直接粘贴要核查的说法,一句话到一段落都行。例如输入「桥本甲状腺的人经常精力不好」,即可得到带来源的分级核查报告。 ⚠️ 医疗、法律、投资等专业问题,仅做信息核查,请以专业人士意见为准。
SEO+GEO 全域可见度引擎
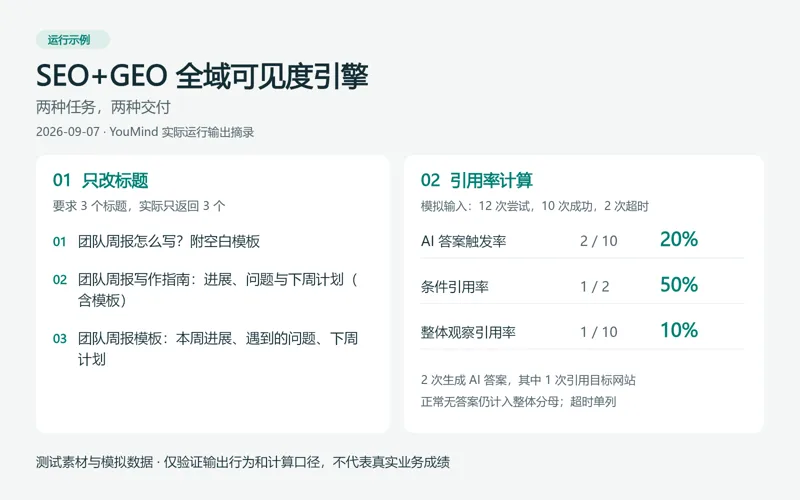
帮你优化文章、产品页和落地页的搜索表现与 AI 引用准备度。可以快速找出最值得改的问题,也可以直接获得标题、改写稿、内容 Brief、技术修复清单或效果复测方案。 四种模式按任务分流:只发链接或正文,默认快速诊断;要求写作,先给可用文本;完整审计按目标引擎与页面拆解;效果复测明确数据来源、分子分母和比较条件。简单任务无需整套长报告。 支持 Google AI Overviews / AI Mode、Bing / Copilot、ChatGPT Search、Perplexity 和 Claude 的分平台检查。搜索、训练与用户触发访问分别判断;中文平台根据实际可用资料和直接观测适配,不套用其他引擎规则。 v8 统一了评分与证据口径,限定局部阻断范围,区分答案触发率、条件引用率和整体引用率,并更新 Google 站点级 AI 控制检查。可用于自有网站、第三方平台文章与未发布草稿,建议会区分你能改的内容和平台侧待验证项。 每项关键判断附证据或明确限制。评分按需提供;不编造数据、作者或引用,也不保证排名、收录与 AI 引用。 实际运行示例(2026-09-07;测试素材,非业务成绩) 标题模式:给“团队周报怎么写”的测试文案要求仅返回 3 个标题,实际只输出: 1. 团队周报怎么写?附空白模板 2. 团队周报写作指南:进展、问题与下周计划(含模板) 3. 团队周报模板:本周进展、遇到的问题、下周计划 计算模式:模拟 12 次尝试,10 次成功、2 次超时;成功运行中 2 次生成 AI 答案,1 次引用目标网站。实际输出:AI 答案触发率 2/10=20%,条件引用率 1/2=50%,整体观察引用率 1/10=10%。正常无答案保留在整体分母,超时单列;这些数值只验证计算口径,不代表真实引用成绩。
 视频
火种|视频素材搜集器
做视频最耗时间的事情之一,不是“知道要配图”,而是把真正能用的素材找对。 一个品牌 Logo,可能同时存在官网、旧版 CDN、Wikimedia、Pinterest 和无数转载页;一张“仓库照片”,搜索结果里可能混着背景布商品图、3D 渲染和完全不相关的库存图。如果只看搜索结果前几张,很容易把错误版本、二手来源甚至错误许可一起带进成片。 「火种|视频素材搜集器」,把素材搜集拆成四种模式: Query Discovery / Single Page Pull / Site Pull / Transcript → Asset Pull 你可以直接说“找 OpenAI 当前官方 Logo”,给一个品牌页面让它从页面里提取,也可以把整段视频 transcript / 脚本交进去,让它先判断“哪些地方真的需要真实视觉素材”,再逐项搜索与验证。 它不会把搜索命中当成素材证据,也不会在不能保存时假装“下载成功”。品牌资产优先官方源;非品牌画面会检查是否真的是目标场景;第三方转载只能作为线索,重要出处与许可尽量回到原始权利方或可信授权平台。 最终交付不是一堆散乱图片,而是一份可继续制作的 素材 Manifest:每项写清素材需求、来源页、图片/文件引用、版本、许可、保存状态和为什么选它,并把失败项与缺口保留下来。 适合:YouTube、知识视频、产品介绍、科技商业内容、纪录/访谈、教程、评测等需要真实 Logo、产品图、人物/地点/场景照片或 B-roll 的创作者。 你可以怎么用 用法 A|直接找一个品牌的官方素材(Query Discovery) 给它:品牌 / 产品 / 人物 / 地点 + 你真正需要的视觉资产。 示例: 帮我找 OpenAI 当前官方 Logo 和 3 个最有用的官方品牌视觉资产。优先官方来源,能保存就直接保存;不能保存就明确说明。 它会:官方品牌页优先 → 逐项验证 → 去重 → 保存 / 引用 → Manifest。 用法 B|把视频脚本变成素材清单(Transcript → Asset Pull) 给它:transcript / 完整脚本 / 分镜文字。 示例: 这是我的全球物流视频脚本。请先判断哪些地方真正需要 Logo、仓库实景、港口或集装箱画面,再去找真实可用素材。不要为了凑数乱加。 它会先拆“画面需求”,再把品牌资产与实景素材分开检索。 用法 C|只从一个官方页面精准提取(Single Page Pull) 给它:指定网页 URL + 数量 / 用途要求。 示例: 只从这个官方品牌页面及其直接官方文件里,提取 4 个最适合视频制作的视觉资产。不要扩展到第三方网站。 适合品牌指南、产品页、新闻稿、媒体中心等明确一手页面。 用法 D|在一个网站里搜相关素材(Site Pull) 给它:官方站点 + 目标素材。 示例: 只在这家公司官网内,找与“自动化仓库”相关的真实照片和产品视觉。优先原图,不要抓导航图标和装饰元素。 适合官网内容很多、目标素材分散在新闻、产品、案例或媒体中心的情况。 最佳输入: 明确素材目标(品牌 / 产品 / 场景 / 人物 / 地点) 完整 transcript / 脚本 / 分镜 指定官方页面 URL 指定官方站点 / 域名 使用场景(片头、角标、B-roll、产品介绍、合作案例等) 数量、分辨率、格式、授权偏好等限制 如果你在意“必须官方”“必须真实照片”“必须可商用”“只能从这个域名找”,直接写出来,Skill 会把这些要求当成筛选门槛,而不是事后备注。
信息
- 版本
- v3
- 更新时间
- 运行积分
- 按实际用量
- 模型
- 自动选择
- 使用场景
- 调研与分析学习与教育开发与技术
- 你将获得
- 报告数据
