Transcription vidéo
Transcription vidéo
Aperçu
Description
Transcrivez des fichiers vidéo ou audio locaux en sous-titres SRT horodatés et en texte brut, en privilégiant le traitement local et en prenant en charge les services ASR distants configurés avec votre consentement.
Compétences associées
Tout voir Écrire
Audio en brouillon
Transformez un fichier audio, une note vocale, une vidéo parlée ou une transcription en un brouillon cohérent et modifiable. Le texte parlé manquant est transcrit automatiquement, avec une poursuite en arrière-plan si nécessaire, afin que l’utilisateur n’ait pas à revenir pour reprendre le processus.
 Recherche
Audio vers tâches et décisions
Transformez un fichier audio ou une transcription en un compte rendu concis et modifiable des décisions, tâches, responsables, dates, blocages et questions en suspens. Si le texte parlé manque, il est transcrit automatiquement, avec une poursuite en arrière-plan si nécessaire, avant de proposer d’éventuelles actions de l’Agent.
 Recherche
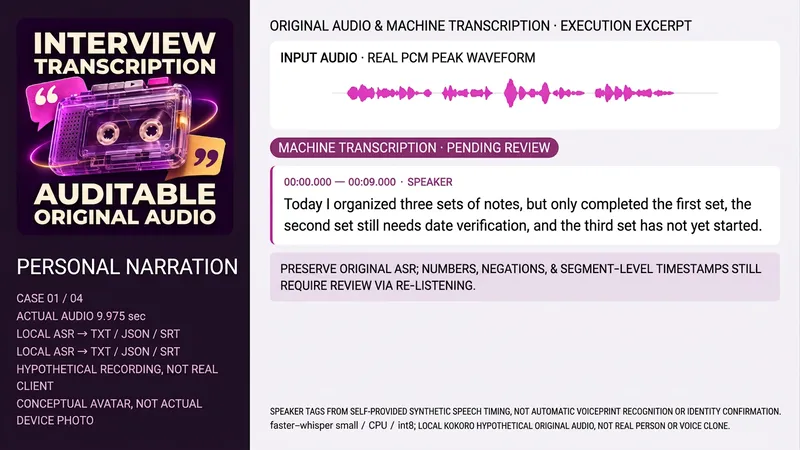
Transcription et temps d'origine
Idéal pour ceux qui doivent structurer des entretiens autorisés, des réunions ou des enregistrements de cours. Fournissez le fichier source, la langue, l'usage, une transcription existante ou une correspondance temporelle fiable des locuteurs ; l'outil ne peut pas confirmer l'identité uniquement par la voix et n'assimile pas les scripts à ce qui a réellement été entendu. Conservation du son original et du hachage → lecture de la durée/piste → ASR réel → organisation selon le minutage réel → étiquetage anonyme des locuteurs avec repères si disponibles → vérification des chiffres, négations, noms et points douteux par écoute du son original → livraison en TXT, JSON, SRT et notes de couverture. Premier jet machine, révision d'écoute et résumé séparés ; le contenu ambigu reste à vérifier, aucun mot n'est ajouté par fluidité. En l'absence d'outils audio/ASR, la non-transcription est explicitement indiquée. Les instructions et le package incluent un assistant local d'origine complet : Python3, FFmpeg/FFprobe, faster-whisper et le cache small préconfiguré, CPU/int8, local_files_only, pas de téléchargement automatique de poids. Une correspondance de locuteur fiable fournit début/fin et étiquettes anonymes pour la transcription et le minutage par fenêtre ; sans correspondance, les repères sont marqués comme inconnus. L'assistant n'effectue pas de diarisation automatique ni d'identification d'identité, et le package n'inclut ni poids, ni compte, ni clé. Quatre exemples de test incluent un monologue personnel en chinois, un entretien en duo en chinois, une présentation de cours en anglais et une réunion en duo en chinois, pour un total d'environ 40,875 secondes d'audio original. L'audio final utilise une synthèse locale en version fixe de Kokoro-82M étiquetée selon la carte de modèle Apache-2.0, avec zf_xiaobei, zm_yunjian et af_heart (aucun humain ni clonage vocal) ; le modèle, les voix ou les audios d'exemple ne sont pas distribués avec le package d'installation. Les quatre exemples réels d'ASR génèrent des fichiers TXT/JSON/SRT, les locuteurs provenant des minutages de prise de parole synthétiques fournis et non d'une diarisation automatique. Il s'agit toujours d'un premier jet machine ; la divergence entre la "sortie" ASR et le "brouillon" du script dans le deuxième exemple reste à confirmer par écoute, sans modification arbitraire pour correspondre au texte initial. Les formes d'onde proviennent des pics PCM d'entrée réels, et non d'ondes décoratives. GPT est recommandé pour la mise en forme du texte, l'ASR s'appuyant sur l'outil réel ; aucune API de transcription OpenAI n'a été appelée localement ni de CLI amont exécuté. L'avatar indépendant est un visuel conceptuel généré par ImageGen, l'outil n'a renvoyé aucun modèle et ne revendique pas Image2. Les outils, le cache, le téléchargement de fichiers et la liaison de modèle côté YouMind n'ont pas consommé de crédits de test ; une vérification selon l'environnement réel est requise. La transcription et l'organisation des locuteurs ne garantissent pas un fonctionnement sans dépendance après installation. Les 299 crédits correspondent au tarif d'installation, hors modèles, API ou services tiers, sans achat automatique ni envoi dissimulé de pistes audio inconnues vers des services tiers. Aucune promesse de zéro faute, de reconnaissance parfaite des accents, bruits ou chevauchements multiples, d'expertise judiciaire ou d'identité, de rapidité ou de résultat commercial. La révision d'écoute indépendante reste à compléter, sans promesse de vérification exhaustive des verbatim.
Informations
- Version
- v2
- Dernière mise à jour
- Crédits par exécution
- Selon l’utilisation
- Modèles
- Automatique
