जैव/चिकित्सा गहन विश्वसनीय शोध
जैव/चिकित्सा गहन विश्वसनीय शोध
सामग्री की झलक
विवरण
उपयोग परिदृश्य: जैविक/जैवचिकित्सा अनुसंधान साहित्य की एक पूर्ण खोज करना और उपयोगकर्ता को विस्तृत एवं विश्वसनीय आउटपुट प्रदान करना। 1. उपयोगकर्ता द्वारा खोज शुरू करने के बाद सिस्टम प्रश्न और कीवर्ड को विभाजित करता है। 2. सार्वजनिक, पुनरुत्पादनीय डेटा स्रोतों का उपयोग करके साहित्य खोजता है। 3. खोज परिणामों को डीडुप्लिकेट, स्तरीकृत, साक्ष्य-स्तरित और क्रमबद्ध करता है। 4. उत्तर में क्लिक करने योग्य इन-लाइन उद्धरणों का उपयोग करता है। 5. अंत में संपूर्ण साहित्य जानकारी को बिंदुवार सूचीबद्ध करता है, और सार्वजनिक रूप से जाँचने योग्य मार्ग से IF अंकित करता है; यदि उच्च विश्वास के साथ सत्यापित नहीं किया जा सकता है, तो इसे 'सत्यापन हेतु लंबित' या 'अनिर्धारित' के रूप में चिह्नित करना अनिवार्य है।
द्वारा अनुशंसित
Nico@YouMind
हमें यह कौशल क्यों पसंद है
यह कौशल जैवचिकित्सा अनुसंधान के लिए एक विश्वसनीय मार्गदर्शक है, जो संरचित क्वेरी, बहु-चरणीय साहित्य छंटाई और कठोर IF सत्यापन के माध्यम से अत्यधिक सटीक और सत्यापन योग्य वैज्ञानिक जानकारी सुनिश्चित करता है।
निर्देश
इस प्रक्रिया का मूल तत्व यह है: सबसे पहले, PubMed/NCBI ई-उपयोगिताओं में पुनरुत्पादनीय प्रारंभिक स्क्रीनिंग करने के लिए कई प्रश्नों का उपयोग करें, फिर डुप्लिकेशन हटाने और सार साक्ष्य ग्रेडिंग के लिए PMID का उपयोग करें; केवल कुछ ही महत्वपूर्ण दस्तावेज़ PMC/BioC पूर्ण-पाठ समीक्षा में शामिल किए जाते हैं; पाठ में उद्धरण क्लिक करने योग्य होने चाहिए; लेख के अंत में संपूर्ण ग्रंथसूची संबंधी जानकारी सूचीबद्ध होनी चाहिए; IF की जाँच केवल सार्वजनिक रूप से उपलब्ध स्रोतों के माध्यम से सावधानीपूर्वक की जा सकती है, और यह मान लेना उचित नहीं है कि इसमें JCR या स्थानीय डेटाबेस शामिल हैं, इसका अनुमान नहीं लगाया जा सकता है, और कम विश्वास वाले मिलानों को निश्चित परिणाम नहीं माना जा सकता है।
1. उपयोगकर्ता द्वारा खोज शुरू करने के बाद पूर्व-प्रसंस्करण
1.1 सबसे पहले, उपयोगकर्ता के प्रश्न का विश्लेषण करें।
उपयोगकर्ता का प्रश्न प्राप्त होने के बाद, प्राकृतिक भाषा में पूछे गए प्रश्न को पहले संरचित तत्वों में तोड़ा जाता है।
पहचान अवश्य की जानी चाहिए:
• अनुसंधान विषय: जीन, प्रोटीन, दवाएं, चैनल, कोशिका प्रकार, ऊतक, रोग और मॉडल।
• जैविक प्रणालियाँ: मनुष्य, चूहे, गिलहरी, ज़ेब्राफ़िश, ऑर्गेनॉइड, रेटिना, मस्तिष्क के क्षेत्र, कोशिका रेखाएँ, आदि।
• संबंधों के प्रकार: अभिव्यक्ति, विनियमन, कार्य, तंत्र, फेनोटाइप, मृत्यु, उत्तरजीविता, उपचार, विषाक्तता, विकास, अपघटन, आदि।
• साक्ष्य संबंधी आवश्यकताएँ: क्या प्रत्यक्ष साक्ष्य, क्रियाविधि संबंधी साक्ष्य, पूर्ण-पाठ साक्ष्य, चार्ट, खुराक संबंधी मापदंड और प्रायोगिक विधियों की आवश्यकता है।
• समय सीमा: असीमित समय, पिछले 5 वर्ष, पिछला 1 वर्ष, नवीनतम घटनाक्रम और क्लासिक साहित्य।
• आउटपुट प्रकार: संक्षिप्त उत्तर, प्रतिनिधि साहित्य, समीक्षा सारांश, प्रायोगिक डिजाइन सुझाव, साक्ष्य तालिका, तंत्र आरेख।
उदाहरण:
उपयोगकर्ता समस्या:
"कृपया मुझे रेटिनल ऑर्गेनॉइड की मृत्यु से संबंधित साहित्य खोजने में मदद करें।"
संरचित विघटन (उदाहरण):
• मुख्य मॉडल: रेटिनल ऑर्गेनॉइड, रेटिना ऑर्गेनॉइड, hPSC-व्युत्पन्न रेटिनल ऑर्गेनॉइड, ऑप्टिक कप ऑर्गेनॉइड।
• फेनोटाइप: कोशिका मृत्यु, एपोप्टोसिस, अपक्षय, जीवन शक्ति में कमी, तनाव, परिगलन।
• संबंधित कोशिकाएं: फोटोरिसेप्टर, कोन, रॉड, रेटिनल गैंग्लियन सेल, म्यूलर ग्लिया।
• संभावित क्रियाविधियाँ: ऑक्सीडेटिव तनाव, ईआर तनाव, माइटोकॉन्ड्रियल शिथिलता, हाइपोक्सिया, सूजन, फेरोप्टोसिस, नेक्रोपोटोसिस।
• साक्ष्य के उद्देश्य: उन मौलिक अध्ययनों को प्राथमिकता दें जो मानव या पशु रेटिनल ऑर्गेनोइड्स में कोशिका मृत्यु/एपॉप्टोसिस/अपघटन का प्रत्यक्ष अवलोकन करते हैं; फिर अप्रत्यक्ष तंत्रों पर साहित्य की तलाश करें।
1.2 कीवर्ड विभाजन सिद्धांत (उदाहरण)
सिर्फ एक सर्च क्वेरी न लिखें। प्रत्येक अवधारणा के लिए कम से कम तीन श्रेणियों के शब्द तैयार करें।
श्रेणी 1: सटीक शब्द।
• रेटिनल ऑर्गेनॉइड
• रेटिना ऑर्गेनॉइड
• मानव रेटिनल ऑर्गेनॉइड
• एचपीएससी-व्युत्पन्न रेटिनल ऑर्गेनॉइड
• iPSC-व्युत्पन्न रेटिनल ऑर्गेनॉइड
दूसरी श्रेणी: समानार्थी शब्द और अतिनाम।
• ऑप्टिक कप ऑर्गेनॉइड
• 3डी रेटिनल कल्चर
• स्टेम सेल से व्युत्पन्न रेटिना
• रेटिना का विभेदन
• रेटिना ऊतक मॉडल
तीसरी श्रेणी: क्रियाविधि और लक्षणात्मक शब्द।
• एपोप्टोसिस
• कोशिकीय मृत्यु
• अध: पतन
• उत्तरजीविता
• तनाव
• ऑक्सीडेटिव तनाव
• ईआर तनाव
• माइटोकॉन्ड्रियल शिथिलता
• हाइपोक्सिया
• नेक्रॉप्टोसिस
• फेरोप्टोसिस
यदि उपयोगकर्ता सेल का प्रकार निर्दिष्ट करता है, तो निम्न जोड़ें:
• फोटोरिसेप्टर
• शंकु
• छड़
• रेटिनल गैंग्लियन कोशिका
• मुलर ग्लिया
• द्विध्रुवी कोशिका
• अमाक्राइन कोशिका
यदि उपयोगकर्ता प्रजाति या मूल स्थान निर्दिष्ट करता है, तो निम्नलिखित जोड़ें:
• इंसान
• चूहा
• चूहा
• ज़ेब्राफ़िश
• एचएससी
• आईपीएससी
• बहुसंभाव्य स्टेम कोशिका
1.3 पदानुक्रमित खोज प्रश्नों को उत्पन्न करना
कम से कम 3-6 क्वेरी जनरेट करें। प्रत्येक क्वेरी एक खोज उद्देश्य से संबंधित होती है।
पहली परत: प्रत्यक्ष साक्ष्य प्राप्ति।
इसका उपयोग ऐसे साहित्य को खोजने के लिए किया जाता है जो सीधे लक्षित मॉडल और लक्षित फेनोटाइप से मेल खाता हो।
```पाठ
("रेटिनल ऑर्गेनॉइड" या "रेटिना ऑर्गेनॉइड" या "मानव रेटिनल ऑर्गेनॉइड") और (एपॉप्टोसिस या "कोशिका मृत्यु" या अपघटन)
```
दूसरी परत: विस्तारित मॉडल पुनर्प्राप्ति।
इसका उपयोग ऐसे साहित्य को संकलित करने के लिए किया जाता है जहां लेखक ने "रेटिनल ऑर्गेनॉइड" शब्द का सटीक रूप से उपयोग नहीं किया है, लेकिन यह वास्तव में प्रासंगिक है।
```पाठ
("ऑप्टिक कप ऑर्गेनॉइड" या "3डी रेटिनल कल्चर" या "स्टेम सेल-व्युत्पन्न रेटिना") और (उत्तरजीविता या एपोप्टोसिस या तनाव)
```
तीसरी परत: तंत्र-विशिष्ट खोज।
विशिष्ट मार्गों या तंत्रों को सत्यापित करने के लिए उपयोग किया जाता है।
```पाठ
("रेटिनल ऑर्गेनॉइड" या "रेटिना ऑर्गेनॉइड") और ("ऑक्सीडेटिव स्ट्रेस" या "ईआर स्ट्रेस" या हाइपोक्सिया या माइटोकॉन्ड्रिया)
```
चौथी परत: कोशिका प्रकार विशिष्ट खोज।
```पाठ
("रेटिनल ऑर्गेनॉइड" या "रेटिना ऑर्गेनॉइड") और (फोटोरिसेप्टर या कोन या रॉड या "रेटिनल गैंग्लियन सेल") और (मृत्यु या एपोप्टोसिस या अपजनन)
```
पांचवीं परत: रोग मॉडल पुनर्प्राप्ति।
```पाठ
("रेटिनल ऑर्गेनॉइड" या "रेटिना ऑर्गेनॉइड") और (रोग या अपक्षय या डिस्ट्रोफी या रेटिनाइटिस या ग्लूकोमा)
```
छठी परत: समीक्षा/पृष्ठभूमि खोज।
```पाठ
("रेटिनल ऑर्गेनॉइड" या "रेटिना ऑर्गेनॉइड") और (समीक्षा या प्रोटोकॉल या मॉडल)
```
2. खोज के लिए किन विधियों और वेबसाइटों का उपयोग किया गया?
2.1 पसंदीदा: पबमेड / एनसीबीआई ई-उपयोगिताएँ
जैवचिकित्सा साहित्य की खोज के लिए PubMed सबसे उपयुक्त उपकरण है। PubMed पृष्ठों से सीधे डेटा प्राप्त करने का प्रयास न करें। इसके बजाय NCBI E-utilities API का उपयोग करें।
2.1.1 ई-सर्च: क्वेरी का उपयोग करके PMID प्राप्त करना
इंटरफ़ेस:
```पाठ
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi
```
पैरामीटर:
```पाठ
db=pubmed
शब्द=<खोज शब्द>
रेटमोड=जेसन
retmax=20
सॉर्ट = प्रासंगिकता
```
आप समय के अनुसार भी क्रमबद्ध कर सकते हैं:
```पाठ
सॉर्ट=पब+डेट
```
उदाहरण:
```पाठ
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=pubmed&term=(%22retinal%20organoid%22%20OR%20%22retina%20organoid%22)%20AND%20(apoptosis%20OR%20%22cell%20death%22)&retmode=json&retmax=20&sort=relevance
```
वापसी से पढ़ें:
```पाठ
esearchresult.idlist
```
यह PMID सूची है।
2.1.2 सारांश: साहित्य मेटाडेटा प्राप्त करना
इंटरफ़ेस:
```पाठ
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi
```
पैरामीटर:
```पाठ
db=pubmed
आईडी=पीएमआईडी1,पीएमआईडी2,पीएमआईडी3
रेटमोड=जेसन
```
निकाले गए फ़ील्ड:
• PMID
• शीर्षक
• पूरा जर्नल नाम
• स्रोत/पत्रिका का संक्षिप्त नाम
• प्रकाशन तिथि
• लेखकों
• लेख आईडी में DOI और PMCID शामिल हैं
• मात्रा, अंक, पृष्ठ
2.1.3 ई-फ़ेच: सारांश और XML विवरण प्राप्त करना
इंटरफ़ेस:
```पाठ
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi
```
पैरामीटर:
```पाठ
db=pubmed
आईडी=पीएमआईडी1,पीएमआईडी2
रेटमोड=एक्सएमएल
rettype=abstract
```
निकाले गए फ़ील्ड:
• लेख का शीर्षक
• सार पाठ
• पत्रिका का शीर्षक
• आईएसओ संक्षिप्त नाम
• ISSN / eISSN
• प्रकाशन तिथि
• डीओआई
• पीएमसीआईडी
• MeSH शब्द
2.1.4 बैच पुनर्प्राप्ति रणनीति
अनुशंसित प्रक्रिया:
1. प्रत्येक क्वेरी के लिए ई-सर्च को कॉल करें।
2. प्रत्येक क्वेरी के लिए, पहले 5-20 परिणाम चुनें।
3. सभी PMID को मर्ज करें।
4. डुप्लिकेट हटाने के लिए PMID का उपयोग करें।
5. मेटाडेटा और सार डेटा को बैचों में प्राप्त करने के लिए ESummary / EFetch का उपयोग करें।
6. प्रारंभिक स्क्रीनिंग चरण में, केवल मेटाडेटा और सारांश पढ़ें; पूरा पाठ पढ़कर शुरुआत न करें।
────────────────
2.2 दूसरा चरण: पीएमसी/बायोसी दस्तावेजों की पूर्ण समीक्षा
निम्नलिखित मामलों में ही पूर्ण पाठ शामिल किया जाएगा:
• उपयोगकर्ताओं से अनुरोध है कि वे पूरा पाठ ध्यानपूर्वक पढ़ें।
• सारांश क्रियाविधि निर्धारित करने के लिए अपर्याप्त है।
• इसमें चार्ट, प्रायोगिक विधियाँ, सांद्रता, खुराक, IC50, EC50, Kd और Ki की आवश्यकता होती है।
• कुछ महत्वपूर्ण PMID की पहचान की गई है और इनकी समीक्षा अलग-अलग मामलों के आधार पर करने की आवश्यकता है।
2.2.1 PMID से PMCID
इंटरफ़ेस:
```पाठ
https://www.ncbi.nlm.nih.gov/pmc/utils/idconv/v1.0/?ids=
```
यदि PMCID वापस आता है, तो इसका मतलब है कि PMC के पास ओपन फुल टेक्स्ट हो सकता है।
2.2.2 बायोसी JSON को प्राथमिकता दें
इंटरफ़ेस:
```पाठ
https://www.ncbi.nlm.nih.gov/research/bionlp/RESTful/pmcoa.cgi/BioC_json/
```
लाभ: अत्यधिक संरचित, मुख्य पाठ अनुच्छेदों को निकालने के लिए उपयुक्त।
2.2.3 BioC अनुपलब्ध होने पर PMC XML का उपयोग करके देखें
इंटरफ़ेस:
```पाठ
https://www.ncbi.nlm.nih.gov/pmc/articles/
```
मुख्य पाठ निकालते समय इसे छोड़ दें:
• संदर्भ
• संदर्भ सूची
• आभार
• लेखकों का योगदान
• परस्पर विरोधी हित
पूर्ण पाठ समीक्षा में एक रोक मानदंड शामिल होना चाहिए:
• प्रत्येक दस्तावेज़ को केवल एक बार स्कैन किया जाता है।
• डिफ़ॉल्ट रूप से, केवल प्रश्न से संबंधित पैराग्राफ ही निकाले जाते हैं।
• यदि लक्षित क्षेत्र का मिलान नहीं होता है, तो उसे "कोई प्रत्यक्ष प्रमाण नहीं मिला" के रूप में चिह्नित करें।
• कीवर्ड को बार-बार स्क्रैप करने से बचें।
────────────────
2.3 बायोआरएक्सिव / मेडआरएक्सिव
नवीनतम प्रीप्रिंट्स के पूरक के रूप में उपयोग किया जाता है।
आप आधिकारिक एपीआई का उपयोग कर सकते हैं:
```पाठ
https://api.biorxiv.org/details/biorxiv/YYYY-MM-DD/YYYY-MM-DD
https://api.biorxiv.org/details/medrxiv/YYYY-MM-DD/YYYY-MM-DD
```
आप पूरक के रूप में नियमित खोज का भी उपयोग कर सकते हैं:
```पाठ
साइट:biorxiv.org रेटिनल ऑर्गेनॉइड एपोप्टोसिस
site:medrxiv.org रेटिना ऑर्गेनॉइड डीजेनरेशन
```
प्रीप्रिंट पर लेबल लगाना अनिवार्य है:
```पाठ
यह एक प्रीप्रिंट है और इसकी पीयर-रिव्यू नहीं की गई है।
```
────────────────
2.4 क्रॉसरेफ़/ओपनएलेक्स/अनपेवॉल
इसका उपयोग डीओआई, ओपन फुल-टेक्स्ट एड्रेस और प्रकाशन संबंधी जानकारी को पूरा करने के लिए किया जाता है।
क्रॉसरेफ़:
```पाठ
https://api.crossref.org/works?query.title=<title>
```
ओपनएलेक्स:
```पाठ
https://api.openalex.org/works?search=<शीर्षक या विषय>
```
अनपेवॉल:
```पाठ
https://api.unpaywall.org/v2/
```
उपयोग:
• डीओआई पूर्णता।
• OA PDF लिंक खोजें।
• जर्नल के नाम का सत्यापन।
• प्रकाशन वर्ष का सत्यापन।
────────────────
2.5 प्रकाशक पृष्ठ
एपीआई जानकारी अपर्याप्त होने पर ही प्रकाशक के पृष्ठ पर जाएं।
पहुँच नियम:
• प्रत्येक प्रकाशक यूआरएल को केवल एक बार ही आजमाया जाएगा।
• यदि आपको कैप्चा, लॉगिन संबंधी बाधाएं, क्लाउडफ्लेयर, एक्सेस अस्वीकृत या संस्थागत पहुंच संबंधी बाधाएं दिखाई देती हैं, तो तुरंत रुक जाएं।
• बार-बार पेज को रीफ़्रेश करने, एक ही साइट के भीतर पाथ बदलने या लूप में प्रतीक्षा करने से बचें।
• PubMed, PMC, Crossref, OpenAlex, Unpaywall और DOI मेटाडेटा को बैकअप विकल्प के रूप में उपयोग करें।
3. जानकारी प्राप्त करने के बाद उसे व्यवस्थित कैसे करें
3.1 एक एकीकृत अभिलेख संरचना स्थापित करें
प्रत्येक दस्तावेज़ को एक एकीकृत अभिलेख में संकलित किया जाता है।
क्षेत्र:
```पाठ
पीएमआईडी
डीओआई
पीएमसीआईडी
शीर्षक
लेखक
पत्रिका
जर्नल_संक्षिप्त
ISSN
ईआईएसएसएन
वर्ष
अमूर्त
क्वेरी_स्रोत
साक्ष्य_स्तर
साक्ष्य_टैग
कागज़_प्रकार
यूआरएल
```
3.2 डुप्लिकेशन हटाना
प्राथमिकता:
1. PMID डुप्लिकेशन हटाना।
2. यदि PMID उपलब्ध नहीं है, तो डुप्लिकेट हटाने के लिए DOI का उपयोग करें।
3. यदि DOI नहीं है, तो डुप्लिकेट हटाने के लिए lower(title) + year + first_author का उपयोग करें।
पहली बार हिट हुई क्वेरी_सोर्स को सुरक्षित रखें, और यह रिकॉर्ड करें कि किन क्वेरी ने दस्तावेज़ को हिट किया।
3.3 साक्ष्य वर्गीकरण
यह अंतर करना आवश्यक है:
प्रत्यक्ष प्रमाण:
लक्षित प्रजाति, ऊतक, कोशिका प्रकार, मॉडल और उपचार की स्थितियाँ सीधे तौर पर मेल खाती हैं।
अप्रत्यक्ष साक्ष्य:
आसन्न प्रणालियाँ, समान मॉडल और समान तंत्र समर्थित हैं, लेकिन वे उपयोगकर्ता की समस्याओं के लिए प्रत्यक्ष प्रणालियाँ नहीं हैं।
कोई प्रत्यक्ष प्रमाण नहीं मिला:
केवल पृष्ठभूमि, अटकलें, समीक्षाएं या संबंधित मॉडल ही उपलब्ध हैं; प्रत्यक्ष प्रयोगात्मक परिणाम उपलब्ध नहीं हैं।
3.4 दस्तावेज़ प्रकार लेबलिंग
कम से कम निम्नलिखित बातों पर ध्यान दिया जाना चाहिए:
• मूल अनुसंधान
• समीक्षा
• शिष्टाचार
• प्रीप्रिंट
• डेटासेट/संसाधन
• नैदानिक अध्ययन
• कार्यप्रणाली पत्र
3.5 छँटाई नियम
अनुशंसित क्रम निर्धारण:
1. प्रत्यक्ष प्रमाणों पर आधारित मौलिक शोध।
2. प्रमुख तंत्रों पर शोध।
3. नवीनतम महत्वपूर्ण शोध।
4. क्लासिक मूलभूत अध्ययन।
5. उच्च गुणवत्ता वाली समीक्षा।
6. अप्रत्यक्ष साक्ष्य।
केवल IF के आधार पर ही सॉर्ट न करें। IF एक जर्नल-स्तरीय संकेतक है और यह किसी व्यक्तिगत लेख की गुणवत्ता के बराबर नहीं है।
4. उत्तर में उद्धरणों को कैसे व्यवस्थित करें
4.1 पाठ उद्धरण प्रारूप
सभी पाठ उद्धरण क्लिक करने योग्य होने चाहिए।
प्रारूप:
```मार्कडाउन
[[1. **पत्रिका**, वर्ष]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
```
उदाहरण:
```मार्कडाउन
पिछले अध्ययनों में मानव रेटिनल ऑर्गेनोइड्स में विकासात्मक चरण से संबंधित फोटोरिसेप्टर तनाव और अध: पतन देखा गया है [[1. **सेल स्टेम सेल**, 2019]](https://pubmed.ncbi.nlm.nih.gov/xxxxxxx/).
```
इसे इस प्रकार न लिखें:
```पाठ
[1]
(पीएमआईडी: xxxxx)
संदर्भ 1 देखें
```
4.2 अनुशंसित उत्तर संरचना
पहला पैराग्राफ: सीधा निष्कर्ष।
```पाठ
निष्कर्ष: प्रासंगिक रिपोर्टें तो आई हैं, लेकिन प्रत्यक्ष प्रमाण मुख्य रूप से... पर केंद्रित हैं; ... के संबंध में प्रत्यक्ष प्रमाण अभी भी अनुपलब्ध हैं।
```
दूसरा अनुच्छेद: साक्ष्य का वर्गीकरण।
```पाठ
प्रत्यक्ष प्रमाण:
- संदर्भ ए: ...
अप्रत्यक्ष साक्ष्य:
- संदर्भ बी: ...
कोई प्रत्यक्ष प्रमाण नहीं मिला:
- इस दौर में नहीं मिला...
```
तीसरा पैराग्राफ: क्रियाविधि का सारांश।
विषय के आधार पर समूह बनाएं, उदाहरण के लिए:
• एपोप्टोसिस/कैस्पेस मार्ग
• ऑक्सीडेटिव तनाव
• माइटोकॉन्ड्रियल शिथिलता
• ईआर तनाव
• हाइपोक्सिया/चयापचयी तनाव
• सूजन
• विकासात्मक बेमेल
चौथा अनुच्छेद: अनुसंधान अंतराल।
स्पष्ट रूप से बताएं कि किन मुद्दों के लिए प्रत्यक्ष साक्ष्य उपलब्ध नहीं हैं।
पांचवां अनुच्छेद: प्रयोग से मिली प्रेरणा।
यदि उपयोगकर्ता को प्रायोगिक डिज़ाइन की आवश्यकता है, तो मार्कर, परख, समय बिंदु और नियंत्रण प्रदान करें।
5. लेख के अंत में संदर्भों की पूरी सूची दी गई है।
यदि पाठ में किसी विशिष्ट संदर्भ का उल्लेख किया गया है, तो लेख के अंत में उसकी पूरी सूची संलग्न की जानी चाहिए।
प्रारूप:
```मार्कडाउन
## संदर्भ जानकारी की संपूर्ण सूची
1. स्मिथ जे एट अल., **पत्रिका का नाम** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Qn}*
2. वांग एक्स एट अल., **पत्रिका का नाम** (2022), [डीओआई: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=सत्यापित किया जाना बाकी है}*
```
लेखक प्रारूप:
• 1-3 लेखक: सभी के नाम लिखें।
• तीन से अधिक लेखक: प्रथम लेखक आदि।
PMID / DOI / URL क्लिक करने योग्य होना चाहिए।
6. आईएफ सत्यापन और लेबलिंग
6.1 सबसे पहले, आइए IF जांच की व्यावहारिक सीमाओं को समझाते हैं।
सामान्यतः, आधिकारिक जर्नल इम्पैक्ट फैक्टर क्लैरिवेट जर्नल साइटेशन रिपोर्ट्स (जेसीआर) से प्राप्त होता है। हालांकि, आमतौर पर किसी भी बाहरी एजेंट के पास क्लैरिवेट/जेसीआर खाता या स्थानीय जेसीआर तालिका नहीं होती है, इसलिए इस माध्यम से इसकी पुष्टि न करें।
```
6.2 IF कौशल का उपयोग करने के व्यावहारिक तरीके
मुख्य मार्ग:
1. यदि इनपुट PMID है, तो सबसे पहले NCBI ई-यूटिलिटीज का उपयोग करके PubMed मेटाडेटा प्राप्त करें।
- जर्नल का पूरा नाम प्राप्त करें। - स्रोत/आईएसओ का संक्षिप्त नाम प्राप्त करें। - ISSN/eISSN प्राप्त करें। - शीर्षक, वर्ष और डीओआई जैसे सहायक फ़ील्ड प्राप्त करें।
2. पत्रिकाओं से जानकारी प्राप्त करने के लिए सार्वजनिक रूप से उपलब्ध iikx/iscience मोबाइल JSON इंटरफ़ेस का उपयोग करें।
खोज एपीआई:
```पाठ
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
विवरण एपीआई:
```पाठ
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
3. खोज परिणामों पर एक रूढ़िवादी मिलान करें।
- सटीक मानकीकृत जर्नल शीर्षक मिलान को प्राथमिकता देता है। - दूसरा, सटीक संक्षिप्ताक्षर मिलान को प्राथमिकता देता है। - संक्षिप्त और व्यापक शब्दों के साथ अत्यधिक सावधानी बरतता है। - स्पष्ट उप-स्ट्रिंग बेमेल को स्वीकार नहीं करता है, जैसे कि "नेचर" को "नेचर रिव्यूज़" श्रृंखला के रूप में बेमेल करना। - यदि मिलान अस्थिर है, तो अनुमान लगाने के बजाय अस्पष्ट/नहीं मिला परिणाम लौटाता है।
4. यदि PubMed कोई संक्षिप्त रूप प्रदान करता है, तो NLM कैटलॉग का उपयोग करके उसे पूर्ण नाम या वैकल्पिक शीर्षक में विस्तारित करने का प्रयास करें।
एनएलएम कैटलॉग खोज इंटरफ़ेस एनसीबीआई ई-यूटिलिटीज़ ही रहेगा:
```पाठ
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=[शीर्षक संक्षिप्त नाम]&retmode=xml&retmax=1
```
फिर टाइटल/टाइटल अल्टरनेट प्राप्त करने के लिए ESummary का उपयोग करें।
5. iikx के विस्तृत परिणामों को पढ़ें:
- इम्पैक्ट फैक्टर। - IF वर्ष। - JCR चतुर्थक। - CAS/CAS चतुर्थक, यदि लागू हो। - स्रोत URL। - मिलान की विश्वसनीयता।
6. टिप्पणी करते समय मुख्य पाठ में IF वर्ष को शामिल न करें; संक्षिप्त टिप्पणियों का उपयोग करें।
अंतिम टिप्पणी में केवल यही लिखा होना चाहिए:
```पाठ
*{IF=X,Qn}*
```
यदि यह विफल हो जाता है:
```पाठ
*{IF=सत्यापन लंबित है}*
```
या:
```पाठ
*{IF=पता नहीं चला}*
```
6.3 विशिष्ट चरण
प्रत्येक दस्तावेज़ के लिए निम्नलिखित प्रक्रिया का पालन करें।
चरण 1: जर्नल खोज नाम तैयार करें।
PubMed मेटाडेटा से जानकारी प्राप्त करने को प्राथमिकता दें:
```पाठ
पूर्णपत्रिकानाम
आईएसओ संक्षिप्त नाम / स्रोत
आईएसएसएन
ईईएसएसएन
```
यदि केवल DOI उपलब्ध है, तो सबसे पहले जर्नल का नाम प्राप्त करने के लिए Crossref या OpenAlex का उपयोग करें।
क्रॉसरेफ़:
```पाठ
https://api.crossref.org/works/
```
ओपनएलेक्स:
```पाठ
https://api.openalex.org/works/https://doi.org/
```
चरण 2: पत्रिकाओं के नामों को मानकीकृत करें।
मानकीकरण नियम:
• सभी अक्षर छोटे होने चाहिए।
• एचटीएमएल अनएस्केप।
• & को and से बदलें।
• विराम चिह्नों को हटा दें।
• कई रिक्त स्थानों को संयोजित करें।
• तुलना करते समय, आप संक्षिप्त रूप का भी उपयोग कर सकते हैं, जो सभी रिक्त स्थानों को हटा देता है।
उदाहरण स्यूडोकोड:
पायथन
re, html आयात करें
परिभाषा मानदंड(ओं):
s = html.unescape(s or '').lower()
s = re.sub(r'&', ' और ', s)
s = re.sub(r'[^a-z0-9]+', ' ', s)
return re.sub(r'\s+', ' ', s).strip()
def compact(s):
return norm(s).replace(' ', '')
```
चरण 3: iikx खोज इंटरफ़ेस से क्वेरी करें।
```पाठ
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
यूजर-एजेंट सेट करने की सलाह दी जाती है, उदाहरण के लिए:
```पाठ
मोज़िला/5.0
```
यदि पहले पृष्ठ पर कोई सटीक मिलान नहीं मिलता है, तो आप सीमित संख्या में पृष्ठों को पलट सकते हैं, उदाहरण के लिए, अधिकतम 8 पृष्ठ।
पृष्ठ पलटने के पैरामीटर आमतौर पर इस प्रकार होते हैं:
```पाठ
पृष्ठ=2
पृष्ठ=3
```
चरण 4: खोज परिणामों में से उम्मीदवारों का चयन करें।
उम्मीदवार के कार्यक्षेत्रों में आमतौर पर निम्नलिखित शामिल होते हैं:
```पाठ
पहचान
कक्षा आईडी
शीर्षक
छोटा शीर्षक
यदि या IF2024
zky2020
यूआरएल
```
मिलान के नियम:
• यदि कॉम्पैक्ट(क्वेरी) == कॉम्पैक्ट(उम्मीदवार.शीर्षक), स्वीकार करें।
• यदि norm(query) == norm(candidate.title), स्वीकार करें।
• यदि कॉम्पैक्ट (क्वेरी) == कॉम्पैक्ट (कैंडिडेट.स्मॉलटाइटल), स्वीकार करें।
• यदि norm(query) == norm(candidate.smalltitle), स्वीकार करें।
• जब तक क्वेरी पर्याप्त लंबी और स्पष्ट न हो, तब तक सबस्ट्रिंग स्वीकार न करें।
• प्रकृति, विज्ञान, कोशिका, मस्तिष्क, दृष्टि और रेटिना जैसे छोटे शब्दों के साथ विशेष रूप से सावधान रहें।
चरण 5: यदि कोई मिलान नहीं मिलता है, तो एनएलएम कैटलॉग के विस्तारित संक्षिप्त नाम का उपयोग करें।
उदाहरण के लिए, PubMed में, स्रोत इस प्रकार है:
```पाठ
फ्री रेडिक बायोल मेड
```
आप जांच कर सकते हैं:
```पाठ
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=Free%20Radic%20Biol%20Med%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1
```
एनएलएम कैटलॉग आईडी प्राप्त करने के बाद, इसका उपयोग निम्नानुसार करें:
```पाठ
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=nlmcatalog&id=
```
पढ़ना:
```पाठ
शीर्षक
शीर्षक वैकल्पिक
```
फिर इन पूरे नामों का उपयोग करके iikx को खोजें।
चरण 6: iikx विवरण इंटरफ़ेस की जाँच करें।
यदि खोज परिणामों में निम्नलिखित शामिल हैं:
```पाठ
आईडी=<आईडी>
क्लासआईडी=<क्लासआईडी>
```
पुकारना:
```पाठ
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
विस्तार से पढ़ें:
```पाठ
IF2024, IF2023, IF2022 ...
अगर
zky2020 या अन्य JCR चतुर्थक क्षेत्र
jcr22 / jcr12 या विभाजन फ़ील्ड
ISSN
ईआईएसएसएन
शीर्षक
छोटा शीर्षक
वर्ग
```
चरण 7: नवीनतम IF स्टेटमेंट का चयन करें।
लौटाए गए फ़ील्ड में इस फ़ॉर्म के सभी उदाहरणों को खोजें:
```पाठ
IF20xx
```
उदाहरण के लिए:
```पाठ
IF2024
IF2023
IF2022
```
सबसे बड़े सार्थक अंक वाले वर्ष का चयन करें।
यदि IF20xx मौजूद नहीं है, तो पढ़ने का प्रयास करें:
```पाठ
अगर
यदि_मान
```
यदि कोई मान्य मान नहीं मिलता है, तो उसे 'पता नहीं चला' के रूप में चिह्नित किया जाता है।
चरण 8: आत्मविश्वास स्तर और लेबल आउटपुट करें।
यदि सटीक शीर्षक/संक्षिप्त रूप मेल खाता है, और विवरण एक वैध IF लौटाता है:
```पाठ
*{IF=X,Qn}*
```
यदि मैच अनिश्चित है:
```पाठ
*{IF=सत्यापन लंबित है}*
```
यदि सार्वजनिक एपीआई कोई परिणाम नहीं देता है:
```पाठ
*{IF=पता नहीं चला}*
```
6.4 IF एनोटेशन प्रारूप
निश्चित प्रारूप:
```पाठ
*{IF=X,Qn}*
```
उदाहरण:
```मार्कडाउन
स्मिथ जे एट अल., **न्यूरॉन** (2020), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=15.0, Q1}*
```
सूचना:
• IF एनोटेशन के अंदर JCR वर्ष नहीं लिखा जाता है।
• "2024 JCR IF" न लिखें।
• "जेसीआर 2024" न लिखें।
• केवल प्रकाशन का वर्ष ही रखा जाता है।
• यदि IF का मान 0.0, शून्य, अस्थिर स्रोत या अस्थिर मिलान है, तो संख्या प्रदर्शित नहीं की जाएगी।
6.5 IF चेक विफलताओं के लिए मानक प्रबंधन
अनुमान मत लगाओ।
संख्याओं को भरने के लिए पत्रिका के नाम का उपयोग न करें।
IF स्टेटमेंट को याद करने और भरने के लिए बड़े मॉडलों का उपयोग न करें।
विफलता की स्थिति में केवल तीन ही स्थितियां स्वीकार्य हैं:
```पाठ
*{IF=सत्यापन लंबित है}*
```
के लिए इस्तेमाल होता है:
• खोज परिणाम अस्पष्ट हैं।
इसी तरह की कई पत्रिकाएँ मौजूद हैं।
• केवल संक्षिप्त नाम ही मिला, पूरा नाम सत्यापित नहीं हो सका।
• सार्वजनिक रूप से उपलब्ध स्रोतों द्वारा लौटाया गया IF संदिग्ध है।
```पाठ
*{IF=पता नहीं चला}*
```
के लिए इस्तेमाल होता है:
• सार्वजनिक इंटरफेस से कोई परिणाम प्राप्त नहीं हुआ।
• यह पत्रिका एससीआई/जेसीआर के अंतर्गत नहीं आती है।
• नए मुद्दे में अभी तक कोई IF शामिल नहीं है।
```पाठ
*{IF=सार्वजनिक रूप से सत्यापित नहीं किया जा सकता}*
```
के लिए इस्तेमाल होता है:
• उपयोगकर्ता को एक आधिकारिक जेसीआर की आवश्यकता है, लेकिन वर्तमान एजेंट के पास क्लेरिवेट/जेसीआर की अनुमतियाँ नहीं हैं।
7. अंतिम स्व-जांच सूची
शिपमेंट से पहले इसकी जांच अवश्य करें:
• क्या उपयोगकर्ता के मूल प्रश्नों का उत्तर पहले दिया जाना चाहिए?
• प्रत्यक्ष साक्ष्य, अप्रत्यक्ष साक्ष्य और प्रत्यक्ष साक्ष्य न मिलने के बीच अंतर करना है या नहीं।
• क्या सभी टेक्स्ट उद्धरण क्लिक करने योग्य हैं?
• क्या लेख के अंत में संदर्भों की पूरी सूची दी गई है?
• क्या प्रत्येक दस्तावेज़ में IF (इनपुट/आउटपुट) लेबल या लंबित सत्यापन/पता नहीं चलने का संकेत देने वाला लेबल शामिल है?
• क्या PMID/DOI/URL क्लिक करने योग्य है।
• क्या यह विशिष्ट कोशिका प्रकारों के बारे में निष्कर्ष निकालने के लिए समग्र ऊतक परिणामों को प्रतिस्थापित करने से बचता है?
• क्या यह कुल अभिव्यक्ति में वृद्धि के लिए सक्रियण/फॉस्फोरिलेशन को प्रतिस्थापित करने से बचता है?
• क्या इसे प्रीप्रिंट के रूप में इंगित करना है।
• क्या इसमें खोज की सीमाएं निर्दिष्ट हैं?
• यदि यह स्मृति या अनुमान पर आधारित नहीं था।
8. पुनरुत्पादनीय छद्म कोड
पायथन
क्वेरीज़ = बिल्ड_क्वेरीज़(यूज़र_प्रश्न)
सभी_पीएमआईडी = []
क्वेरी में मौजूद क्वेरी के लिए:
pmids = ncbi_esearch(query, retmax=20, sort='relevance')
all_pmids.extend(pmids)
pmids = deduplicate_keep_order(all_pmids)
मेटाडेटा = ncbi_esummary(pmids)
सार = ncbi_efetch_abstract(pmids)
रिकॉर्ड = मेटाडेटा और सार को मर्ज करें (मेटाडेटा, सार)
रिकॉर्ड = टैग_एविडेंस(रिकॉर्ड, उपयोगकर्ता_प्रश्न)
रिकॉर्ड = रैंक_रिकॉर्ड(रिकॉर्ड)
चयनित = शीर्ष रिकॉर्ड चुनें (रिकॉर्ड)
यदि आवश्यक हो तो पूर्ण पाठ:
चयनित कुंजी रिकॉर्ड में प्रत्येक रिकॉर्ड के लिए:
pmcid = idconv_pmid_to_pmcid(record.pmid)
यदि pmcid:
रिकॉर्ड.पूर्णपाठ = फ़ेच_बायोक_या_पीएमएमसी_एक्सएमएल(पीएमसीआईडी)
चयनित रिकॉर्ड के लिए:
journal_query = record.full_journal_name or record.journal_abbrev
if_result = lookup_if_public_iikx(journal_query)
यदि_परिणाम.आत्मविश्वास:
रिकॉर्ड.if_annotation = f'*{IF={if_result.if_value},{if_result.quartile}}*'
elif if_result.ambiguous:
record.if_annotation = '*{IF=Pending Verification}*'
अन्य:
record.if_annotation = '*{IF=पता नहीं चला}*'
उत्तर = उत्तर लिखें (
निष्कर्ष
साक्ष्य_समूह,
क्लिक करने योग्य_मुख्य भाग_उद्धरण,
full_reference_list_with_if
)
```
9. अनुशंसित अंतिम वितरण टेम्पलेट
```मार्कडाउन
निष्कर्ष के तौर पर:
...
साक्ष्य का स्तर:
प्रत्यक्ष प्रमाण:
- ……[[1. **पत्रिका**, वर्ष]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
अप्रत्यक्ष साक्ष्य:
- …[[2. **पत्रिका**, वर्ष]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
कोई प्रत्यक्ष प्रमाण नहीं मिला:
- ……
क्रियाविधि का सारांश:
1. ……
2. ……
खोज की सीमाएँ:
इस चरण की खोज में मुख्य रूप से PubMed, PMC, BioC और bioRxiv का उपयोग किया गया; प्रारंभिक जांच मेटाडेटा और सारांश के आधार पर की गई, और केवल महत्वपूर्ण दस्तावेजों का ही पूर्ण पाठ सत्यापन किया गया। IF एनोटेशन सार्वजनिक रूप से उपलब्ध स्रोतों पर आधारित थे; जिन दस्तावेजों का उच्च स्तर पर मिलान नहीं हो सका, उन्हें सत्यापन के लिए लंबित या अनुपलब्ध के रूप में चिह्नित किया गया।
साहित्य संबंधी जानकारी की संपूर्ण सूची:
1. स्मिथ जे एट अल., **पत्रिका का नाम** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Q1}*
2. वांग एक्स एट अल., **पत्रिका का नाम** (2022), [डीओआई: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=सत्यापित किया जाना बाकी है}*
```
संबंधित कौशल
सभी देखें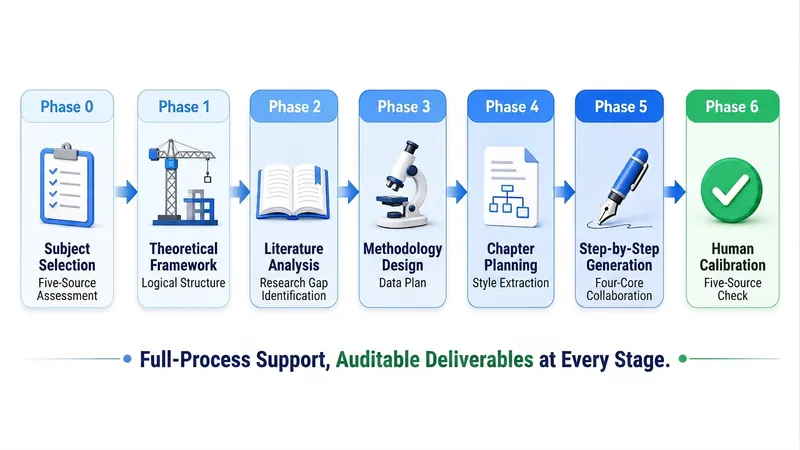
पाँच-स्रोत तैयारी परीक्षक
अपने शोध पत्र पर दर्जनों घंटे बिताने से पहले, दस मिनट निकालकर एक संरचित जाँच करें। 【यह स्किल केवल एक काम करती है】 निदान, लिखना नहीं। यह आपको बताता है: विषय टिकाऊ है या नहीं, सामग्री पर्याप्त है या नहीं, क्या कमी है, कहाँ पूरी करनी है, किस क्रम में पूरी करनी है, और फिर आपको एक कार्यान्वयन योग्य पूरक सूची और खोज क्वेरी देता है। यह आपके लिए परिचय, समीक्षा, विधि या चर्चा नहीं लिखेगा। 【चार चरण】 1. विषय निदान: 1A मानविकी और कला / 1B सामाजिक विज्ञान / 2A विज्ञान और इंजीनियरिंग / 2B कृषि, चिकित्सा और जीवन विज्ञान — इन चार श्रेणियों में वर्गीकृत करें, संबंधित नियमात्मक सीमाएँ लोड करें; 2B श्रेणी में नैतिक समीक्षा अनिवार्य रूप से रोकी जाएगी। 2. विषय जाँच: तीन आयामों 'शक्ति·रूप·शब्द' से विषय की जाँच करें, यह निर्धारित करें कि शोध इकाई को परिचालित किया जा सकता है या नहीं, शोध प्रश्न का उत्तर दिया जा सकता है या नहीं, और क्या विषय पहले से ही अत्यधिक उपयोग किया जा चुका है। 3. सामग्री जाँच: अपने पास मौजूद साहित्य को M1/M2… सामग्री पुस्तकालय में दर्ज करें, प्रत्येक आइटम के चार तत्वों (लेखक/वर्ष/शीर्षक/सत्यापन योग्य लोकेटर) की जाँच करें, और वास्तविक कवरेज दर की गणना करें। 4. अंतर सूची और खोज क्वेरी: स्पष्ट करें कि कितने और किस प्रकार के साहित्य की कमी है, कौन सा साक्ष्य लिंक गायब है, और एक खोज क्वेरी प्रदान करें जिसे सीधे डेटाबेस में चिपकाया जा सकता है (कीवर्ड बूलियन संयोजन, समय सीमा, फ़िल्टर मानदंड सहित)। 【इसका उपयोग कब करें】(ट्रिगर शब्द) 「मेरे प्रस्ताव की जाँच करो」「क्या यह विषय किया जा सकता है」「क्या मेरी साहित्य पर्याप्त है」「प्रस्ताव रिपोर्ट वापस आ गई है」「लिखने से पहले पुष्टि करना चाहता हूँ」— जिन्होंने अभी दिशा तय की है और लिखना शुरू नहीं किया है; जिनकी प्रस्ताव रिपोर्ट वापस आ गई है पर समस्या नहीं पता; जिनके पास बहुत सारा साहित्य है पर निश्चित नहीं कि शुरू करने के लिए पर्याप्त है; जो वास्तविक निवेश से पहले यह पुष्टि करना चाहते हैं कि विषय इसके लायक है। 【डिलिवरेबल्स】 एक 'प्रस्ताव जाँच रिपोर्ट' दस्तावेज़ + पाँच-स्रोत तैयारी स्कोरकार्ड (प्रत्येक स्तर में व्यवहारिक मानदंड हैं, न कि अस्पष्ट स्कोरिंग) + पूरक सामग्री प्राथमिकता सूची + खोज क्वेरी + एक संग्रह कोड। संग्रह कोड '学术论文全流程撰写系统 v4.0' के साथ संगत है, जाँच पूरी होने के बाद इसे सीधे चिपकाकर लेखन जारी रख सकते हैं, बिना विषय, विषयवस्तु, या पत्रिका को फिर से बताए। 【स्पष्ट रूप से नहीं करता】 मुख्य पाठ नहीं लिखता, संदर्भ सूची उत्पन्न नहीं करता, लेखक, वर्ष, खंड, अंक, पृष्ठ, या DOI का आविष्कार नहीं करता। ऑनलाइन खोजे गए सभी साहित्य को ⚠️ सत्यापन के लिए चिह्नित किया जाएगा, और आपको उपयोग से पहले स्वयं सत्यापित करना होगा। यह स्किल किसी स्वीकृति या पास होने के परिणाम की गारंटी नहीं देती।
 अनुसंधान
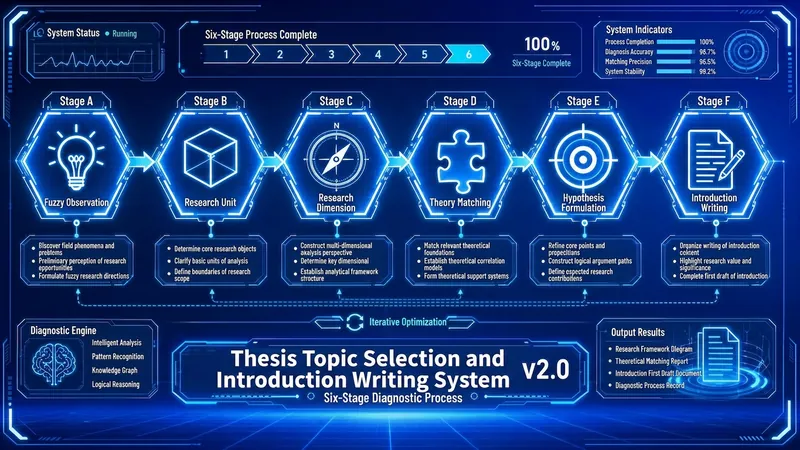
शोध विषय व परिचय लेखन v3.2
10 सेकंड में समझें: एक अस्पष्ट अवलोकन को एक ठोस विषय में बदलें, फिर एक स्वीकार्य परिचय में। पूरी प्रक्रिया में केवल आपके द्वारा प्रदान की गई वास्तविक सामग्री का उपयोग करें, कोई काल्पनिक साहित्य नहीं। ट्रिगर शब्द: शोध विषय, विषय चयन, परिचय, शोध अंतराल, अकादमिक लेखन, स्नातक थीसिस शुरुआत, साहित्य समीक्षा से पहले विषय चयन। लागू: जर्नल पेपर / डिग्री थीसिस / सम्मेलन पेपर / पाठ्यक्रम पेपर, मानविकी, सामाजिक विज्ञान, विज्ञान, इंजीनियरिंग, कृषि, चिकित्सा सभी विषय। 3 मिनट में शुरू करें: पहले विषय और शुरुआत तय करें → परत-दर-परत विषय तैयार करें → साक्ष्य श्रृंखला हार्ड गेट → मॉड्यूल परिचय → रैचेट अंतिम रूप। 【अन्य कौशलों से विभाजन】परीक्षा पहले, लेखन बाद में, पॉलिश अंत में। यह कौशल मध्य भाग के लिए जिम्मेदार है: विषय निर्माण + परिचय मसौदा। यह पूर्ण पाठ प्रक्रिया नहीं करता (वह 《学术论文全流程撰写系统 v4.x》 है), न ही वाक्य-दर-वाक्य भाषा पॉलिशिंग (वह 《学术论文三轨润色系统 v8.x》 है)। 【छह द्वार】1. विषय वर्गीकरण: 1A मानविकी/कला, 1B सामाजिक विज्ञान, 2A विज्ञान/इंजीनियरिंग, 2B कृषि/चिकित्सा/जीवन - चार श्रेणियों में वर्गीकरण, संबंधित नियामक रेखाएँ लागू करें; 2B के लिए नैतिक समीक्षा स्थिति पूछना अनिवार्य है। 2. चरण पहचान: क्या आप अस्पष्ट अवलोकन में हैं, इकाई है लेकिन दृष्टिकोण नहीं, वस्तु है लेकिन सिद्धांत नहीं, विधि नहीं, दृष्टिकोण नहीं, या केवल परिचय की कमी है—संबंधित द्वार से शुरू करें, शुरुआत से दोबारा नहीं। 3. विषय निर्माण: शोध इकाई → आयाम कम्पास → सैद्धांतिक परिप्रेक्ष्य → शोध विधि → शोध दृष्टिकोण, परत-दर-परत लॉक करें, प्रत्येक परत लॉक करने से पहले पिछली परत की स्थिरता जाँचें। 4. साक्ष्य श्रृंखला हार्ड गेट: परिचय से पहले अपने साहित्य को M1/M2… सामग्री पुस्तकालय में अनिवार्य रूप से पंजीकृत करें, प्रत्येक प्रविष्टि की चार तत्वों - लेखक/वर्ष/शीर्षक/लोकेटर - की जाँच करें; यदि 3 से कम संवाद प्रविष्टियाँ हैं, तो सिस्टम शोध अंतराल कथन उत्पन्न करने से इनकार करता है — डाउनग्रेड नहीं, बल्कि अस्वीकृति। 5. मॉड्यूल-वार उत्पादन: परिचय उल्टे पिरामिड के पाँच मॉड्यूल में तैयार होता है, प्रत्येक मॉड्यूल में उद्धरण संख्या [Mn] अनिवार्य रूप से अंकित होती है, बिना स्रोत के कोई वाक्य नहीं। 6. रैचेट अंतिम रूप: केवल पारित संस्करण पर अंक जोड़ें, प्राप्त मॉड्यूल लॉक करें और बदलें नहीं, स्कोर केवल बढ़ता है। 【डिलीवरेबल】《[शोध कीवर्ड]·विषय और परिचय》दस्तावेज़ + वाक्य-दर-वाक्य ट्रेस करने योग्य उद्धरण मानचित्र तालिका + ⚠️सत्यापन सूची + एक AFP संग्रह कोड। संग्रह कोड 开题体检器, v4.x पूर्ण प्रक्रिया, और त्रि-ट्रैक पॉलिशिंग प्रणाली के साथ चारों ओर संगत है, कौशल बदलने पर विषय, शोध विषय, पत्रिका, सामग्री पुस्तकालय को फिर से बताने की आवश्यकता नहीं। 【स्पष्ट रूप से नहीं करता】लेखक, वर्ष, खंड, पृष्ठ, DOI का आविष्कार नहीं करता; ऑनलाइन खोजे गए ग्रंथसूची रिकॉर्ड को ⚠️सत्यापन की आवश्यकता के रूप में चिह्नित करता है, आपके सत्यापन के बाद ही संदर्भ सूची में लिखा जा सकता है; किसी भी स्वीकृति या पारित परिणाम का वादा नहीं करता। लेखकत्व और जिम्मेदारी आपकी है—कृपया प्रत्येक उद्धरण और डेटा की जाँच करें।
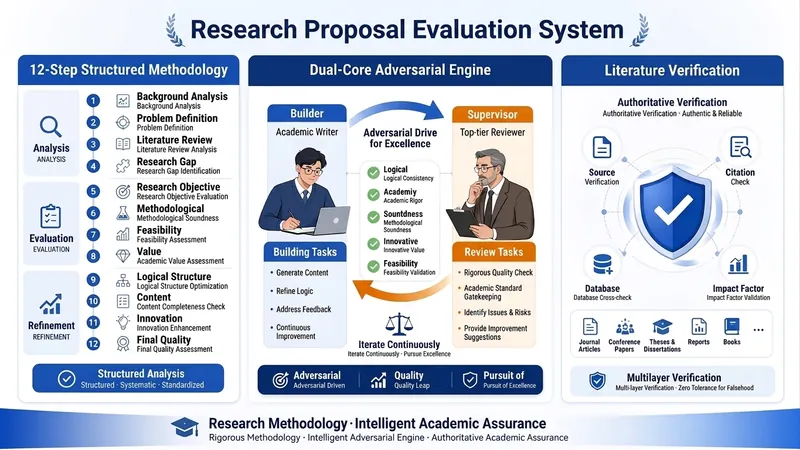
प्रोजेक्ट प्रपोज़ल क्रिएशन, रिव्यू और पॉलिशिंग PRO V2.0
🎯 मुख्य कार्य अवलोकन: यह एक बुद्धिमान समीक्षा और अनुकूलन प्रणाली है जिसे विशेष रूप से राष्ट्रीय सामाजिक विज्ञान, शिक्षा मंत्रालय और प्रांतीय स्तर की अनुसंधान परियोजनाओं के लिए डिज़ाइन किया गया है। यह 15 वर्षों के अनुभव वाले एक वरिष्ठ समीक्षा विशेषज्ञ के सोचने के तरीके का अनुकरण करती है और तीन मुख्य तंत्रों के माध्यम से अनुप्रयोगों की अकादमिक कठोरता और प्रतिस्पर्धात्मकता सुनिश्चित करती है। 🔧 तीन मुख्य तंत्र 1️⃣ एक 12-चरणीय संरचित कार्यप्रणाली अनुसंधान प्रस्ताव समीक्षा के संपूर्ण जीवनचक्र को पूर्णतः कवर करती है: चरण 1-3: बुनियादी निदान - घोषणाओं का गहन विश्लेषण (वित्तपोषण दिशानिर्देश, समीक्षा मानक, आवेदन आवश्यकताएँ) - अंतःविषयक प्रकार का निर्णय (8 प्रकारों की सटीक पहचान) - अनुसंधान अंतर की पाँच-आयामी पहचान (सिद्धांत/कार्यप्रणाली/अनुभवजन्य/नीति/प्रौद्योगिकी) चरण 4-7: मुख्य तत्व समीक्षा - अनुसंधान प्रश्नों का TMAQ मॉडल विश्लेषण (सिद्धांत/कार्यप्रणाली/विचार/समस्याओं के चार आयाम) - अनुसंधान उद्देश्यों का SMART सिद्धांत सत्यापन - अनुसंधान सामग्री ढाँचे का पूर्णता मूल्यांकन - अनुसंधान विचारों का मिलान (6 प्रकार) चरण 8-10: गहन गुणवत्ता सुधार - प्रमुख कठिनाइयों का सटीक निष्कर्षण (विभेद मानदंड + सफलता पथ) - नवाचार बिंदुओं का 7-आयामी अन्वेषण - 7-आयामी व्यवहार्यता प्रदर्शन चरण 11-12: समग्र अनुकूलन - 9-आयामी गुणवत्ता पहचान (शैक्षणिक कठोरता, नवाचार, व्यवहार्यता, आदि) - व्यापक अनुकूलन सुझाव और अंतिम रिपोर्ट 2️⃣ दोहरी-कोर टकराव तंत्र (निर्माता बनाम पर्यवेक्षक) कार्य सिद्धांत: - निर्माता (अकादमिक लेखक): उपयोगकर्ता सामग्री के आधार पर अनुकूलित समाधान उत्पन्न करता है - पर्यवेक्षक (शीर्ष जर्नल समीक्षक): सबसे कठोर मानकों के साथ निर्माता के समाधानों को चुनौती देता है - पुनरावृत्ति चुनौतियाँ: यह सुनिश्चित करता है कि समाधान चुनौतियों के 3 दौरों के माध्यम से जांच में खरे उतरें। अनुप्रयोग परिदृश्य: - नवाचार बिंदु खोज: निर्माता नवाचार बिंदुओं का प्रस्ताव करता है → पर्यवेक्षक उनकी नवीनता पर प्रश्न उठाता है → पुनरावृत्ति अनुकूलन - व्यवहार्यता प्रदर्शन: निर्माता समाधान डिजाइन करता है → पर्यवेक्षक उनकी व्यवहार्यता को चुनौती देता है → पूरक प्रदर्शन - साहित्य उद्धरण: निर्माता साहित्य का उद्धरण देता है → पर्यवेक्षक प्रामाणिकता सत्यापित करता है → अकादमिक अखंडता सुनिश्चित करता है 3️⃣ साहित्य प्रामाणिकता सत्यापन तंत्र दो कार्य मोड: मोड A: प्लेसहोल्डर मोड (डिफ़ॉल्ट) - विशिष्ट साहित्य को बदलने के लिए [साहित्य प्लेसहोल्डर-001] जैसे मार्करों का उपयोग करता है - प्रत्येक प्लेसहोल्डर के लिए खोज आवश्यकताओं को स्पष्ट करते हुए एक "साहित्य आवश्यकता सूची" आउटपुट करता है - उपयोगकर्ता अपनी खोज के बाद वास्तविक साहित्य भरते हैं मोड B: रीयल-टाइम सत्यापन मोड - वास्तविक समय में साहित्य की प्रामाणिकता को सत्यापित करने के लिए Google स्कॉलर को कॉल करता है - एक "साहित्य सत्यापन रिपोर्ट" (प्रामाणिकता/प्रासंगिकता/प्रामाणिकता स्कोर) उत्पन्न करता है - सुनिश्चित करता है कि प्रत्येक उद्धरण का पता लगाया जा सके एआई भ्रमों को रोकता है: - मनगढ़ंत लेखकों, पत्रिकाओं और अनुसंधान सूचना प्राधिकरणों (डीओआई) को प्रतिबंधित करता है - सभी साहित्य का सत्यापन किया जाना चाहिए या उन्हें प्लेसहोल्डर के रूप में चिह्नित किया जाना चाहिए - अकादमिक अखंडता की गारंटी देता है 💡 मुख्य मूल्य और लागू परिदृश्य ✅ हल की गई प्रमुख समस्याएं 1. अकादमिक कठोरता का अभाव: एआई-जनित सामग्री में अक्सर नकली साहित्य और तार्किक खामियां होती हैं 2. अपर्याप्त नवाचार: वास्तविक अकादमिक नवाचार बिंदुओं को उजागर करने में कठिनाई 3. कमजोर व्यवहार्यता: अनुसंधान योजनाओं में व्यवस्थित तर्क का अभाव 4. अंतःविषयक अनुसंधान में कठिनाई: अंतःविषयक विषय अक्सर "न इधर, न उधर" वाली स्थिति में होते हैं 🎓 लागू उपयोगकर्ता - विश्वविद्यालय के शिक्षक (सामाजिक विज्ञान, शिक्षा, मानविकी) - शोधकर्ता (राष्ट्रीय और प्रांतीय स्तर की परियोजनाओं के लिए आवेदन करने वाले) - अकादमिक टीमें (एक व्यवस्थित समीक्षा प्रक्रिया की आवश्यकता वाली) 📋 विशिष्ट उपयोग प्रक्रिया 1. इनपुट: परियोजना घोषणा + आवेदन का मसौदा अपलोड करें 2. समीक्षा: सिस्टम 12-चरणों वाली संरचित समीक्षा करता है विश्लेषण 3. प्रतिउपाय: दोहरे कोर तंत्र द्वारा प्रमुख भागों का पुनरावर्ती अनुकूलन 4. सत्यापन: साहित्य की प्रामाणिकता की जाँच 5. परिणाम: संपूर्ण समीक्षा रिपोर्ट + अनुकूलन सुझाव + साहित्य सूची 🔍 पारंपरिक समीक्षा से अंतर | आयाम | पारंपरिक मैनुअल समीक्षा | विशेषज्ञ समीक्षा प्रणाली | |------|------------|---------| | समीक्षा की गहराई | व्यक्तिगत अनुभव पर निर्भरता | 12-चरणीय संरचित समीक्षा + 9-आयामी गुणवत्ता निरीक्षण | | अकादमिक कठोरता | पूरी तरह से सत्यापित करना कठिन | साहित्य सत्यापन + दोहरे कोर प्रतिउपाय | | नवाचार खनन | व्यक्तिपरक निर्णय | 7-आयामी प्रणाली विश्लेषण | | व्यवहार्यता प्रदर्शन | अनुभव-आधारित | 7-आयामी आइटम-दर-आइटम प्रदर्शन | | संगति | वैयक्तिकृत | मानकीकृत प्रक्रिया | | दक्षता | कई दिन से कई सप्ताह | प्रारंभिक समीक्षा 1-2 घंटे में पूरी | इस प्रणाली का मुख्य लाभ यह है कि यह 15 वर्षों के वरिष्ठ समीक्षा विशेषज्ञों के अंतर्निहित ज्ञान को स्पष्ट, संरचित और प्रतिलिपि योग्य बनाती है, जिससे प्रत्येक उपयोगकर्ता को उच्च स्तरीय विशेषज्ञ समीक्षा सेवाएं प्राप्त करने की सुविधा मिलती है।
जानकारी
- संस्करण
- v5
- आखिरी अपडेट
- रन क्रेडिट
- उपयोग के अनुसार
- मॉडल
- Claude Sonnet 4.5
- क्षमताएँ
- वेब शोध