साक्षात्कार ऑडियो ट्रांसक्रिप्शन
समय और वक्ता प्रबंधन के साथ ट्रांसक्रिप्ट करें
साक्षात्कार ऑडियो ट्रांसक्रिप्शन
समय और वक्ता प्रबंधन के साथ ट्रांसक्रिप्ट करें
सामग्री की झलक
विवरण
यह उन लोगों के लिए उपयुक्त है जिन्हें अधिकृत साक्षात्कारों, मीटिंगों या कक्षा की रिकॉर्डिंग को व्यवस्थित करने की आवश्यकता है। मूल फ़ाइल, भाषा, उद्देश्य, मौजूदा verbatim या विश्वसनीय वक्ता समय मानचित्रण प्रदान करें; यह केवल आवाज के आधार पर पहचान की पुष्टि नहीं कर सकता है, और न ही स्क्रिप्ट को वास्तविक सुनी गई सामग्री के रूप में मान सकता है। मूल ध्वनि और हैश रखें -> अवधि/ट्रैक पढ़ें -> वास्तविक ASR -> वास्तविक समय क्रम के अनुसार व्यवस्थित करें -> आधार होने पर अज्ञात वक्ताओं को लेबल करें -> संख्याओं/अस्वीकरणों/नामों और संदेहों को सुनने के लिए मूल ध्वनि की जाँच करें -> TXT, JSON, SRT और कवर विवरण वितरित करें। मशीन का पहला ड्राफ्ट, सुनने और प्रूफरीडिंग तथा सारांश अलग-अलग हैं; स्पष्ट रूप से न सुने जाने वाले को समीक्षाधीन रखा जाता है, और प्रवाह के लिए शब्दों को जोड़ा नहीं जाता है। ऑडियो/ASR टूल के बिना स्पष्ट रूप से अनट्रांसक्रिप्टेड छोड़ दिया जाता है। निर्देश और पैकेज में पूर्ण मूल स्थानीय सहायक शामिल हैं: Python3, FFmpeg/FFprobe, faster-whisper और पूर्व-कॉन्फ़िगर small कैश, CPU/int8, local_files_only, स्वचालित रूप से वेट डाउनलोड नहीं करता है। विश्वसनीय speaker-map जब शुरुआत और समाप्ति तथा अज्ञात लेबल देता है तो विंडो के अनुसार वास्तविक ट्रांसक्रिप्शन करता है और समय मैप करता है; मानचित्रण न होने पर समय अज्ञात होता है। सहायक कोई स्वचालित वक्ता डायराइजेशन या पहचान नहीं करता है, पैकेज में वेट/खाता/कुंजी शामिल नहीं हैं। चार मामले स्व-निर्मित चीनी व्यक्तिगत आख्यान, चीनी दो-व्यक्ति साक्षात्कार, अंग्रेजी कक्षा विवरण और चीनी दो-व्यक्ति मीटिंग के लिए हैं, कुल मूल ध्वनि लगभग 40.875 सेकंड है। अंतिम मूल ध्वनि Apache-2.0 मॉडल कार्ड द्वारा चिह्नित Kokoro-82M निश्चित संस्करण का उपयोग करके स्थानीय रूप से संश्लेषित की जाती है, zf_xiaobei, zm_yunjian, af_heart, यह वास्तविक व्यक्ति या वॉयस क्लोनिंग नहीं है; मॉडल, आवाज या केस ऑडियो इंस्टॉलेशन पैकेज के साथ वितरित नहीं किए जाते हैं। चारों वास्तविक ASR TXT/JSON/SRT जनरेट करते हैं, वक्ता प्रदान किए गए सिंथेटिक बोलने के समय से हैं, स्वचालित वक्ता डायराइजेशन से नहीं। वर्तमान में यह अभी भी मशीन का पहला ड्राफ्ट है; दूसरे मामले का ASR आउटपुट और स्क्रिप्ट का पहला ड्राफ्ट अंतर सुनने की पुष्टि के लिए प्रतीक्षित है, और इसे बिना अनुमति के बोले गए वास्तविक शब्दों में नहीं बदला गया है। वेवफॉर्म वास्तविक इनपुट PCM पीक से हैं, न कि सजावटी ध्वनि तरंगें। पाठ संगठन के लिए GPT की सिफारिश की जाती है, ASR वास्तविक टूल पर आधारित है; स्थानीय स्तर पर OpenAI ट्रांसक्रिप्शन API को कॉल नहीं किया गया है और न ही अपस्ट्रीम CLI चलाया गया है। स्वतंत्र अवतार ImageGen वैचारिक दृश्य है, टूल ने मॉडल नहीं लौटाया है, Image2 का दावा नहीं करता है। YouMind साइड टूल, कैश, फ़ाइल डाउनलोड और मॉडल बाइंडिंग ने पॉइंट परीक्षण का उपभोग नहीं किया है; वास्तविक वातावरण के अनुसार पुष्टि करने की आवश्यकता है। ट्रांसक्रिप्शन और वक्ता संगठन स्थापना के बाद बिना निर्भरता के चलने की गारंटी नहीं देते हैं। 299 पॉइंट इंस्टॉलेशन मूल्य है, जिसमें मॉडल/API या तृतीय-पक्ष सेवाएँ शामिल नहीं हैं, यह स्वचालित रूप से खरीद नहीं करता है, और अज्ञात ऑडियो ट्रैक को अतिरिक्त सेवाओं पर चुपचाप अपलोड नहीं करता है। शून्य typos, किसी भी लहजे/शोर/मल्टी-पर्सन ओवरलैप की पूर्ण पहचान, न्यायिक/पहचान सत्यापन, समय दक्षता या व्यावसायिक प्रभाव का कोई वादा नहीं किया जाता है। स्वतंत्र सुनने और प्रूफरीडिंग को पूरक किया जाना है, verbatim सत्यापित करने का प्रचार नहीं किया जाता है।
द्वारा अनुशंसित
Dancang
हमें यह कौशल क्यों पसंद है
यह स्किल चुनी गई है क्योंकि यह मशीन ट्रांसक्रिप्शन को अंतिम नहीं मानती: यह मूल साक्ष्य, समय सीमा और संशोधन आधार को सुरक्षित रखती है।
किनके लिए उपयोगी
अधिकृत साक्षात्कारों, बैठकों, कक्षाओं या ऑडियो रिकॉर्डिंग्स को व्यवस्थित करने और ट्रांसक्रिप्शन आधार बनाए रखने के लिए उपयुक्त।
इस Skill का उपयोग कैसे करें
अपना इनपुट दें
अधिकृत साक्षात्कार, बैठक, कक्षा या ऑडियो/वीडियो, भाषा, उपयोग और प्रसंस्करण दायरा प्रदान करें; आप सत्यापित वक्ता समय मानचित्रण भी दे सकते हैं।
Skill चलाएँ
वास्तविक ऑडियो ट्रांसक्राइब करें और वास्तविक टाइमस्टैम्प व्यवस्थित करें; दिए गए मानचित्रण के आधार पर अज्ञात वक्ताओं को चिह्नित करें, मशीन का पहला ड्राफ्ट रखें।
परिणाम देखें
टाइमस्टैम्प और स्रोत विवरण के साथ TXT, JSON, SRT ट्रांसक्रिप्शन फ़ाइलें प्राप्त करें, साथ ही प्रसंस्करण दायरा और अनिश्चित सामग्री भी शामिल हो।
संबंधित कौशल
सभी देखें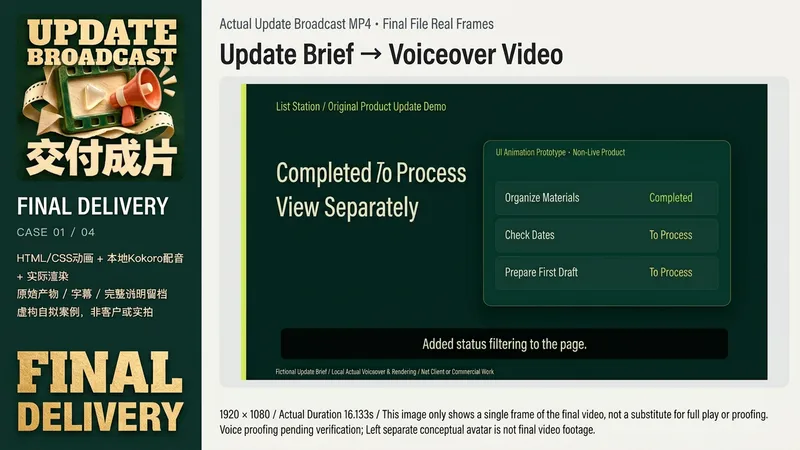 वीडियो
उत्पाद अपडेट प्रसारण | स्क्रिप्ट, वॉयसओवर और MP4
उत्पाद परिवर्तनों को समझाने वाले रचनाकारों, छोटी टीमों और शिक्षकों के लिए उपयुक्त। वास्तविक अपडेट सूची, पूर्ण/योजनाबद्ध स्थिति, अधिकृत स्क्रीनशॉट या प्रोटोटाइप, लक्षित दर्शक, आस्पेक्ट रेशियो और मूल ऑडियो प्रदान करता है; गायब तिथियों, प्रभावों और ग्राहक डेटा को मनगढ़ंत नहीं बनाया जाता है। केवल विचार होने पर स्पष्ट रूप से चिह्नित काल्पनिक उत्पाद डेमो बनाए जा सकते हैं। ब्रीफिंग इनपुट → तथ्यों और अनुमति की जाँच → संक्षिप्त स्क्रिप्ट और शॉट्स → वास्तविक वॉयसओवर/मूल ऑडियो प्राप्त करना → वास्तविक ऑडियो के अनुसार उपशीर्षक और विजुअल व्यवस्थित करना → वास्तविक रेंडरिंग → प्लेबैक, विजुअल और ऑडियो जाँच → MP4, SRT, स्क्रिप्ट और वास्तविक रूप से जनरेटेड सोर्स प्रोजेक्ट डिलीवर करना। वास्तविक इंटरफेस केवल मूल प्रतियों को व्यवस्थित करते हैं, रीरेंडर करने के लिए इमेज जनरेशन को नहीं सौंपते हैं। रेंडरिंग टूल न होने पर स्पष्ट रूप से उल्लेख किया जाता है कि वीडियो नहीं बना है। स्थानीय चार उदाहरण मूल काल्पनिक उत्पाद हैं: सूची फ़िल्टरिंग, कैलेंडर पूर्वावलोकन, निर्यात से पहले जाँच, और पाठ्यक्रम प्रगति। वास्तविक Kokoro-82M निश्चित संस्करण, zf_xiaobei ध्वनि स्थानीय सिंथेसिस, HyperFrames 0.8.174 और Chrome/FFmpeg वास्तविक रूप से दो 1920×1080, एक 1080×1080, और एक 1080×1920 वीडियो आउटपुट करते हैं, जिनकी अवधि लगभग 16.1—18.5 सेकंड है; उपशीर्षक वाक्य-खंड ऑडियो के वास्तविक नमूना समय के अनुसार व्यवस्थित होते हैं, और शब्द-दर-शब्द जबरन संरेखित होने का दावा नहीं करते हैं। ये वास्तविक लॉन्च किए गए सॉफ़्टवेयर, ग्राहक या सीखने के परिणाम नहीं हैं। टेक्स्ट प्लानिंग के लिए GPT अनुशंसित है। मुख्य रूप से वास्तविक फ़ाइलों, एनिमेशन/वीडियो रेंडरिंग, FFmpeg/FFprobe और उपलब्ध वैध मूल ऑडियो/TTS की आवश्यकता होती है। निर्देश में पूर्ण मूल स्थानीय रेंडरिंग सहायक शामिल है, जो केवल मौजूदा HyperFrames प्रोजेक्ट की जाँच/रेंडर करता है; यह स्वचालित रूप से UI या वॉयसओवर जनरेट नहीं करता है। आपको वास्तविक Node, HyperFrames CLI और ब्राउज़र पथ कॉन्फ़िगर करने होंगे। छवि टूल केवल वैकल्पिक मूल सहायक के रूप में उपयोग किए जाते हैं; स्वतंत्र अवतार ImageGen द्वारा जनरेट किए जाते हैं, मॉडल वापस नहीं किया जाता है, और यह केस फ़्रेम नहीं है। प्लेटफ़ॉर्म GPT-6.1 Sol केवल एक वैकल्पिक सेटिंग है, और यह स्थानीय टूल या मॉडल के समान होने की गारंटी नहीं देता है। YouMind साइड पर बिना पॉइंट खर्च किए परीक्षण किया गया है, और यह गारंटी नहीं है कि इंस्टॉल करने के बाद ये टूल सीधे उपलब्ध होंगे। 299 पॉइंट केवल इंस्टॉलेशन मूल्य हैं, और इसमें मॉडल, TTS, फ़ॉन्ट, सामग्री, तृतीय-पक्ष सेवाएँ या होस्टिंग शामिल नहीं हैं। यह स्वचालित रूप से आवाज़ क्लोन नहीं करता है, सेवाएँ नहीं खरीदता है या अन्य चैनलों पर सार्वजनिक नहीं करता है; यह किसी भी इनपुट, शून्य त्रुटियों, प्रसार, समीक्षा या व्यावसायिक परिणामों की गारंटी नहीं देता है। वर्तमान स्थानीय केस का वास्तविक रूप से रेंडर और प्लेबैक किया गया है, स्वतंत्र ट्रैक ऑडियो जाँच अभी बाकी है; इसे पूर्ण गुणवत्ता स्वीकृति के रूप में नहीं माना जाएगा।
 लिखें
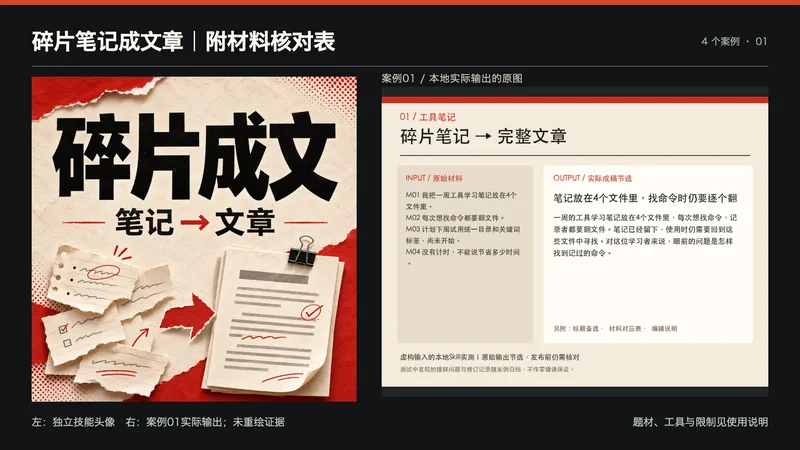
नोट्स से लेख और जाँच सूची
适用人群:已有零散笔记、采访文字或口述转写,希望整理成文章的创作者。 你需要提供:原始材料、目标读者、用途、篇幅和希望保留的表达。 如何处理:给材料编号,区分事实陈述、观点与计划;围绕一条主线成稿,再回查数字、说话人和证据缺口。 最终交付:3个标题备选、完整中文正文、材料对应表、待确认与编辑说明。默认直接输出可复制文字,文件保存取决于运行环境。 使用步骤:粘贴材料并说明读者与字数;运行后先阅读文章,再按对应表核对材料,修订后使用。核心功能仅需文字模型,推荐GPT;当前YouMind实测选择GPT-6.1 Sol,实际效果取决于运行配置。 四张展示图为虚构输入的本地Skill真实测试输出节选,经排版呈现,不是真实客户案例;测试发现的措辞问题已归档,文章仍需人工核对。平台已完成1个文字案例实测,不代表所有场景稳定成功。 不适用:凭空生成真实采访、未经提供的个人经历、替代事实核查或自动发布。材料不足会缩短内容并列出缺口,不以扩写补造事实。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
 वेबपेज
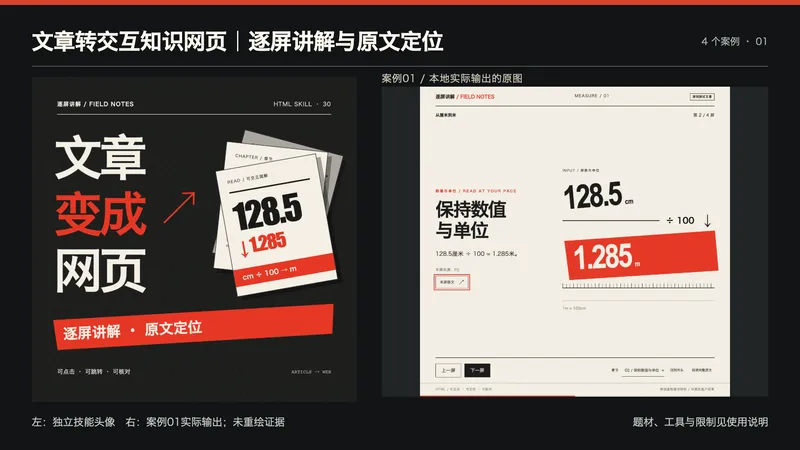
文章转交互知识网页|逐屏讲解与原文定位
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
जानकारी
- संस्करण
- v2
- आखिरी अपडेट
- रन क्रेडिट
- उपयोग के अनुसार
- मॉडल
- स्वचालित
- उपयोग के मामले
- लेखन और सामग्री
- आपको क्या मिलेगा
- दस्तावेज़डेटा
