वीडियो ट्रांसक्रिप्शन
वीडियो ट्रांसक्रिप्शन
सामग्री की झलक
विवरण
लोकल वीडियो या ऑडियो को टाइमस्टैम्प वाले SRT उपशीर्षक (subtitles) और सादे टेक्स्ट में ट्रांसक्राइब करें, जिसमें स्थानीय प्रोसेसिंग को प्राथमिकता दी जाती है और सहमति के साथ कॉन्फ़िगर की गई रिमोट ASR सेवाओं का समर्थन किया जाता है।
संबंधित कौशल
सभी देखें लिखें
ऑडियो से ड्राफ्ट
किसी ऑडियो फ़ाइल, वॉइस नोट, बोले गए वीडियो या ट्रांसक्रिप्ट को एक सुसंगत, संपादन योग्य ड्राफ्ट में बदलें। अगर भाषण का पाठ उपलब्ध न हो, तो उसे अपने-आप ट्रांसक्राइब किया जाता है। ज़रूरत पड़ने पर यह प्रक्रिया बैकग्राउंड में जारी रहती है, इसलिए उपयोगकर्ता को इसे फिर से शुरू करने के लिए वापस आने की आवश्यकता नहीं होती।
 अनुसंधान
ऑडियो से काम और निर्णय
किसी ऑडियो फ़ाइल या ट्रांसक्रिप्ट को निर्णयों, कामों, ज़िम्मेदार लोगों, तारीखों, रुकावटों और खुले सवालों के संक्षिप्त, संपादन योग्य रिकॉर्ड में बदलें। अगर ऑडियो का टेक्स्ट उपलब्ध न हो, तो उसे अपने-आप ट्रांसक्राइब किया जाता है। ज़रूरत पड़ने पर यह प्रक्रिया बैकग्राउंड में जारी रहती है, और इसके बाद वैकल्पिक Agent कार्रवाइयों के सुझाव दिए जाते हैं।
 अनुसंधान
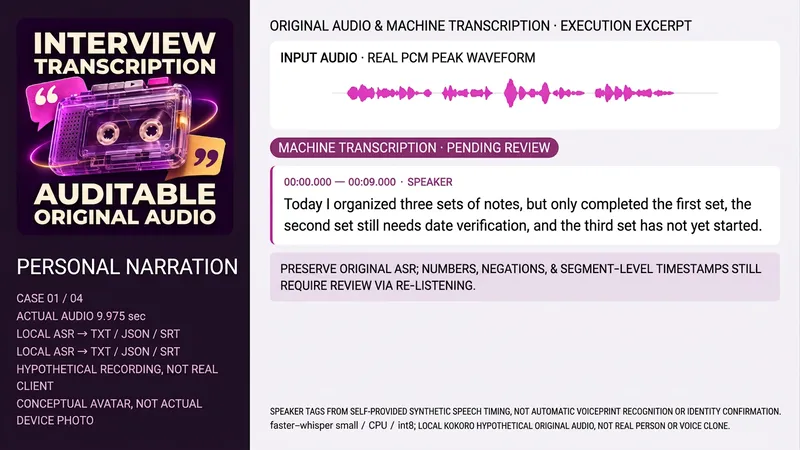
साक्षात्कार ऑडियो ट्रांसक्रिप्शन
यह उन लोगों के लिए उपयुक्त है जिन्हें अधिकृत साक्षात्कारों, मीटिंगों या कक्षा की रिकॉर्डिंग को व्यवस्थित करने की आवश्यकता है। मूल फ़ाइल, भाषा, उद्देश्य, मौजूदा verbatim या विश्वसनीय वक्ता समय मानचित्रण प्रदान करें; यह केवल आवाज के आधार पर पहचान की पुष्टि नहीं कर सकता है, और न ही स्क्रिप्ट को वास्तविक सुनी गई सामग्री के रूप में मान सकता है। मूल ध्वनि और हैश रखें -> अवधि/ट्रैक पढ़ें -> वास्तविक ASR -> वास्तविक समय क्रम के अनुसार व्यवस्थित करें -> आधार होने पर अज्ञात वक्ताओं को लेबल करें -> संख्याओं/अस्वीकरणों/नामों और संदेहों को सुनने के लिए मूल ध्वनि की जाँच करें -> TXT, JSON, SRT और कवर विवरण वितरित करें। मशीन का पहला ड्राफ्ट, सुनने और प्रूफरीडिंग तथा सारांश अलग-अलग हैं; स्पष्ट रूप से न सुने जाने वाले को समीक्षाधीन रखा जाता है, और प्रवाह के लिए शब्दों को जोड़ा नहीं जाता है। ऑडियो/ASR टूल के बिना स्पष्ट रूप से अनट्रांसक्रिप्टेड छोड़ दिया जाता है। निर्देश और पैकेज में पूर्ण मूल स्थानीय सहायक शामिल हैं: Python3, FFmpeg/FFprobe, faster-whisper और पूर्व-कॉन्फ़िगर small कैश, CPU/int8, local_files_only, स्वचालित रूप से वेट डाउनलोड नहीं करता है। विश्वसनीय speaker-map जब शुरुआत और समाप्ति तथा अज्ञात लेबल देता है तो विंडो के अनुसार वास्तविक ट्रांसक्रिप्शन करता है और समय मैप करता है; मानचित्रण न होने पर समय अज्ञात होता है। सहायक कोई स्वचालित वक्ता डायराइजेशन या पहचान नहीं करता है, पैकेज में वेट/खाता/कुंजी शामिल नहीं हैं। चार मामले स्व-निर्मित चीनी व्यक्तिगत आख्यान, चीनी दो-व्यक्ति साक्षात्कार, अंग्रेजी कक्षा विवरण और चीनी दो-व्यक्ति मीटिंग के लिए हैं, कुल मूल ध्वनि लगभग 40.875 सेकंड है। अंतिम मूल ध्वनि Apache-2.0 मॉडल कार्ड द्वारा चिह्नित Kokoro-82M निश्चित संस्करण का उपयोग करके स्थानीय रूप से संश्लेषित की जाती है, zf_xiaobei, zm_yunjian, af_heart, यह वास्तविक व्यक्ति या वॉयस क्लोनिंग नहीं है; मॉडल, आवाज या केस ऑडियो इंस्टॉलेशन पैकेज के साथ वितरित नहीं किए जाते हैं। चारों वास्तविक ASR TXT/JSON/SRT जनरेट करते हैं, वक्ता प्रदान किए गए सिंथेटिक बोलने के समय से हैं, स्वचालित वक्ता डायराइजेशन से नहीं। वर्तमान में यह अभी भी मशीन का पहला ड्राफ्ट है; दूसरे मामले का ASR आउटपुट और स्क्रिप्ट का पहला ड्राफ्ट अंतर सुनने की पुष्टि के लिए प्रतीक्षित है, और इसे बिना अनुमति के बोले गए वास्तविक शब्दों में नहीं बदला गया है। वेवफॉर्म वास्तविक इनपुट PCM पीक से हैं, न कि सजावटी ध्वनि तरंगें। पाठ संगठन के लिए GPT की सिफारिश की जाती है, ASR वास्तविक टूल पर आधारित है; स्थानीय स्तर पर OpenAI ट्रांसक्रिप्शन API को कॉल नहीं किया गया है और न ही अपस्ट्रीम CLI चलाया गया है। स्वतंत्र अवतार ImageGen वैचारिक दृश्य है, टूल ने मॉडल नहीं लौटाया है, Image2 का दावा नहीं करता है। YouMind साइड टूल, कैश, फ़ाइल डाउनलोड और मॉडल बाइंडिंग ने पॉइंट परीक्षण का उपभोग नहीं किया है; वास्तविक वातावरण के अनुसार पुष्टि करने की आवश्यकता है। ट्रांसक्रिप्शन और वक्ता संगठन स्थापना के बाद बिना निर्भरता के चलने की गारंटी नहीं देते हैं। 299 पॉइंट इंस्टॉलेशन मूल्य है, जिसमें मॉडल/API या तृतीय-पक्ष सेवाएँ शामिल नहीं हैं, यह स्वचालित रूप से खरीद नहीं करता है, और अज्ञात ऑडियो ट्रैक को अतिरिक्त सेवाओं पर चुपचाप अपलोड नहीं करता है। शून्य typos, किसी भी लहजे/शोर/मल्टी-पर्सन ओवरलैप की पूर्ण पहचान, न्यायिक/पहचान सत्यापन, समय दक्षता या व्यावसायिक प्रभाव का कोई वादा नहीं किया जाता है। स्वतंत्र सुनने और प्रूफरीडिंग को पूरक किया जाना है, verbatim सत्यापित करने का प्रचार नहीं किया जाता है।
जानकारी
- संस्करण
- v2
- आखिरी अपडेट
- रन क्रेडिट
- उपयोग के अनुसार
- मॉडल
- स्वचालित
