Texture de peau réaliste
Des prompts pour une peau naturelle
Texture de peau réaliste
Des prompts pour une peau naturelle
Aperçu
Description
Générez des prompts de génération d’images de personnes pour selfies, gros plans, portraits en buste et séances photo, en réduisant l’aspect plastique, le film gras et le visage artificiel des images générées par IA. La peau gagne ainsi un éclat, une texture et de légères variations plus naturels. Qu’il s’agisse d’un portrait du quotidien, d’un portrait au style magazine, d’un instantané au flash direct ou d’un portrait réaliste avec moins d’aspect artificiel, les prompts peuvent être personnalisés selon le sujet, le point de vue, la lumière, le style et les imperfections souhaitées. Les prompts sont structurés autour de l’aspect général de la peau, de la position des zones de lumière, des différences entre les régions du visage, des textures comme les pores et le duvet, ainsi que des variations naturelles du teint, plutôt que de simplement empiler des termes vagues comme « peau réaliste » ou « hyperréalisme ». Vous pouvez préciser des formats d’image comme 9:16, 3:4 ou 1:1 et obtenir des recommandations de composition et de paramètres adaptées au modèle de génération utilisé. Si nécessaire, des versions en chinois, en anglais ou bilingues peuvent être générées pour GPT-Image, 即梦, 豆包, Midjourney, SDXL ou Flux. En plus des prompts positifs prêts à copier, l’outil explique comment les principales descriptions influencent la texture de la peau et fournit des conseils ciblés pour diagnostiquer et ajuster les problèmes de peau trop lissée, de brillance excessive sur tout le visage, d’effet cireux ou de texture déformée. Les prompts générés peuvent également être enregistrés par thème afin de les retrouver et de les peaufiner facilement, tout en conservant une texture cohérente dans une série de portraits.
Recommandé par
淡苍
Pourquoi nous recommandons cette compétence
Décompose la texture de la peau en cinq leviers pour corriger précisément l’aspect plastique, le film gras et le visage artificiel, avec des prompts bilingues copiables et traçables.
Idéal pour
Pour les créateurs de contenu, passionnés de photographie et utilisateurs de génération d’images qui veulent des portraits naturels et réalistes.
Comment utiliser ce Skill
Fournir les éléments
Indiquez le sujet, le point de vue, la lumière, le style, les imperfections souhaitées et le format de l’image. Vous pouvez aussi préciser le modèle de génération ou la langue souhaitée.
Lancer le Skill
Organise la texture, la répartition de la lumière, les différences entre les zones, les détails de texture et les variations naturelles, puis adapte le prompt à la scène.
Vérifier le résultat
Obtenez des prompts de génération d’images de personnes prêts à copier, ainsi que des contraintes négatives, une analyse descriptive et des conseils pour résoudre les problèmes de texture.
Compétences associées
Tout voir Image
Prompts de portraits asiatiques
Cette compétence est conçue pour les utilisateurs qui souhaitent créer des prompts de haute qualité pour des plateformes de génération d’images par IA, en particulier les créateurs et designers à la recherche d’une esthétique asiatique et de représentations féminines adultes, naturelles et matures. Elle transforme vos idées créatives en prompts concrets et exploitables, afin de garantir l’esthétique des images générées et leur compatibilité avec les plateformes. Ses fonctionnalités principales incluent la génération, à partir de vos descriptions, de prompts adaptés à de nombreux modèles d’images IA courants, comme Midjourney, SDXL, Flux, GPT Image, 豆包, 即梦 et ComfyUI. Elle identifie et reformule intelligemment les termes à risque afin de garantir la conformité du contenu avec les règles de sécurité des plateformes et d’éviter les expressions infantilisantes, vulgaires ou mettant excessivement l’accent sur certaines parties du corps. Vous pouvez également utiliser des commandes rapides pour passer d’un style d’image à un autre, comme le selfie réaliste, la photo de mode éditoriale, le cosplay haut de gamme, le cyberpunk ou le style classique d’inspiration chinoise. La compétence prend aussi en charge la correction des prompts à partir des retours obtenus après un échec de génération. Que vous souhaitiez créer une couverture de magazine de mode, un portrait à l’esthétique cinématographique ou le design d’un personnage en 3D CG, cet outil fournit des descriptions précises et des suggestions de paramètres. Les prompts finaux sont optimisés selon la plateforme sélectionnée : phrases longues et naturelles en anglais pour Midjourney, groupes clairs de mots-clés positifs et négatifs pour SDXL/Flux, ou emplacements de paramètres détaillés et modulaires pour ComfyUI. Vous pouvez ainsi générer plus efficacement des portraits IA conformes à vos attentes.
 Image
Personnages IA précis
Transformez l’image d’un personnage que vous avez en tête en prompts prêts à l’emploi et en image finale. Partez d’une simple description de départ ou d’une idée de thème, puis précisez progressivement les éléments clés : coiffure, accessoires de cheveux, tenue, expression, posture, cadrage, lumière, ombres et décor. Qu’il s’agisse d’une femme en costume traditionnel chinois, d’une fille cyberpunk, d’un personnage de style japonais, d’un portrait réaliste ou d’un personnage personnalisé, obtenez une direction visuelle cohérente avec l’atmosphère souhaitée. Choisissez la génération rapide pour laisser l’IA compléter automatiquement les caractéristiques du personnage, ou optez pour un contrôle détaillé afin d’ajuster chaque élément en le sélectionnant ou en le personnalisant. Le résultat comprend des prompts structurés bilingues chinois-anglais ainsi qu’un Negative Prompt adapté au style visuel, pour faciliter leur compréhension et leur réutilisation avec des modèles courants comme FLUX, Midjourney et SDXL. L’image du personnage est également générée par l’IA. Après la génération, continuez à affiner le résultat par dimension : changez la coiffure, l’expression, la posture, l’angle de prise de vue, la lumière, le décor ou le style visuel, puis régénérez l’image en conservant les autres paramètres. Les modifications apportées sont clairement indiquées. Idéal pour la conception de personnages, les concepts de personnages, la création d’avatars, la préparation d’illustrations et l’exploration de directions visuelles.
 Image
Prompts mode street au flash
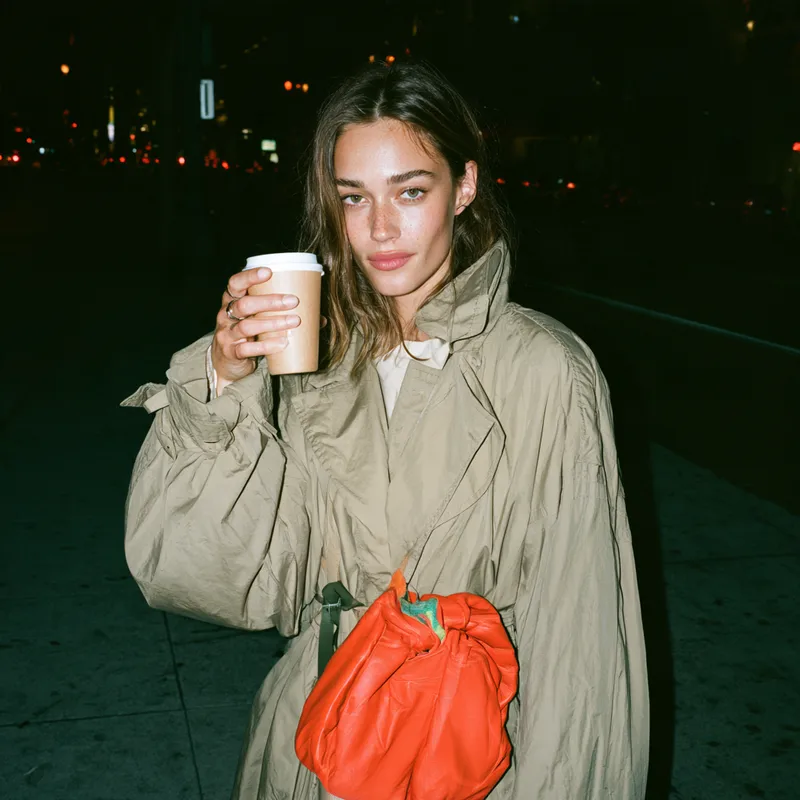
Génère des prompts d’image pour la mode street, les sacs, les chaussures et autres accessoires, avec un rendu pris sur le vif au flash direct et en gros plan. Les produits restent nets et bien visibles, tout en conservant des poses décontractées et l’atmosphère d’une capture instantanée dans un véritable environnement urbain. Idéal pour les visuels de marque, les contenus destinés aux réseaux sociaux et la génération préliminaire de concepts de mode et d’accessoires, sans donner à l’image l’apparence rigide et trop posée d’une séance en studio ni celle d’une campagne publicitaire excessivement retouchée. Vous pouvez fournir un produit seul, une tenue portée par une personne ou une situation d’utilisation précise, puis indiquer les couleurs, les matières, la quantité, la façon de porter les éléments et le format souhaité. Le skill compose l’image autour d’un flash frontal rapproché, de projections courtes et nettes, d’une exposition ambiante plus sombre mais lisible, ainsi que de décors urbains gris neutre, blancs ou bleu foncé. Il ajuste aussi la composition selon que l’objet est porté à la main, en bandoulière ou posé sur une table, afin de mieux distinguer le volume du sac, les anses, les semelles et la structure des vêtements. Par défaut, il fournit des concepts visuels indépendants en 16:9 ainsi que des prompts directement utilisables dans Midjourney et ImageGen en chinois. Si vous ne souhaitez qu’un seul format, il peut aussi le générer sur demande. Pour les séries de plusieurs images, il peut conserver les caractéristiques du produit et le style visuel tout en changeant les scènes et les poses, ce qui convient à la création d’une série cohérente d’images de mode street.
Informations
- Version
- v6
- Dernière mise à jour
- Crédits par exécution
- Selon l’utilisation
- Modèles
- Automatique
- Cas d’usage
- Images et design
- Ce que vous obtenez
- Prompt